Agent World Model in the Wild (arXiv:2610.26828): Sintesis Lingkungan Komputer Multimodal GUI-MCP-CLI, 5 Quality Gates Eksekusi, dan Penguatan Generalisasi CUA
Analisis arsitektur riset frontier arXiv:2610.26828 (Zhaoyang Wang, Huaxiu Yao et al., MSR Orchard & Stanford): Bagaimana melatih Computer-Use Agent (CUA) tanpa risiko merusak sistem operasi produksi dan tanpa ketergantungan pada data interaksi manusia? Memperkenalkan WildAWM (Agent World Model in the Wild), framework sintesis lingkungan komputer otonom pertama yang menggabungkan antarmuka GUI, Model Context Protocol (MCP), dan CLI terminal. Dengan pipeline persona multi-hari, 5 quality gates berbasis rollouts heterogen (termasuk Hermes Agent & OpenCode), serta probing counterfactual anti-sycophancy, WildAWM menghasilkan 341 task long-horizon dengan verifier deterministik. Model open-weight Qwen3.6-35B-A3B yang dilatih via GRPO di dunia sintetis ini melesat +10.58% melintasi 8 benchmark OOD (OSWorld, WebArena, ClawEval). Bedah arsitektur lengkap, formulasi reward dense, dan implementasi TypeScript produksi.
Executive Summary: Paradigma Baru Sintesis Lingkungan Interaktif untuk Autonomous Agent
Melatih Computer-Use Agents (CUA) di lingkungan sistem operasi nyata selama ini terbentur oleh dua dilema besar: keamanan operasional (risiko penghapusan data produksi, kebocoran kredensial, dan interaksi destruktif) serta kelangkaan data interaksi manusia berskala besar. Paper frontier terbaru arXiv:2610.26828 berjudul "Agent World Model in the Wild: Computer-Use Agent Environment Synthesis" (Zhaoyang Wang, Huaxiu Yao et al., Microsoft Research Orchard & Stanford) menghadirkan terobosan radikal: WildAWM.
WildAWM adalah pipeline pertama yang 100% ditenagai model open-source untuk mensintesis lingkungan komputer operasional lengkap—mengintegrasikan Graphical User Interface (GUI), layanan berbasis Model Context Protocol (MCP), dan antarmuka Command-Line Interface (CLI). Melalui 5 quality gates berbasis eksekusi dan validasi rollouts lintas-harness (termasuk Hermes Agent dan OpenCode), WildAWM menghasilkan 341 task long-horizon (>100 steps) yang bahkan hanya diselesaikan 60% oleh model proprietary frontier seperti GPT-6-Astra. Pelatihan Qwen3.6-35B-A3B menggunakan GRPO di dunia sintetis ini menghasilkan lompatan performa out-of-distribution (OOD) sebesar +10.58% melintasi 8 benchmark utama.
1. Mengapa Melatih Agen di Lingkungan Komputer Nyata Sangat Berbahaya dan Mahal?
Pergeseran fundamental dalam riset agen cerdas adalah transisi dari learning from human demonstrations menuju learning through environmental interaction via Reinforcement Learning (RL). Namun, mengeksekusi eksplorasi RL acak langsung di dalam sistem operasi desktop nyata memunculkan hambatan kritis:
Eksplorasi RL tak terkendali pada OS live berisiko memformat partisi disk, mengirim email phishing ke kontak riil, merusak database produksi, dan men-trigger rate-limiting API publik.
Benchmark eksisting hanya mengisolasi satu antarmuka: WebArena hanya menguji DOM web browser, OSWorld dominan visual GUI, dan SWE-bench hanya CLI. Padahal alur kerja insinyur nyata selalu menyilangkan GUI, API backend (MCP), dan terminal.
Sebagian besar benchmark sintetis mengandalkan LLM judge untuk menilai teks jawaban agen. Saat agen memberikan argumen manipulatif, evaluator berbasis LLM mudah terjebak bias persetujuan (sycophancy) dan reward tampering.
2. Arsitektur WildAWM: World Synthesis Melalui Persona & Multi-Day Planning
WildAWM mendefinisikan sebuah World sebagai akumulasi state komputer personal yang mencakup aplikasi web mirror (15 mirror interaktif dari WebHarbor), server dan service yang dapat diakses via Model Context Protocol (MCP), serta file lokal yang mencerminkan riwayat aktivitas seorang pengguna.
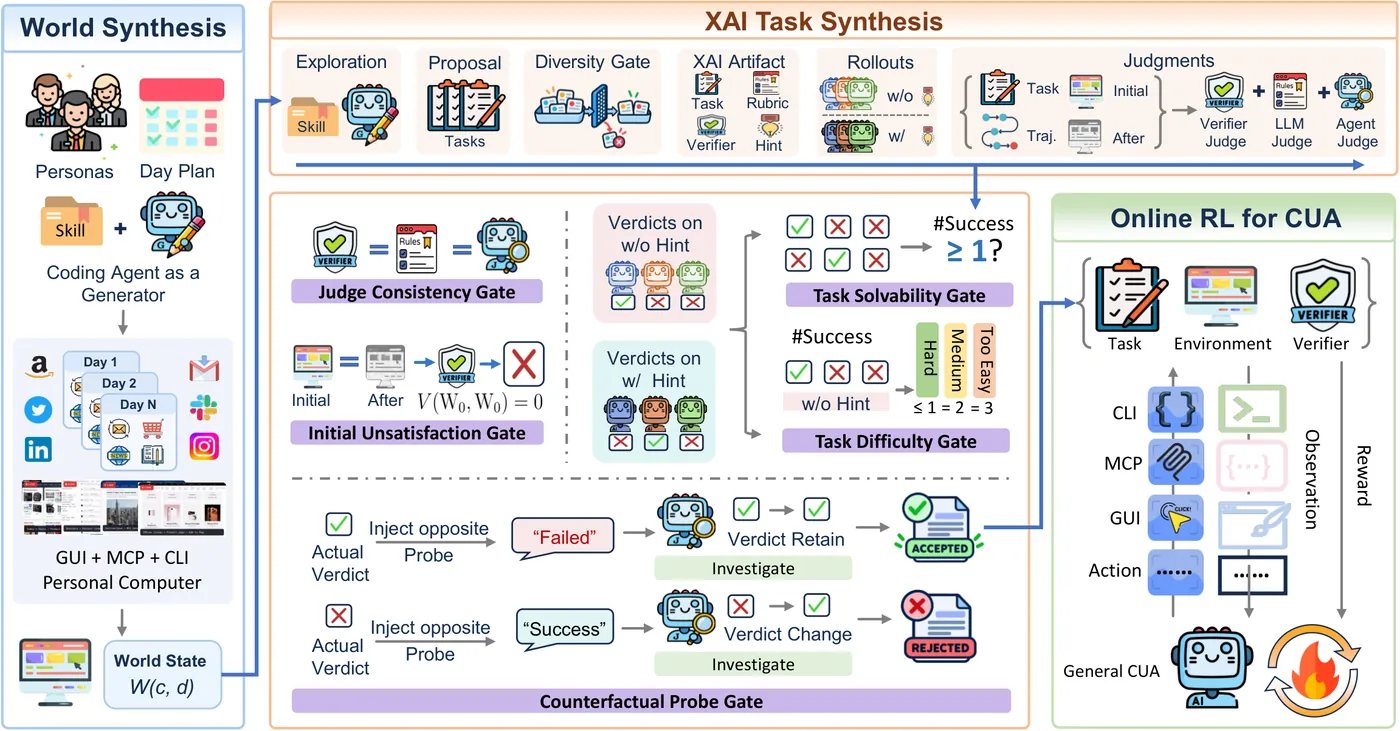 Gambar 1: Pipeline komprehensif WildAWM (arXiv:2610.26828) — Dimulai dari Persona & Day Planning, Skill-Enhanced Generation, 5 Quality Gates berbasis Rollout Heterogen, hingga General CUA Training via GRPO.
Secara formal, akumulasi state lingkungan untuk persona c setelah hari d dinotasikan sebagai W(c, d). Proses ini dibangun dalam tiga tahap berkesinambungan:
-
Persona and Day Planning:
Menggunakan model open-source GLM-5.2 di dalam harness OpenCode, generator menciptakan profil persona realistis yang mencakup profesi, daftar kontak, riwayat browser, dan alur kegiatan multi-hari. Setiap hari berikutnya dirancang dengan menginspeksi state hari sebelumnya
W(c, d - 1)untuk menjaga kontinuitas digital. - Skill-Enhanced Generation: Alih-alih membuat program ad-hoc, generator memanfaatkan library event skills yang reusable. Setiap skill memetakan antarmuka yang terlibat, perubahan state yang harus dihasilkan pada database SQLite/Postgres dan file lokal, serta batasan konsistensi data. Generator menulis skrip deterministik yang dapat di-replay ulang untuk memvalidasi idempotensi state.
- Cross-Agent Interface (XAI) Task Formulation: Task yang di-generate wajib memenuhi kualifikasi XAI: agen tidak dapat menyelesaikan task hanya dengan satu moda. Agen harus membaca petunjuk di GUI/browser, memanggil fungsionalitas backend melalui tool MCP, dan mengeksekusi transformasi data via CLI terminal.
3. Lima Quality Gates: Eliminasi Task Rusak dan Uji Ketahanan Counterfactual
Kelemahan terbesar dataset sintetis adalah tingginya angka task yang mustahil diselesaikan (unsolvable) atau verifier yang meloloskan agen bodoh (false positives). WildAWM mengatasi hal ini dengan menerapkan 5 Execution-Based Quality Gates yang menguji 6 rollouts nyata dari 18 kombinasi model dan harness:
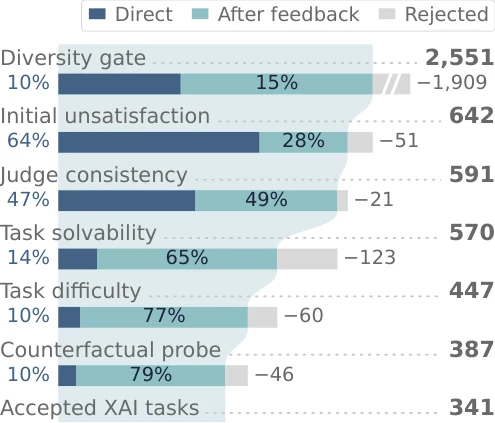 Gambar 2: Alur eliminasi kandidat task melalui 5 Quality Gates eksekusi deterministik pada WildAWM.
Gate 1: Judge Consistency
Mengharuskan konsistensi mutlak antara verifier terprogram V, semantic LLM judge, dan agent judge yang aktif menginspeksi file sistem. Jika ketiga evaluator tidak sepakat pada seluruh 6 rollouts, task dikembalikan ke generator untuk perbaikan rubrik dan skrip verifier.
Gate 2: Initial Unsatisfaction
Memastikan V(W0, W0, ∅) = 0. Mencegah task yang kondisi akhirnya sudah terpenuhi secara kebetulan pada state awal tanpa adanya tindakan dari agen.
Gate 3: Task Solvability & Multi-Interface Coverage
Menolak task yang gagal diselesaikan oleh seluruh 6 rollout agen (membuktikan task dapat diselesaikan). Trajektori yang sukses juga diverifikasi wajib memanggil ketiga moda antarmuka: GUI, MCP, dan CLI.
Gate 4: Task Difficulty Calibration
Mengukur tingkat kesulitan empiris tanpa petunjuk (hints). Task di mana 3 dari 3 rollout tanpa hint berhasil dengan mudah diklasifikasikan sebagai too easy dan dikembalikan untuk dinaikkan kompleksitas kondisinya.
Gate 5: Counterfactual Probing (Anti-Sycophancy)
Uji ketahanan paling inovatif pada WildAWM. Ketika rollout terbukti valid, evaluator disodori klaim palsu bahwa tugas tersebut gagal: 1 - V. Jika agent judge goyah dan menyetujui klaim salah tersebut (menunjukkan sifat sycophant), kandidat task digugurkan karena verifier tidak memiliki ketahanan audit objektif.
4. Formulasi Reward Dense GRPO: Menghubungkan Checklist Atomik dengan Keberhasilan Akhir
Tantangan utama pelatihan Reinforcement Learning pada task long-horizon (>100 langkah aksi) adalah kelangkaan sinyal reward (sparse reward problem). Jika reward hanya diberikan di akhir berupa nilai biner (1 atau 0), gradien optimasi model kecil akan kolaps karena sebagian besar rollout menghasilkan reward nol.
WildAWM mengatasi ini dengan merumuskan fungsi reward GRPO berbasis checklist parsial yang tetap outcome-based:
Di mana N adalah jumlah kriteria checklist, dan v_i ∈ {0, 1} adalah evaluasi tiap sub-kriteria. Jika format tool call salah (misal format JSON invalid pada panggilan MCP), agen langsung menerima penalti r_j = -1 dan pemotongan trajektori seketika. Hal ini memberi sinyal pembelajaran dense bahkan sebelum agen berhasil menuntaskan seluruh rantai pekerjaan.
5. Hasil Benchmark: Lompatan Generalisasi Out-of-Distribution (OOD)
Model yang dilatih secara eksklusif pada 341 dunia sintetis WildAWM dievaluasi melintasi 8 benchmark eksternal OOD yang mencakup tiga domain agen: Web Agent (Online-Mind2Web, WebArena), Claw Agent (QwenClawBench, ClawEval), dan Computer-Use Agent (CUA-Gym, OSWorld-Verified, OSWorld 2.0, Agents' Last Exam).
| Model | Harness | O2W (Web) | WA (Web) | QCB (Claw) | CLE (Claw) | OS-2 (OS) | ALE (Exam) | Rata-rata OOD |
|---|---|---|---|---|---|---|---|---|
| GPT-6-Astra (Proprietary) | OpenCode | 92.78% | 74.34% | 65.21% | 80.33% | 60.77% | 56.58% | 73.11% |
| Claude Opus 5 (Proprietary) | OpenCode | 96.60% | 75.66% | 55.02% | 77.67% | 52.79% | 49.85% | 70.83% |
| GLM-5.2 (Open-Weight) | OpenCode | 86.67% | 67.26% | 64.44% | 59.67% | 45.00% | 41.39% | 63.21% |
| Qwen3.6-35B-A3B (Base) | OpenCode | 69.60% | 53.54% | 57.86% | 38.00% | 13.22% | 23.57% | 42.84% |
| Qwen3.6-35B + WildAWM (Ours) | OpenCode | 80.77% | 67.26% | 61.44% | 54.67% | 21.73% | 26.31% | 53.42% (+10.58%) |
| Qwen3.5-4B (Base) | OpenCode | 26.39% | 30.09% | 44.06% | 26.67% | 0.87% | 7.00% | 21.83% |
| Qwen3.5-4B + WildAWM (Ours) | OpenCode | 45.65% | 39.82% | 48.37% | 36.67% | 1.03% | 8.96% | 30.04% (+8.21%) |
Pencapaian di atas membuktikan bahwa melatih model pada lingkungan sintetis multimodal yang kaya (GUI, MCP, CLI) mentransfer generalisasi yang kuat ke skenario tugas dunia nyata yang belum pernah dilihat sebelumnya. Model 35B yang dilatih di WildAWM bahkan mengungguli baseline spesialis seperti CUA-Gym dan OpenForgeRL.
6. Implementasi Referensi: WildAWM Environment Engine & Multi-Gate Verifier
Berikut adalah modul TypeScript implementasi engine verifikasi dan reward calculator WildAWM yang dapat langsung diaplikasikan ke dalam orchestrator agen, simulasi sandbox Docker, atau pipeline evaluasi otomatis:
${WILDAWM_CODE_SNIPPET}7. Panduan Praktis untuk AI Engineer dan Arsitek Sistem di 2026
- Hindari Evaluasi Agen Single-Interface: Menguji agen hanya di terminal (CLI) atau hanya di DOM browser akan menciptakan bias kemampuan yang rapuh. Arsitektur produksi modern wajib menggabungkan eksekusi terminal, tool calling MCP, dan visual inspeksi GUI.
- Wajib Menggunakan Counterfactual Probing pada Evaluator: Jangan pernah mempercayai LLM judge tanpa uji provokasi. Jika evaluator Anda membatalkan penilaian benarnya hanya karena diberi klaim palsu, evaluator tersebut rentan terhadap eksploitasi adversarial dan halusinasi.
- Gunakan Dense Partial Credit untuk RL Long-Horizon: Bagi task besar ke dalam checklist kriteria independen. Memberikan reward parsial terarah menjaga kestabilan variance grup pada algoritma seperti GRPO atau PPO.
-
Isolasi Eksplorasi dalam Sandbox Snapshot Deterministik:
Gunakan snapshot filesystem dan database yang dapat di-reset secara instan ke state
W(c, d)sehingga ribuan rollout agen dapat berjalan paralel tanpa mengorbankan integritas data.
Referensi & Sumber Terverifikasi
- [1]Agent World Model in the Wild: Computer-Use Agent Environment Synthesis(arXiv:2610.26828 [cs.AI, cs.SE] — Zhaoyang Wang, Qianhui Wu, Haorui Wang, Huaxiu Yao et al. (MSR Orchard, Stanford, Penn State))
- [2]CUA-Gym: Scaling Verifiable Training Environments for Computer-Use Agents(arXiv:2601.08742 — Wang et al.)
- [3]OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Operating Systems(NeurIPS 2024 / arXiv:2404.07972 — Tianbao Xie et al.)
- [4]OSWorld 2.0: Scaling Long-Horizon Multimodal Computer Interaction(arXiv:2603.11290 — Yuan et al.)
- [5]WebArena: A Realistic Web Environment for Building Autonomous Agents(ICLR 2024 / arXiv:2307.13854 — Shuyan Zhou et al. (CMU))
- [6]OpenCode & Hermes Agent: Open Autonomous Coding & Claw Architectures(GitHub & Nous Research Technical Releases)
- [7]Agent World Model in the Wild: Computer-Use Agent Environment Synthesis(arXiv:2610.26828 [cs.AI, cs.SE] — Zhaoyang Wang, Qianhui Wu, Haorui Wang, Huaxiu Yao et al. (MSR Orchard, Stanford, Penn State))
- [8]CUA-Gym: Scaling Verifiable Training Environments for Computer-Use Agents(arXiv:2601.08742 — Wang et al.)
- [9]OSWorld: Benchmarking Multimodal Agents for Open-Ended Tasks in Operating Systems(NeurIPS 2024 / arXiv:2404.07972 — Tianbao Xie et al.)
- [10]OSWorld 2.0: Scaling Long-Horizon Multimodal Computer Interaction(arXiv:2603.11290 — Yuan et al.)
- [11]WebArena: A Realistic Web Environment for Building Autonomous Agents(ICLR 2024 / arXiv:2307.13854 — Shuyan Zhou et al. (CMU))
- [12]OpenCode & Hermes Agent: Open Autonomous Coding & Claw Architectures(GitHub & Nous Research Technical Releases)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.
DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.
Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.