Cache Engineering for Agents (arXiv:2610.28577): Arsitektur AKV Serving Engine, Kontrol Aktif KV Cache, Extended Radix Tree, dan Segment-Batch Attention Tanpa Re-Prefill Overhead
Analisis arsitektur sistemik riset frontier AI engineering (arXiv:2610.28577, Tianyu Fu et al. — Tsinghua University & CUHK, Oktober 2026): Mengapa teknik context engineering konvensional (summarization dan history trimming) memicu re-prefill penalty yang melipatgandakan cost dan melambatkan wall-clock latency pada agen LLM long-horizon? Cache engineering memindahkan kontrol KV cache langsung ke tangan agen melalui tiga operasi formal: append(x), drop(P), dan repos(q, p) dengan RoPE key rotation tanpa memodifikasi teks trajektori. Melalui co-design AKV Serving Engine dengan Extended Radix Tree dan Segment-Batch Attention, sistem mencapai restorasi state dalam 1 forward pass, memangkas biaya inferensi 27.7%, meningkatkan throughput 1.53x, dan mempercepat P95 latency 1.51x pada SWE-bench Verified dan GAIA.
Dalam lanskap rekayasa sistem agen otonom (autonomous AI agents), tantangan terbesar saat mengeksekusi trajektori multi-round berdurasi panjang (long-horizon tasks) bukanlah sekadar keterbatasan memori konteks, melainkan re-prefill penalty yang menghancurkan efisiensi latensi dan biaya komputasi. Makalah riset terbaru dari Tsinghua University dan CUHK (arXiv:2610.28577, Fu et al., Oktober 2026) memperkenalkan paradigma baru: Cache Engineering for Agents bersama arsitektur serving engine AKV. Berbeda secara fundamental dengan context engineering konvensional yang memanipulasi teks prompt (trimming atau summarization), cache engineering memberikan hak kontrol langsung kepada agen atas status KV cache aktifnya tanpa menyentuh teks trajektori dan tanpa perlu melakukan re-prefilling ulang yang mahal.
Executive Architectural Summary
Dilema Re-Prefill: Mengedit prefix teks pada konteks interaction membatalkan seluruh KV cache di hilir, memicu re-prefill berulang dengan penalti biaya komputasi hingga 1.85x lipat dan degradasi akurasi 5-7 poin persentase pada summarization berbasis ambang batas.
Solusi Cache Engineering: Memformalisasi 3 primitif operasi KV deterministik: append(x), drop(P), dan repos(q, p). Agen secara proaktif membuang KV tool-response yang usang sembari mempertahankan KV reasoning chains dan melakukan rotasi embedding posisi RoPE tanpa aktivasi bobot model.
AKV Serving Engine: Sistem serving stateless interface, stateful serving pertama yang memecahkan masalah history dependence melalui Extended Radix Tree (dengan Drop Nodes & Reposition Nodes) serta Segment-Batch Attention yang mengeksekusi restorasi status multi-segmen dalam satu forward pass model tunggal tanpa redundansi pembacaan bobot FFN.
Hasil Empiris (SWE-bench Verified & GAIA): Menghemat rata-rata biaya inferensi sebesar 27.7%, mendongkrak skor benchmark rata-rata +1.7 poin, meningkatkan throughput output 1.18x-1.20x, throughput input 1.53x, dan mempercepat P95 request latency hingga 1.51x. Kebijakan Recursive Self-Improvement (RSI) agen memangkas biaya tambahan 7.1% di atas desain pakar manusia.
1. Dilema Re-Prefill: Mengapa Context Engineering Menjadi Bottleneck pada Skala Produksi
Hingga saat ini, pendekatan baku dalam mengatasi ledakan token pada LLM agent didominasi oleh context engineering pada level teks. Ketika trajektori observasi dan aksi alat (tool executions) melampaui context window atau membengkakkan biaya token input, sistem rekayasa prompt biasanya menempuh salah satu dari dua jalur:
-
1. Trimming / Sliding Window History: Memotong baris-baris respons alat awal secara sekuensial. Masalah mendasarnya: memotong teks di awal trajektori membatalkan token prefix pada mesin inferensi modern (seperti RadixAttention pada vLLM atau SGLang). Akibatnya, seluruh sisa teks yang dipertahankan harus di-prefill ulang (re-prefill) dari token ke-0 pada setiap turn baru. Pada pengujian 100 task benchmark BCP (Benchmark for Coding & Problem-solving), pendekatan trimming 12 round terakhir justru memicu biaya 1.85x lebih mahal daripada membiarkan full context!
-
2. Threshold-Triggered Summarization: Ketika token mencapai ambang tertentu (misal 48k atau 96k token), sistem memanggil model untuk merangkum riwayat lama. Selain menambah latency dan biaya komputasi untuk menghasilkan ringkasan, kompresi informasi ini bersifat lossy: bukti mentah kode atau konfigurasi penting hilang, menurunkan akurasi task rata-rata sebesar 5 poin persentase pada model GPT-OSS-120B.
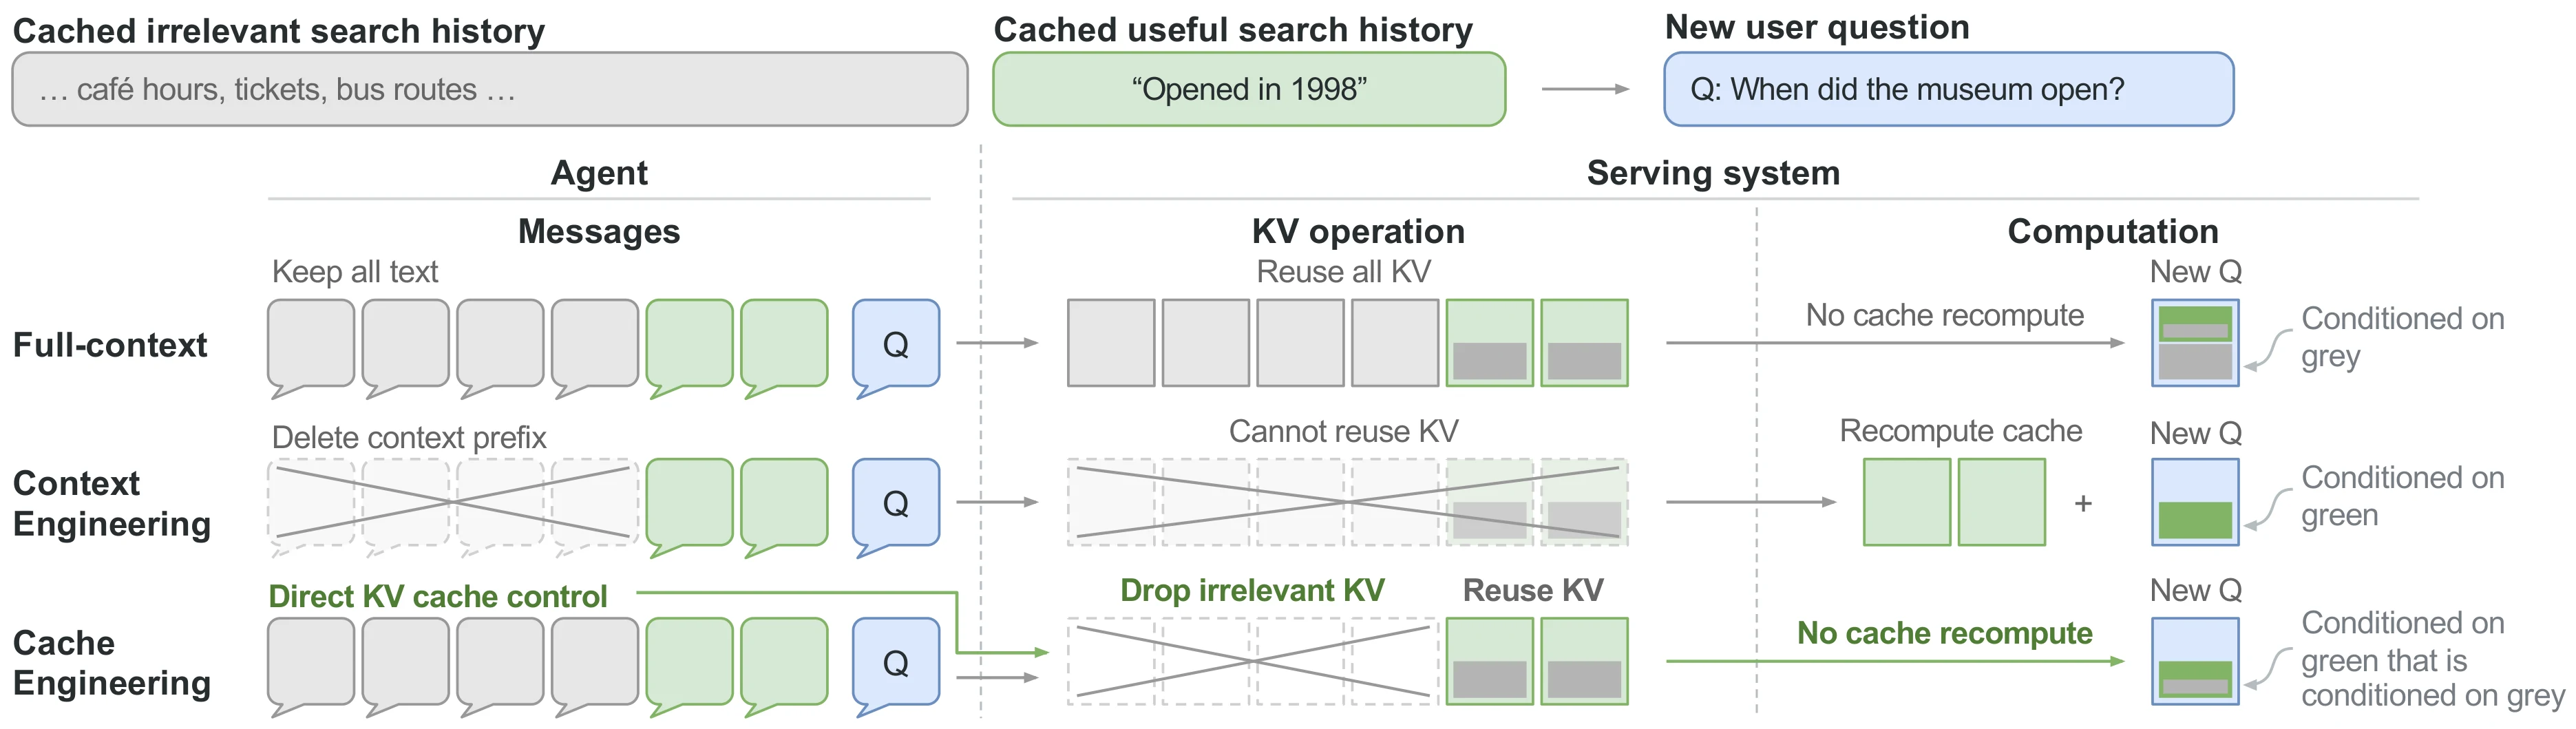 Gambar 1: Perbandingan fundamental antara Full-Context Inference, Context Engineering (trimming/summarization teks yang memicu re-prefilling ulang), dan Cache Engineering (AKV) yang memanipulasi KV state secara langsung tanpa mengubah teks trajektori logis (Fu et al., arXiv:2610.28577).
Paradigma Cache Engineering memutus dilema ini secara radikal. Alih-alih mengubah sekuens token logis (x_{1:t}), agen secara eksplisit menginstruksikan server inferensi untuk memodifikasi active KV cache (mathcal{C}) yang terlihat oleh mekanisme attention masa depan. Sekuens teks riwayat obrolan tetap utuh dan lengkap, namun alokasi memori fisik dan matriks atensi hanya memproses cache yang relevan.
2. Formalisasi Matematis: Tiga Primitif Operasi Cache dan Fenomena History Dependence
Secara formal, model autoregresif memprediksi token berikutnya berdasarkan token terkini (x_t) dan status KV cache sebelumnya (mathcal{C}_{1:t-1}):
Dalam cache engineering, ukuran active cache (mathcal{C}) tidak lagi harus sama dengan panjang sekuens logis (t). Tim peneliti memformulasikan tiga operasi dasar yang membentuk urutan operasi cache (cache operation sequence) (o_{1:m}):
Operasi standar inferensi autoregresif. Menghitung status KV untuk token baru (x_{t+1}) yang dikondisikan pada active cache dan menambahkannya ke memori:
mathcal{C} leftarrow [mathcal{C}; C_{t+1}]
Mengeluarkan entri KV posisi (P) dari jangkauan attention masa depan tanpa mengubah status KV yang tersisa, tanpa mengubah encoding posisinya, dan tanpa menyentuh teks logis:
mathcal{C} leftarrow mathcal{C} setminus {C_i : i in P}
Memperbarui positional encoding dari key yang dipertahankan dalam urutan logis baru, dan mereset indeks posisi untuk append berikutnya. Untuk Rotary Position Embedding (RoPE):
K leftarrow R(q)R(p)^{-1}K
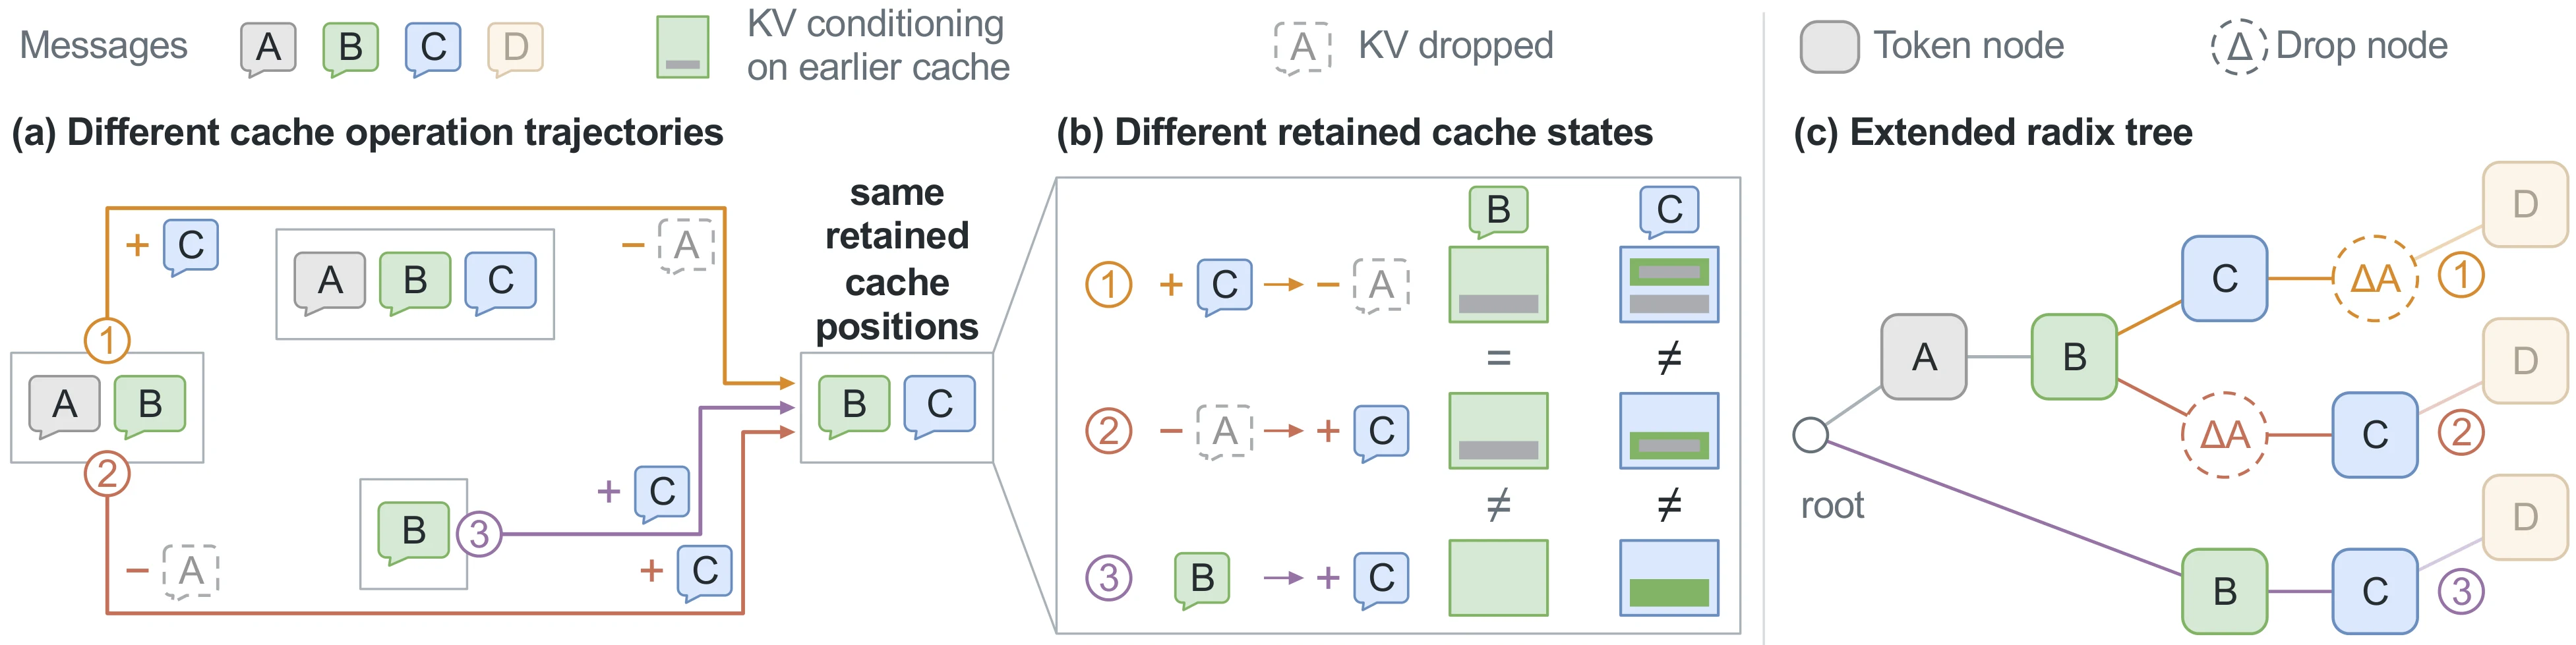 Gambar 2: Mengapa prefix matching biasa gagal: Ilustrasi tiga trajektori berbeda dengan sekuens token akhir yang identik (B dan C). Karena urutan append dan drop berbeda, status komputasi KV untuk C saling berlainan pada setiap trajektori (Fu et al., arXiv:2610.28577).
Hambatan Krusial: Tantangan History-Dependence
Mengapa sistem serving cache konvensional seperti vLLM atau SGLang tidak bisa langsung menerapkan drop dan repos? Jawabannya terletak pada sifat history-dependence. Perhatikan Gambar 2:
- Trajektori ①: Menghitung A dan B, lalu melakukan
append(C)(di mana C memperhatikan A dan B), baru kemudian mengeksekusidrop(A). - Trajektori ②: Menghitung A dan B, mengeksekusi
drop(A), baru kemudian melakukanappend(C)(C hanya memperhatikan B tanpa pernah melihat A). - Trajektori ③: Dimulai langsung dari B tanpa konteks A, lalu
append(C).
Ketiga trajektori di atas sama-sama memiliki token aktif B dan C pada akhirnya. Namun status representasi tersembunyi (KV state) token C pada ketiga skenario tersebut berbeda total! Jika serving engine hanya mencocokkan prefix teks string, server akan keliru meminjamkan cache C dari trajektori ① untuk melayani kueri trajektori ②, merusak distribusi probabilitas generasi teks.
3. Arsitektur AKV Serving System: Stateless Interface, Stateful Serving
Untuk mengatasi masalah di atas, para peneliti merancang AKV (Agent KV), sistem serving inference engine pertama yang didesain secara khusus untuk mengeksekusi cache engineering dengan mematuhi prinsip stateless interface, stateful serving.
3.1 Antarmuka Stateless yang Kompatibel Penuh
Agen tidak dibebani kewajiban melacak apakah physical page KV masih bertengger di VRAM GPU server. Klien cukup mengirim pesan standar OpenAI chat completions dengan ekstensi field cache yang menggunakan tata bahasa operate-after:
{
  "model": "gpt-oss-120b",
  "messages": [
    { "role": "user", "content": "Investigate memory leak in cluster" },     // m0 -> append(m0)
    { "role": "assistant", "content": "Running diagnostic probes..." },      // m1 -> append(m1)
    { "role": "tool", "content": "[Kernel dump 12MB raw hex output...]" },  // m2 -> append(m2)
    { "role": "assistant", "content": "Hex analyzed. Isolating pod..." },    // m3 -> append(m3)
    { "role": "tool", "content": "[Pod netstat trace 48KB...]" }             // m4 -> append(m4)
  ],
  "cache": {
    "drop": {
      "3": [2] // Setelah m3 dihitung, drop raw observation m2 dari attention masa depan
    },
    "reposition": [3] // Kompaksi indeks posisi RoPE setelah m3
  }
}
3.2 Extended Radix Tree dengan Drop Nodes & Reposition Nodes
AKV memperluas struktur data Radix Tree standar dengan menyematkan node operasi khusus:
-
Drop Nodes ((Delta)): Ditempatkan persis pada trigger point operasi drop. Menyimpan metadata indeks logis yang dikeluarkan dari kalkulasi attention. Dengan cara ini, trajektori yang membuang cache pada titik waktu berbeda akan bercabang secara alami di dalam tree, menjamin isolasi dan validitas cache reuse.
-
Reposition Nodes ((R)): Menandai titik di mana key diputar menggunakan matriks rotasi RoPE (R(q)R(p)^{-1}). Node ini membedakan cache yang memiliki konten token sama namun menggunakan rentang posisi encoding yang berbeda.
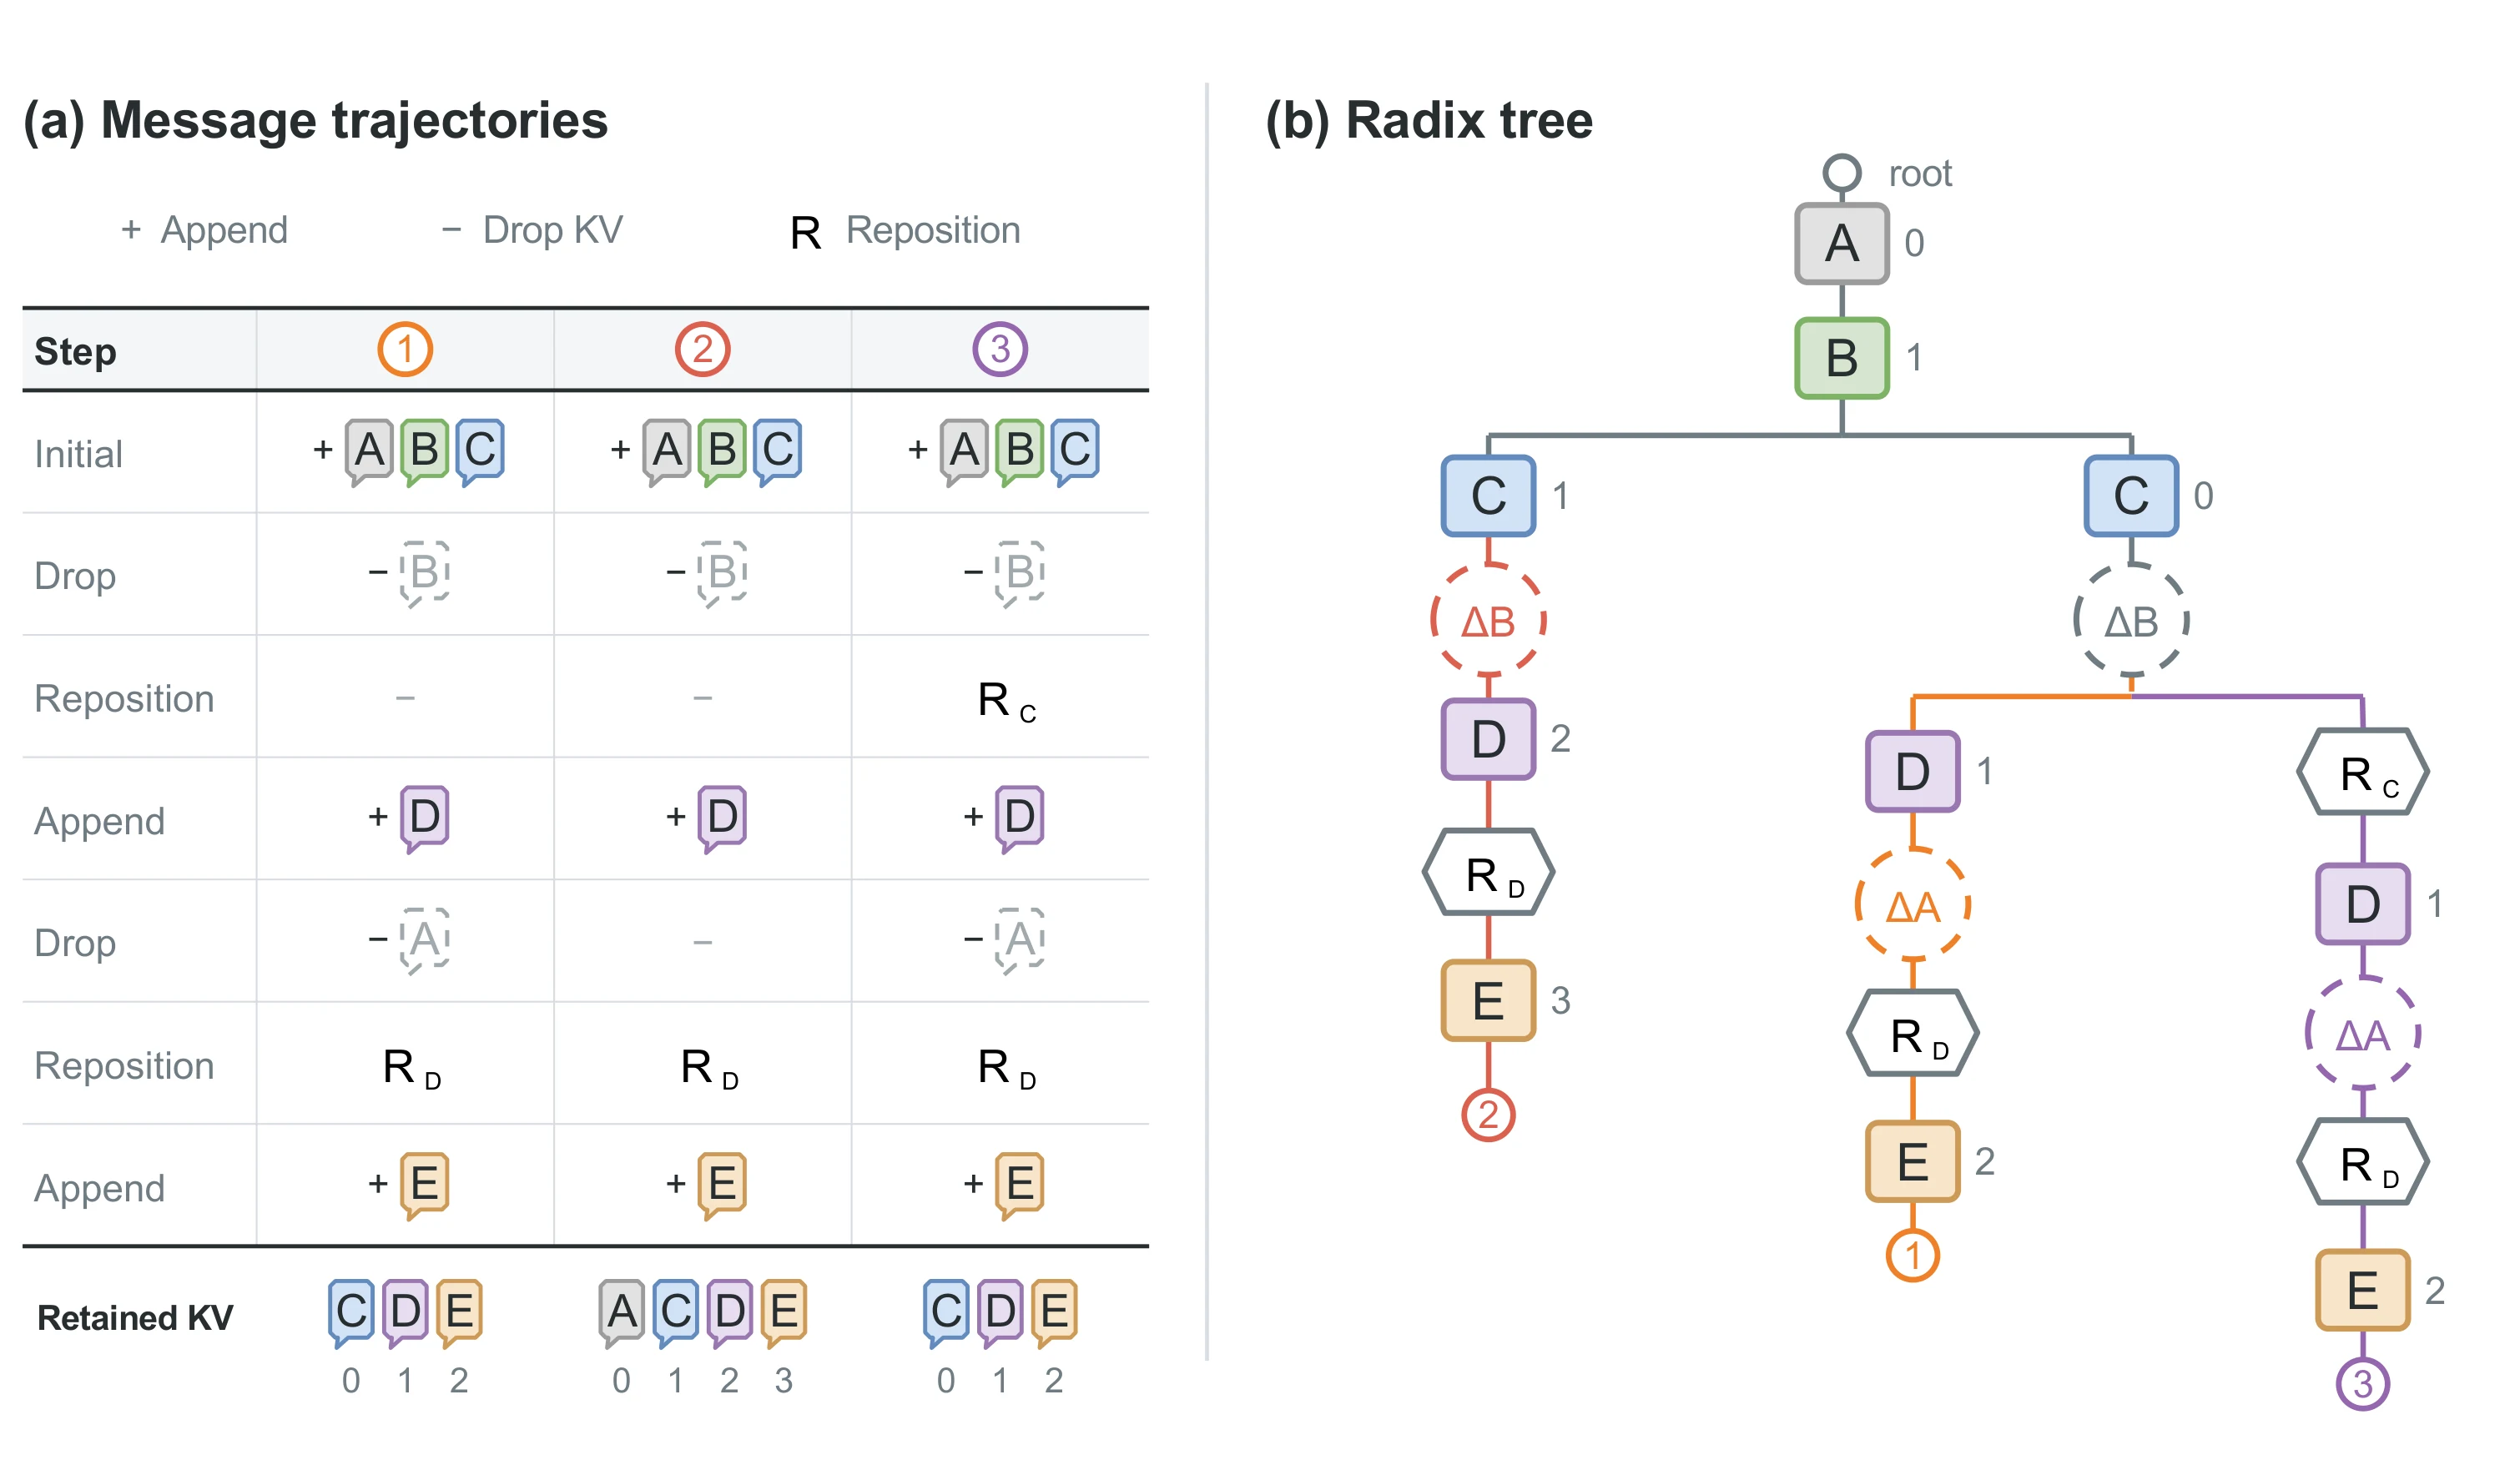 Gambar 3: Manajemen Reposition pada KV Pool dan Radix Tree: Rotasi RoPE pada Key dilakukan secara in-place tanpa forward pass, memisahkan cabang versi posisi sembari mendaur ulang physical page yang sudah usang (Fu et al., arXiv:2610.28577).
4. Segment-Batch Attention: Restorasi State dalam 1 Forward Pass Tunggal
Tantangan paling kritis pada sistem serving adalah: Bagaimana jika cache dieviction akibat memory pressure, lalu klien meminta generasi token berikutnya? Pada arsitektur biasa, merekonstruksi cache yang melibatkan beberapa operasi drop dan reposition di masa lalu memerlukan banyak forward pass terpisah sesuai jumlah tahapan riwayat.
AKV memecahkan problem ini melalui teknik inovatif bernama Segment-Batch Attention:
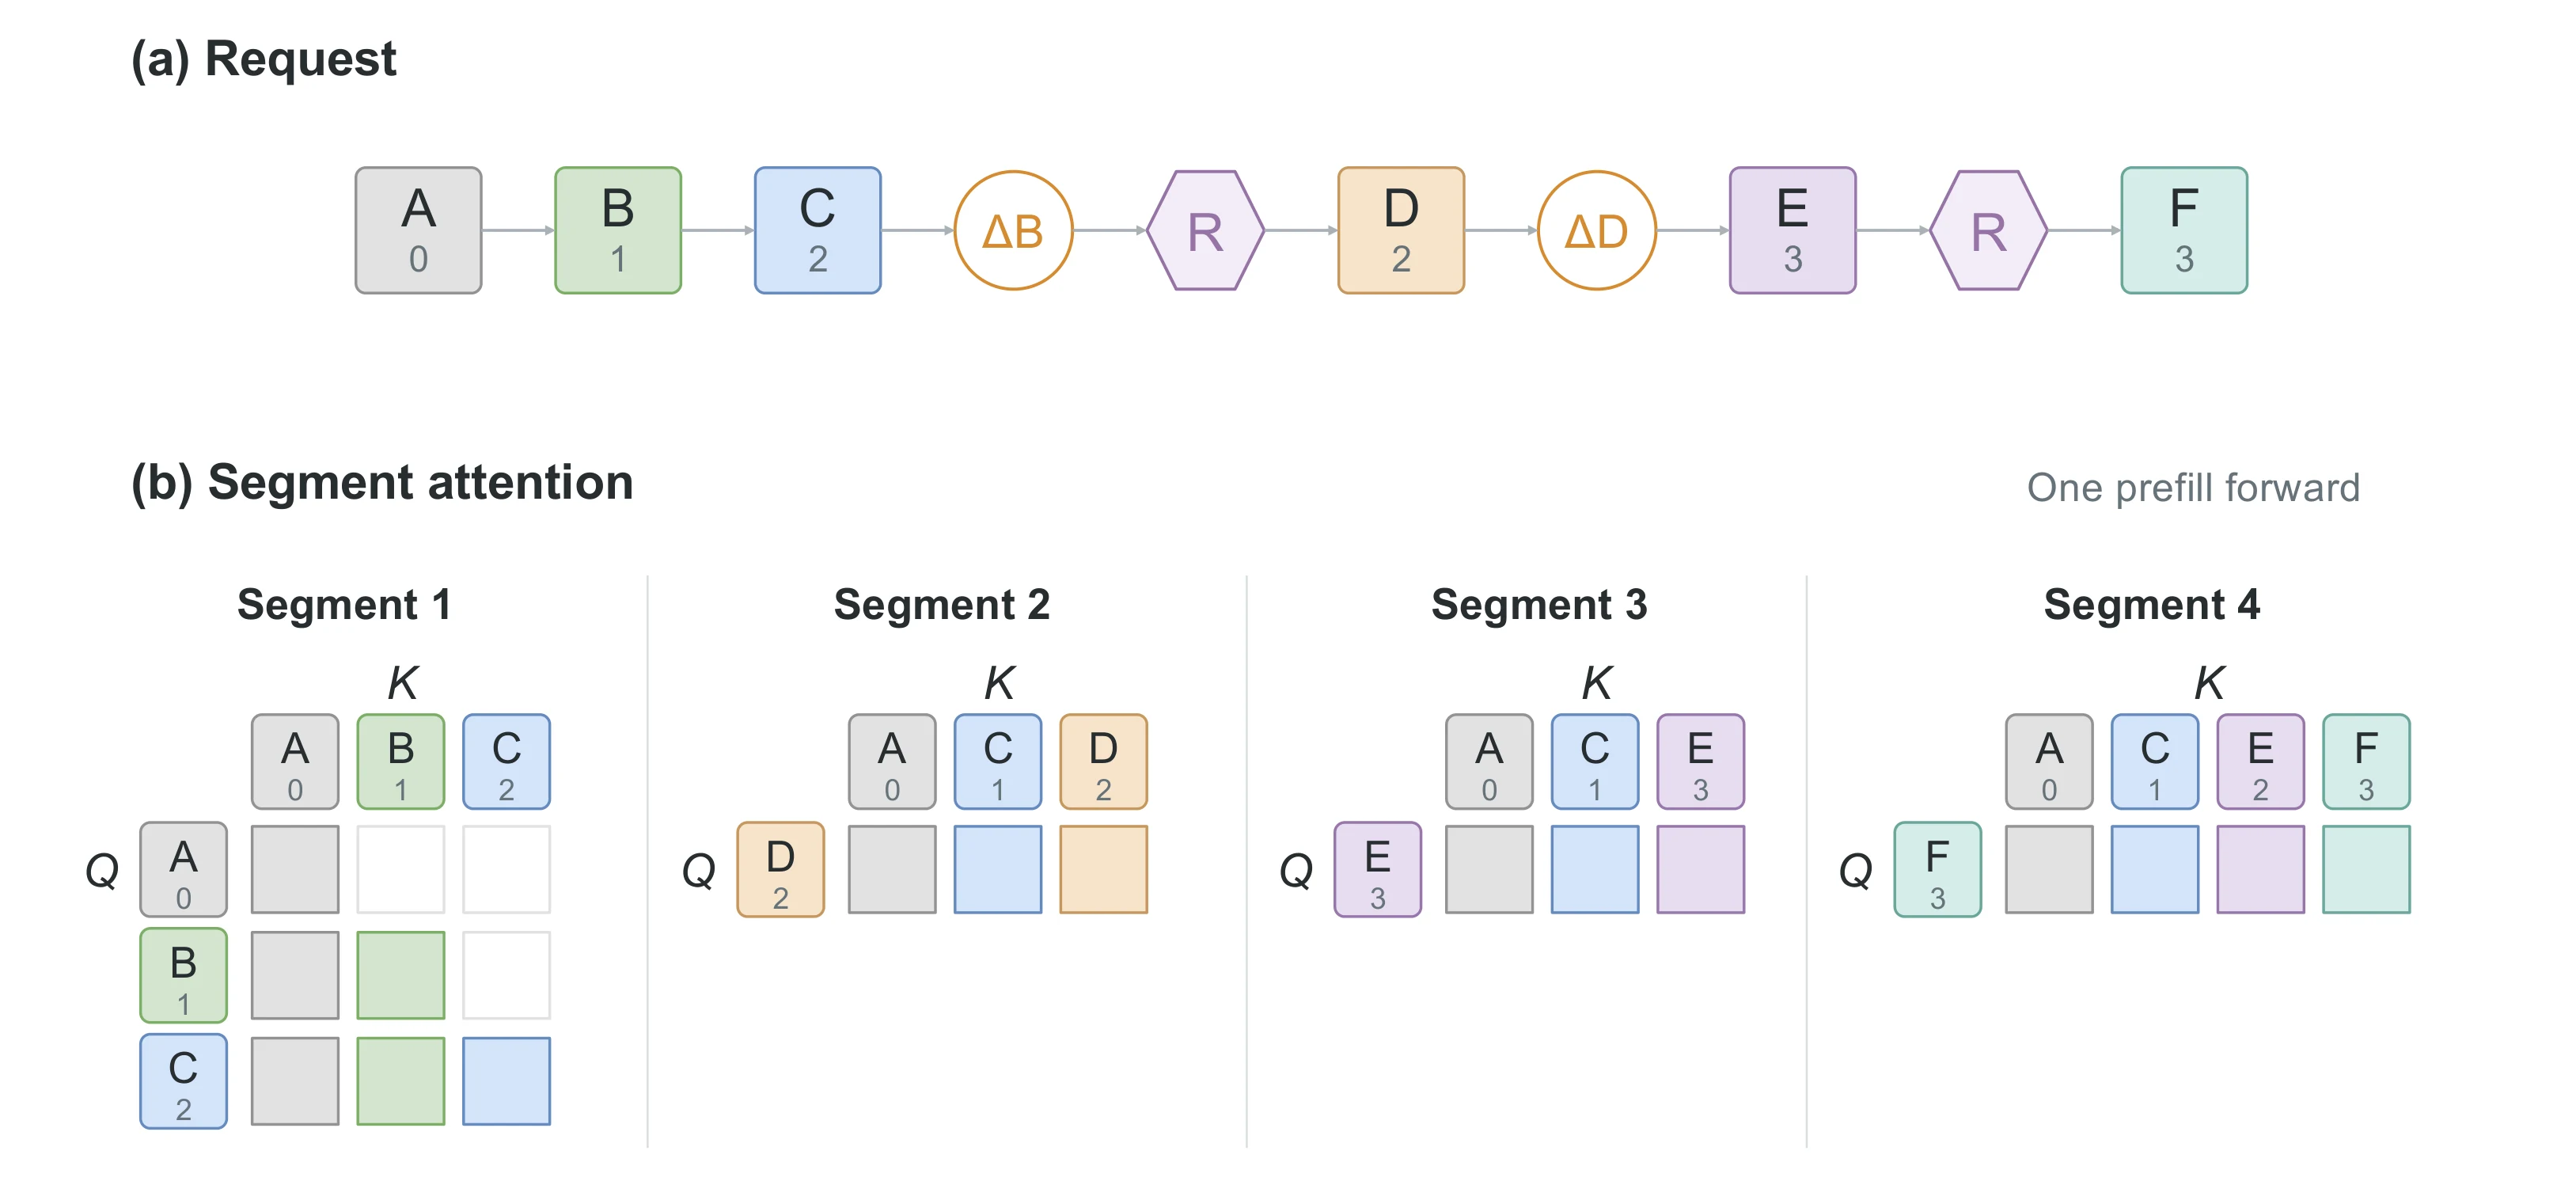 Gambar 4: Restorasi Cache dengan Segment-Batch Attention: Sekuens kueri dipartisi menjadi segmen-segmen terpisah pada batas operasi drop/repos. Hanya modul attention yang disegmentasi, sementara lapisan FFN mengeksekusi seluruh urutan sebagai satu batch utuh (Fu et al., arXiv:2610.28577).
Seperti terlihat pada Gambar 4, kueri dipecah menjadi beberapa segmen berdasarkan batas trigger drop atau repos. Setiap segmen hanya memilih physical page KV yang relevan bagi visibilitas historisnya. Kunci efisiensi arsitektur ini: hanya modul Attention yang disegmentasi, sedangkan lapisan Feed-Forward Network (FFN)—yang menyumbang porsi terbesar memory traffic bandwidth akibat pembacaan bobot model (weight reads)—tetap mengeksekusi seluruh urutan token sebagai satu batch tunggal dalam satu forward pass! Hal ini mengeliminasi memory traffic overhead yang selama ini melumpuhkan re-prefill konvensional.
5. Implementasi Kontroler Produksi: Extended Radix Tree & Rotary Key Transformation
Di bawah ini adalah implementasi sistemik kontroler AKV dalam TypeScript enterprise yang mengintegrasikan pencocokan Extended Radix Tree, eviksi drop-aware, transformasi rotasi RoPE, dan segment-batch router:
// Production Implementation: AKV Serving Engine & Extended Radix Tree
// Berdasarkan Arsitektur Tsinghua University & CUHK (arXiv:2610.28577 - Oktober 2026)
//
// Karakteristik Inti:
// 1. Stateless Interface, Stateful Serving: Client mengirim token sequence + operate-after cache operations.
// 2. Extended Radix Tree with Drop Nodes (Δ) & Repos Nodes (R): Menangani history dependence pada cache state.
// 3. Drop-Aware Cache Eviction: Reklamasi physical memory tanpa melanggar request isolation antar multi-tenant.
// 4. RoPE Key Rotation without Weight Activation: Menggeser encoding posisi O(1) tanpa forward pass.
// 5. Segment-Batch Attention Router: Rekonstruksi multi-segment query dalam satu model forward pass tunggal.

export type CacheOpType = 'append' | 'drop' | 'repos';

export interface CacheOpInstruction {
  drop?: Record; // messageIndex boundary -> array of dropped message indices
  reposition?: number[];          // array of messageIndex boundaries for repos
}

export interface RadixTreeNode {
  id: string;
  tokenIds: number[];
  positionIndex: number;
  nodeType: 'token' | 'drop' | 'repos';
  droppedIndices?: number[];
  reposTarget?: number;
  physicalPageIds: number[];
  children: Map;
  refCount: number;
  isEvicted: boolean;
}

export interface AttentionSegment {
  segmentIndex: number;
  queryStart: number;
  queryEnd: number;
  visibleKeyPageIds: number[];
  positionOffsets: number[];
}

export class AKVExtendedRadixTree {
  private root: RadixTreeNode;
  private pagePool: Map = new Map();
  private totalPages: number;
  private freePageIds: number[] = [];

  constructor(maxMemoryPages: number = 65536) {
    this.totalPages = maxMemoryPages;
    for (let i = 0; i < maxMemoryPages; i++) {
      this.freePageIds.push(i);
    }
    this.root = {
      id: 'root',
      tokenIds: [],
      positionIndex: 0,
      nodeType: 'token',
      physicalPageIds: [],
      children: new Map(),
      refCount: 1,
      isEvicted: false,
    };
  }

  /**
   * Prefix Matching dengan Kesadaran History-Dependence
   * Memastikan identical token sequences dengan urutan drop/repos berbeda tidak keliru di-reuse.
   */
  public matchPrefix(
    tokens: number[],
    opSequence: Array<{ type: CacheOpType; meta?: any }>
  ): { matchedNode: RadixTreeNode; matchedTokens: number; requiresRestore: boolean } {
    let curr = this.root;
    let matchedTokens = 0;
    let opPtr = 0;

    for (let i = 0; i < tokens.length; ) {
      const tok = tokens[i];
      let branchKey = `tok_${tok}`;

      // Cek apakah ada drop node atau repos node pada boundary ini
      if (opPtr < opSequence.length) {
        const op = opSequence[opPtr];
        if (op.type === 'drop') {
          branchKey = `drop_${JSON.stringify(op.meta.dropped)}_${tok}`;
          opPtr++;
        } else if (op.type === 'repos') {
          branchKey = `repos_${op.meta.targetPos}_${tok}`;
          opPtr++;
        }
      }

      if (curr.children.has(branchKey)) {
        curr = curr.children.get(branchKey)!;
        matchedTokens++;
        i++;
      } else {
        break;
      }
    }

    return {
      matchedNode: curr,
      matchedTokens,
      requiresRestore: curr.isEvicted,
    };
  }

  /**
   * Operasi Drop-Aware Eviction:
   * Menghapus physical page dari node yang sudah di-drop oleh seluruh active request,
   * namun mempertahankan metadata tree placeholder untuk menjaga prefix lookup turunan.
   */
  public evictDroppedNodePages(node: RadixTreeNode): number {
    if (node.refCount <= 0 && !node.isEvicted && node.physicalPageIds.length > 0) {
      const freed = node.physicalPageIds.length;
      for (const pid of node.physicalPageIds) {
        this.pagePool.delete(pid);
        this.freePageIds.push(pid);
      }
      node.physicalPageIds = [];
      node.isEvicted = true;
      return freed;
    }
    return 0;
  }

  /**
   * RoPE Key Rotation: Menggeser rotary embedding posisi dari p ke q
   * K_new = R(q) * R(p)^-1 * K_old
   * Tidak membutuhkan forward pass atau akses ke bobot layer LLM.
   */
  public rotateKeyRotaryPosition(
    kVector: Float32Array,
    fromPos: number,
    toPos: number,
    dim: number,
    base: number = 10000
  ): Float32Array {
    const delta = toPos - fromPos;
    if (delta === 0) return kVector;

    const rotated = new Float32Array(kVector.length);
    for (let i = 0; i < dim; i += 2) {
      const theta = delta / Math.pow(base, (2 * (i / 2)) / dim);
      const cosTheta = Math.cos(theta);
      const sinTheta = Math.sin(theta);

      const x0 = kVector[i];
      const x1 = kVector[i + 1];

      rotated[i] = x0 * cosTheta - x1 * sinTheta;
      rotated[i + 1] = x0 * sinTheta + x1 * cosTheta;
    }
    return rotated;
  }

  /**
   * Segment-Batch Attention Router:
   * Mengelompokkan multi-turn interaction menjadi segmen attention independen
   * untuk dieksekusi dalam 1 model forward pass tanpa mengulang pembacaan bobot FFN.
   */
  public buildSegmentBatchPlan(
    totalTokens: number,
    dropBoundaries: number[],
    reposBoundaries: number[]
  ): AttentionSegment[] {
    const boundaries = Array.from(new Set([0, ...dropBoundaries, ...reposBoundaries, totalTokens])).sort((a, b) => a - b);
    const segments: AttentionSegment[] = [];

    for (let i = 0; i < boundaries.length - 1; i++) {
      const qStart = boundaries[i];
      const qEnd = boundaries[i + 1];

      segments.push({
        segmentIndex: i,
        queryStart: qStart,
        queryEnd: qEnd,
        visibleKeyPageIds: [], // Dihitung dinamis via active logical context
        positionOffsets: [qStart, qEnd],
      });
    }

    return segments;
  }
}
6. Evaluasi Benchmark Empiris & Analisis Kinerja Lapangan
Efektivitas Cache Engineering dan engine AKV dievaluasi secara masif menggunakan tiga model frontier berarsitektur Mixture-of-Experts (MoE) dan dense (GPT-OSS-120B dengan 5.1B active parameter, MiniMax-M2.7 230B total / 10B active parameter, dan MiroThinker-1.7-Mini 30B total / 3B active parameter) pada 4 benchmark agen terberat: BCP (100 tugas), GAIA-Text, SWE-bench Verified (500 tugas repositori perangkat lunak), dan xbench-DS.
6.1 Akurasi Task vs Biaya Komputasi (Tabel 1 Paper Asli)
| Model & Metode | BCP Score / Cost | GAIA-Text Score / Cost | SWE-Verified Score / Cost | Rata-Rata Score | Rata-Rata Cost (Cents) |
|---|---|---|---|---|---|
| MiniMax-M2.7 (230B MoE, 10B Active) | |||||
| Standard Serving | 58.9% / 5.2¢ | 35.0% / 2.4¢ | 75.2% / 7.0¢ | 52.4% | 5.0¢ |
| Text Context Engineering | 62.3% / 5.3¢ | 36.9% / 2.7¢ | 72.0% / 9.4¢ | 52.8% | 5.7¢ (+14% lebih boros) |
| AKV (Cache Engineering) | 58.9% / 4.8¢ | 40.8% / 2.6¢ | 74.4% / 5.5¢ | 53.7% (+1.3%) | 4.4¢ (-12.0% Cost) |
| GPT-OSS-120B (5.1B Active Parameters) | |||||
| Standard Serving | 57.5% / 13.1¢ | 68.0% / 5.4¢ | 40.0% / 20.0¢ | 51.0% | 11.2¢ |
| Text Context Engineering | 52.7% / 12.6¢ | 65.1% / 6.8¢ | 36.8% / 15.8¢ | 48.3% (-2.7%) | 10.2¢ |
| AKV (Cache Engineering) | 61.9% / 11.4¢ | 69.9% / 4.1¢ | 43.2% / 9.7¢ | 53.1% (+2.1%) | 7.3¢ (-34.8% Cost) |
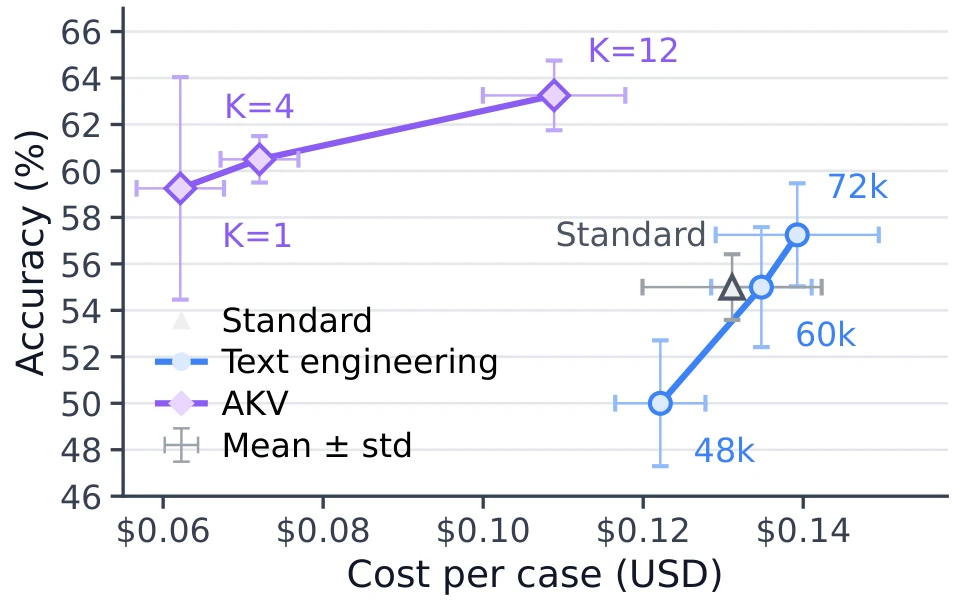 Gambar 5: Pareto Frontier Akurasi vs Biaya: AKV mendominasi kurva trade-off di atas context summarization konvensional (Fu et al., arXiv:2610.28577).
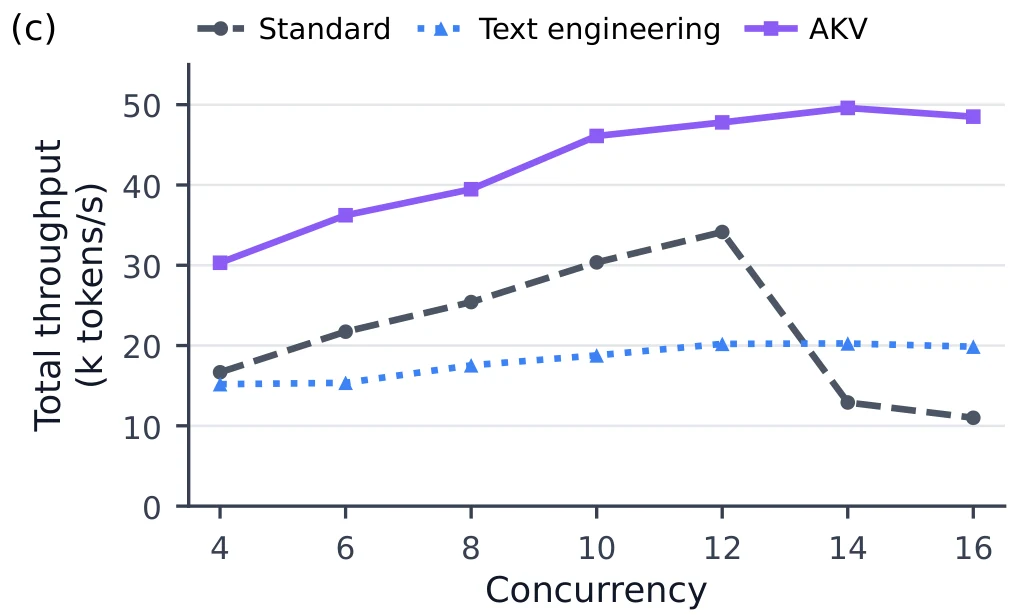 Gambar 6: Throughput Serving vs Tingkat Concurrency: AKV mempertahankan kapasitas throughput hingga 51.837 input tok/s dan 369 output tok/s (Fu et al., arXiv:2610.28577).
6.2 Latensi dan Serving Throughput (Tabel 2 Paper Asli)
Pada cluster serving GPT-OSS-120B di bawah beban SWE-bench Verified dengan tingkat konkurensi (C = 14):
- Request Latency (Mean & P95): Standard serving mengalami lonjakan antrean hingga 30.16s (mean) dan 108.86s (P95). AKV mempertahankan mean latency pada 9.09s dan P95 pada 28.49s—akselerasi 3.3x lipat pada mean dan 3.8x lipat pada P95.
- Time-to-First-Token (TTFT P95): Standard serving melonjak ke 88.29s dan Text Engineering melonjak ke 47.36s (akibat re-prefill). AKV menekan TTFT P95 ke 8.62 detik (10.2x lebih responsif).
- Input & Output Throughput: AKV mencatatkan 51.837 tokens/detik pada input throughput (dibanding 12.767 pada Standard) dan 369 tokens/detik pada output throughput (dibanding 146 pada Standard).
7. Kebijakan Otonom: Recursive Self-Improvement (RSI) Cache Policy
Salah satu temuan paling menarik dari makalah ini adalah pembuktian bahwa agen AI dapat mengeksekusi Recursive Self-Improvement (RSI) untuk menyempurnakan kebijakan cache-nya sendiri tanpa intervensi rekayasa manusia.
Dengan memperlakukan operasi cache sebagai programmable policy space, agen menganalisis korelasi antara token-token observasi yang dibuang dan keberhasilan sub-task. Melalui 4 iterasi evaluasi mandiri pada held-out task BCP dengan model MiniMax-M2.7, kebijakan yang dihasilkan secara otonom oleh agen berhasil memangkas biaya tambahan 7.1% di atas aturan rolling-drop yang dirancang oleh pakar manusia, sembari mempertahankan akurasi task di angka 59%.
8. Jebakan Arsitektur (Pitfalls) & Pedoman Migrasi Produksi
Saat mengadopsi cache engineering di kluster Kubernetes / inference engine internal, perhatikan 4 jebakan fatal berikut:
-
1. Naive Drop yang Merusak Reasoning Continuity: Jangan pernah membuang status KV dari pemikiran internal model (chain-of-thought atau assistant messages). Eksperimen ablasi pada Tabel 3 paper membuktikan bahwa membuang reasoning cache menurunkan akurasi BCP dari 61.9% anjlok ke 51.0%. Aturan emas: Keep all reasoning, rolling-drop older tool raw observations.
-
2. Position Encoding Index Overflow: Jika hanya melakukan
droptanpa memanggilrepossecara berkala, indeks posisi RoPE token baru akan terus merangkak naik hingga menembus batas konteks latih model (misal 128k), memicu perplexity explosion meskipun active memory di VRAM sangat sedikit. Jalankanrepossetiap 2-4 kali pembersihan cache. -
3. Pelanggaran Request Isolation pada Multi-Tenant Serving: Physical page yang di-drop oleh Request A tidak boleh langsung di-free jika Request B masih berbagi prefix path yang sama pada Radix Tree. Pastikan mekanisme reference counting atomic diterapkan sebelum mengembalikan page ke memory allocator.
-
4. Memory Traffic Bottleneck saat Restorasi: Hindari mengeksekusi restorasi histori operasi dengan memanggil forward pass berulang di boundary drop. Wajib gunakan Segment-Batch Attention agar lapisan FFN hanya membaca matriks bobot satu kali untuk seluruh urutan request.
9. Kesimpulan & Roadmap Masa Depan
Inovasi yang dihadirkan oleh tim peneliti Tsinghua University dan CUHK dalam Cache Engineering for Agents (arXiv:2610.28577) menandai pergeseran paradigma arsitektur yang fundamental. Selama ini, serving engine memperlakukan KV cache sebagai detail implementasi internal yang pasif, sementara agen hanya diberi akses ke level teks string. Dengan membuka primitif append, drop, dan repos melalui engine AKV, batas antara runtime inferensi sistem dan logika agen otonom kini tersambung secara mulus.
Bagi tim pengembang yang membangun agen perangkat lunak, sistem monitoring cloud, maupun asisten riset otomatis, beralih dari prompt trimming ke cache engineering adalah langkah terpenting untuk menekan biaya tagihan token hingga 27.7%, melipatgandakan throughput serving, dan mengeliminasi re-prefill penalty di lingkungan produksi 2026.
Referensi & Sumber Terverifikasi
- [1]Cache Engineering for Agents(arXiv:2610.28577v1 [cs.CL / cs.AI] — Tianyu Fu, Ruoxi Wang, Zihan Min, Zhongqi Ren, Zhihao Li, Tengxuan Liu, Shengxu Mu, Hanling Zhang, Yu Wang (Tsinghua University, CUHK))
- [2]Efficient Streaming Language Models with Attention Sinks (StreamingLLM)(ICLR 2024 / arXiv:2309.17453 — Xiao et al.)
- [3]SGLang: Efficient Execution of Structured Language Model Programs (RadixAttention)(arXiv:2312.07104 — Zheng et al.)
- [4]vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023 / arXiv:2309.06180 — Kwon et al.)
- [5]RoFormer: Enhanced Transformer with Rotary Position Embedding (RoPE)(Neurocomputing 2024 / arXiv:2104.09864 — Su et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.
DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.
Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.