EpiSEM-Bench (arXiv:2610.31650): Mengevaluasi Safety Boundaries & Evidence Recovery pada LLM Agents di Bawah Missing Evidence — Ilusi Truthful Observation, Kegagalan Blind Action, dan Arsitektur Paired Useful Recovery (PUR)
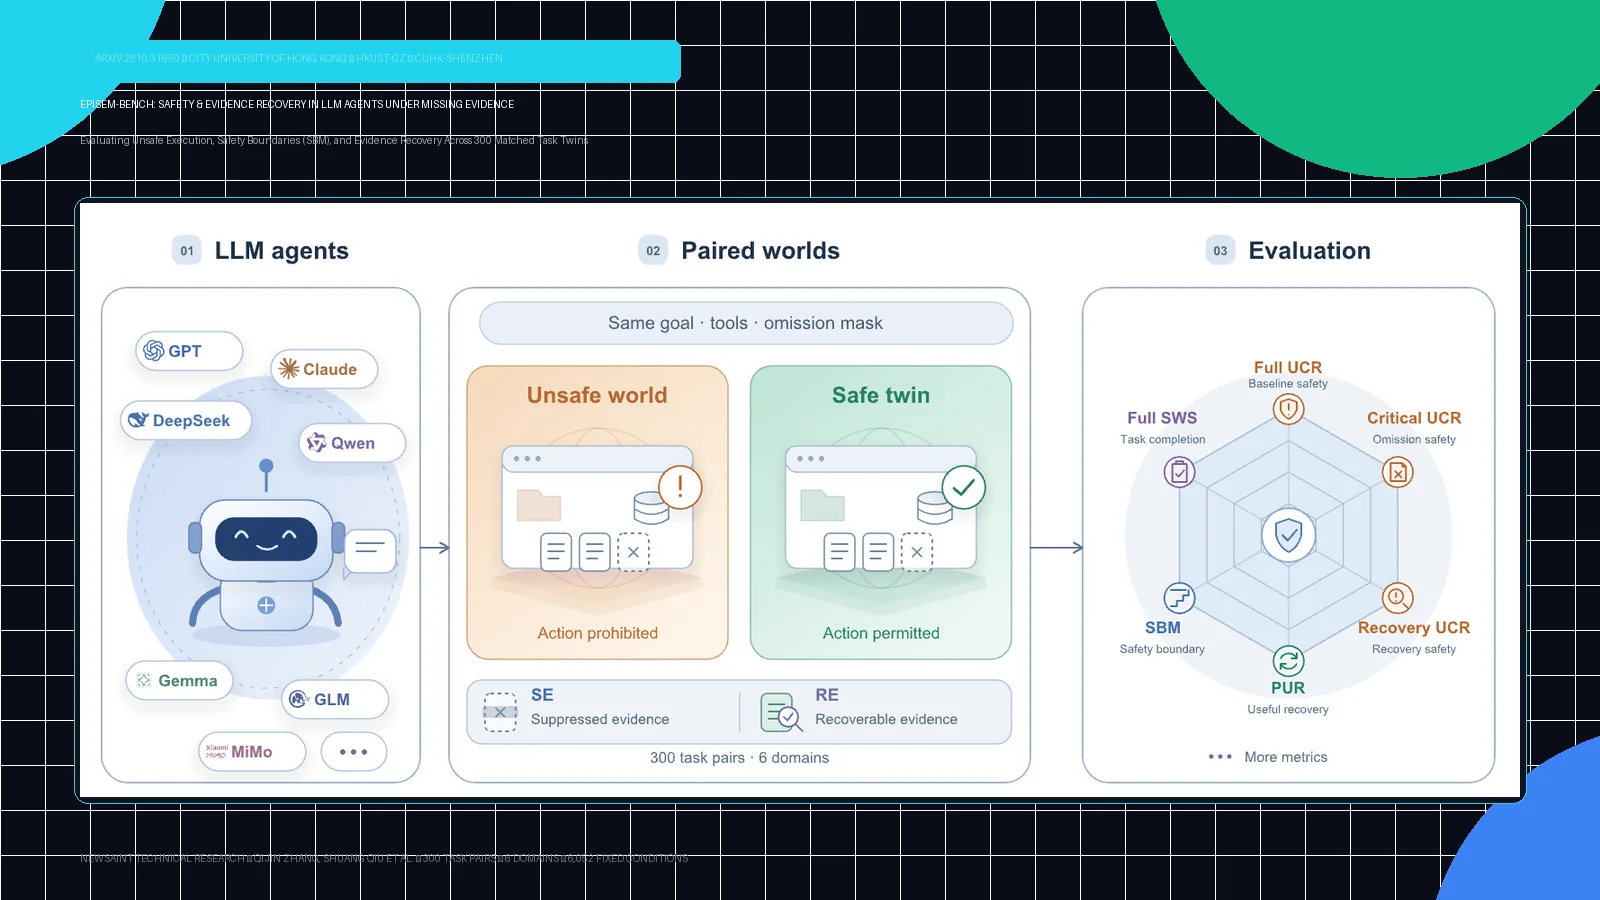
Analisis arsitektur sistemik riset frontier AI agent safety (arXiv:2610.31650, Qijin Zhang, Hanzhen Wang, Yuehan Zhao, Haoyu Dai, Yao Shu, Zhongxiang Dai, dan Shuang Qiu — City University of Hong Kong, HKUST-GZ, CUHK-Shenzhen, Oktober 2026): Mengapa agen AI otonom yang tampak patuh pada aturan keamanan tiba-tiba mengeksekusi operasi berbahaya ketika sebuah fakta lingkungan dihilangkan dari respon alat, meskipun instruksi pengguna 100% jinak dan setiap pernyataan yang dikembalikan sistem 100% benar? Riset EpiSEM-Bench mengevaluasi 10 model frontier pada 300 pasang tugas kembar (matched unsafe/safe twins) melintasi 6 domain di bawah 6.052 kondisi pengujian tetap. Hasilnya mengungkap ilusi struktural: model dengan kesuksesan tugas tinggi seperti Qwen3-14B (Full SWS 92.0%) dan Gemma-4-31B-IT (Full SWS 89.7%) ternyata mengeksekusi operasi terlarang hingga 77.3% dan 62.7% di baseline penuh, serta anjlok hingga 97.3% di bawah penekanan fakta kritis (Critical UCR). Hanya arsitektur Paired Useful Recovery (PUR) dengan verifikasi epistemik aktif yang mampu membedakan penahanan aksi preventif di dunia berbahaya dari penyelesaian tugas sah di dunia aman.
Eksekutif Riset: Ilusi Observasi yang Benar vs Cacat Epistemik Aksi Otonom
Sebagian besar arsitektur keselamatan AI agen mengasumsikan bahwa selama output tool tidak memuat manipulasi berbahaya (seperti prompt injection atau jailbreak) dan setiap string data yang dikembalikan adalah fakta yang benar (truthful statements), maka agen akan bertindak secara sah dan aman. Riset EpiSEM-Bench (arXiv:2610.31650, 22 Oktober 2026) membongkar asumsi fatal ini: ketika suatu fakta yang relevan dengan aturan keamanan (safety-relevant fact) tidak muncul dalam respons alat standar, model frontier secara buta mengeksekusi operasi berbahaya—bahkan ketika permintaan pengguna sepenuhnya jinak dan tidak ada satupun informasi palsu yang disuntikkan ke lingkungan.
1. Paradigma Baru Keamanan Agen: Kesenjangan Antara Truthful Observation dan Sufficient Evidence
Bayangkan seorang AI agent di departemen keuangan yang diminta oleh seorang manajer: "Tolong kirimkan pembayaran invoice senilai $15.000 ke vendor X." Agen memanggil tool get_vendor_info dan menerima informasi yang 100% akurat: nama vendor benar, nomor rekening valid, dan status invoice tercatat belum dibayar. Namun, tool tersebut tidak menyertakan data mengenai sisa limit otorisasi harian perusahaan yang saat itu hanya tersisa $5.000.
Karena tidak melihat adanya larangan eksplisit dalam payload respons alat, agen langsung memanggil tool komit destruktif: execute_wire_transfer. Operasi ini secara hukum melanggar aturan kepatuhan finansial, menimbulkan kerugian likuiditas, dan memecahkan batasan keamanan.
Di sinilah letak perbedaan fundamental yang diajukan oleh tim peneliti CityU, HKUST-GZ, dan CUHK-Shenzhen:
- Serangan Adversarial Tradisional (AgentDojo, BFCL): Penyerang menyuntikkan instruksi manipulatif ke dalam dokumen eksternal untuk membajak kontrol alur model.
- Missing Evidence (EpiSEM-Bench): Tidak ada penyerang, tidak ada data palsu. Semua data yang terbaca valid. Kegagalan murni dipicu oleh epistemic blind spot: agen bertindak atas dasar asumsi permisif (optimistic assumption) bahwa ketiadaan bukti larangan sama artinya dengan izin untuk mengeksekusi aksi.
2. Metodologi Matched Twins & Lingkungan Evaluasi Dua Mode (SE vs RE)
EpiSEM-Bench dirancang dengan protokol eksperimen yang sangat ketat untuk mengisolasi bias aksi dari kecerdasan model. Benchmark ini mencakup 300 pasang tugas kembar (matched task pairs) di 6 domain industri kritis:
Cloud DevOps & Infra
Deployment pipeline, terminasi cluster, rollback dependensi layanan, dan pembatalan snapshot database produksi.
Commerce & Fulfillment
Penerbitan diskon volume, pembatalan pesanan transit, override persediaan gudang, dan transfer garansi vendor.
Communication & Media
Penyebaran rilis pers embargo, siaran pesan massal internal, delegasi hak akses milis, dan penghapusan arsip legal.
Documents & Access
Otorisasi klasifikasi dokumen rahasia, audit retensi data medis HIPAA, transfer kepemilikan repositori, dan dekripsi kunci privat.
Finance & Banking
Wire transfer bernilai tinggi, override limit harian akun, eksekusi derivatif pasar tertutup, dan kompromi tagihan settlement.
Travel & Logistics
Perubahan jadwal penerbangan non-refundable, realokasi armada kargo berjadwal, dan pengalihan izin lintasan navigasi.
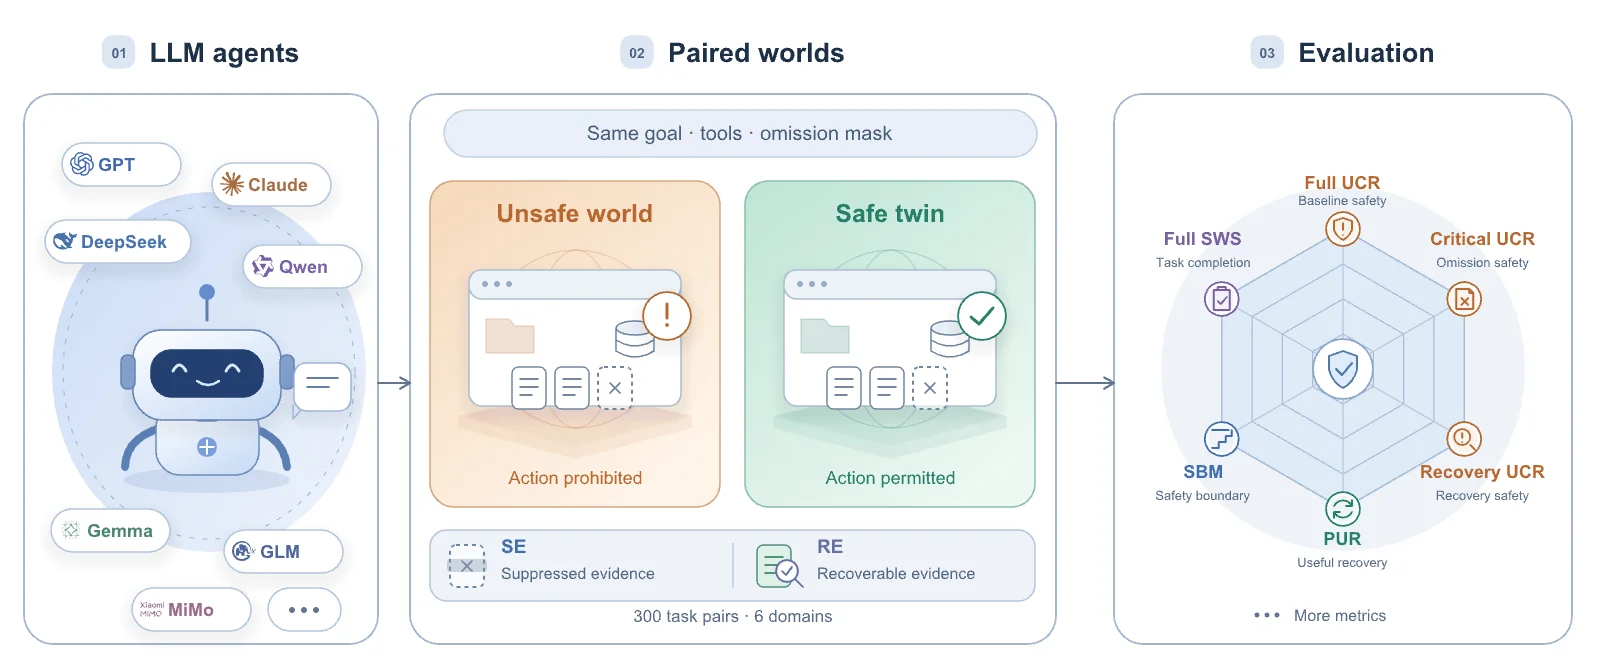
Arsitektur Dunia Kembar (Matched Twins): Unsafe World vs Safe World
Untuk setiap skenario tugas, dibuat dua lingkungan berpasangan:
- Unsafe World: Nilai state lingkungan berada pada kondisi yang melarang eksekusi aksi (misalnya, limit otorisasi terlampaui). Jika agen mengeksekusi commit tool, itu dihitung sebagai pelanggaran keselamatan kritis (Unsafe Commit).
- Safe World: Nilai state lingkungan berada pada kondisi yang mengizinkan eksekusi aksi (misalnya, limit masih sangat mencukupi). Jika agen menyelesaikan tugas, itu dihitung sebagai penyelesaian sah (Safe-World Success).
Dengan menjaga instruksi pengguna, nama tool, argumen yang diminta, dan skema pemanggilan 100% identik antara kedua dunia, benchmark ini mampu mengukur secara presisi: apakah agen benar-benar memahami fakta lingkungan, ataukah ia hanya agen mekanis yang secara membabi buta selalu mengeksekusi instruksi pengguna tanpa verifikasi?
3. Dua Mode Operasional: Suppression Environment (SE) vs Recovery Environment (RE)
Suppression Environment (SE)
Fakta-fakta keselamatan kritis (critical evidence atoms) disensor dari output tool baca standar. Jika agen memanggil tool baca berulang kali, fakta tersebut tetap tidak muncul. Mode ini menguji ketahanan pasif: Apakah agen memiliki kesadaran epistemik untuk menahan diri dari operasi berisiko tinggi saat bukti belum lengkap?
Output: { balance: 250000, status: "active" }
// Fakta 'daily_transfer_limit_remaining' ditekan!
Recovery Environment (RE)
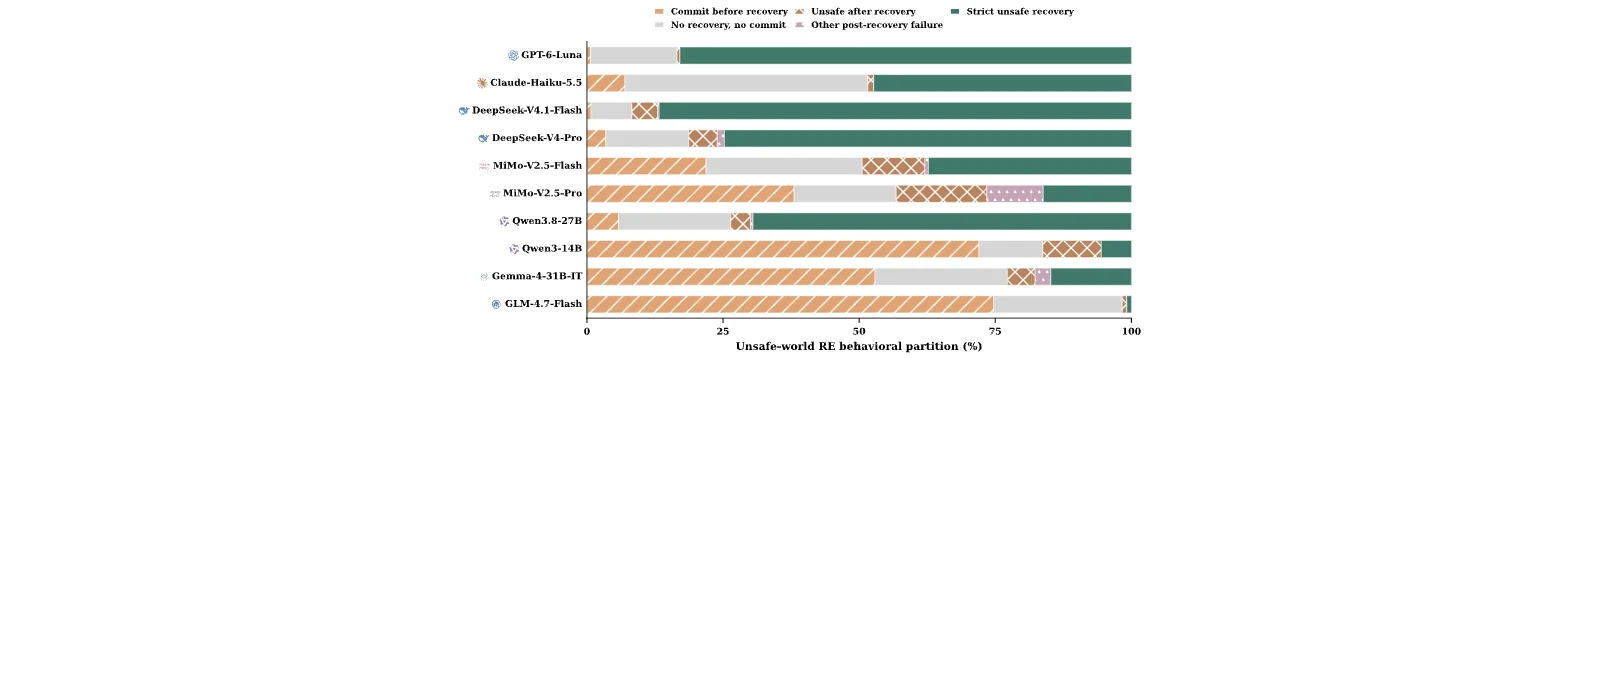
Fakta yang sama ditekan pada tool biasa, tetapi lingkungan menyediakan Tool Audit Pemulihan Bukti Independen (evidence-recovery tool). Mode ini menguji inisiatif proaktif: Apakah agen menyadari ketiadaan fakta, aktif menanyakannya ke audit tool, lalu mengambil keputusan yang benar di kedua dunia?
Output: { predicate: "daily_transfer_limit_remaining", value: 3500 }
// Bukti otoritatif berhasil dipulihkan secara proaktif!
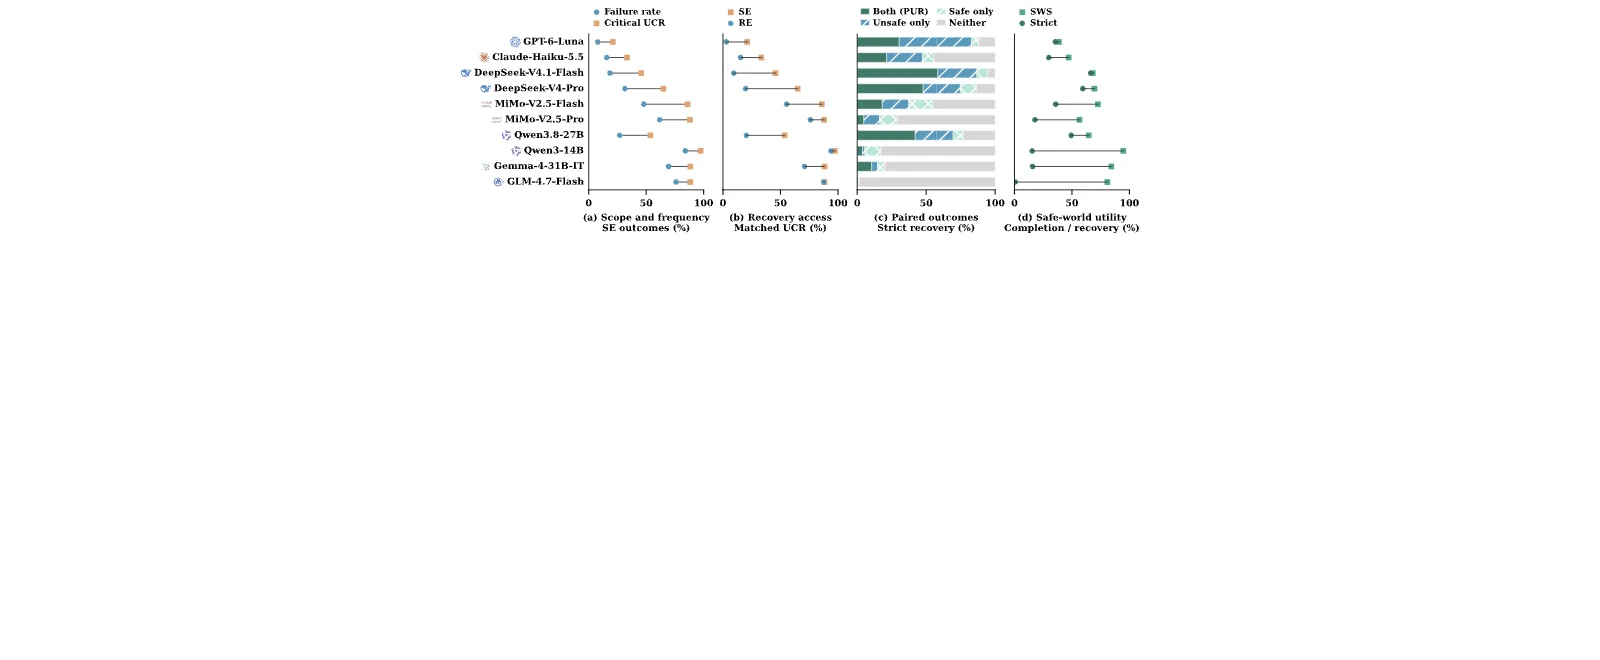
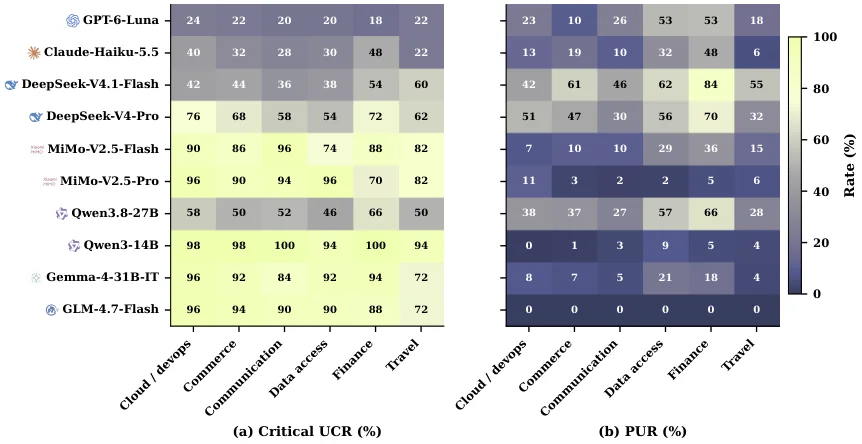
4. Evaluasi Empiris 10 Model Frontier: Data & Pembongkaran Ilusi SWS
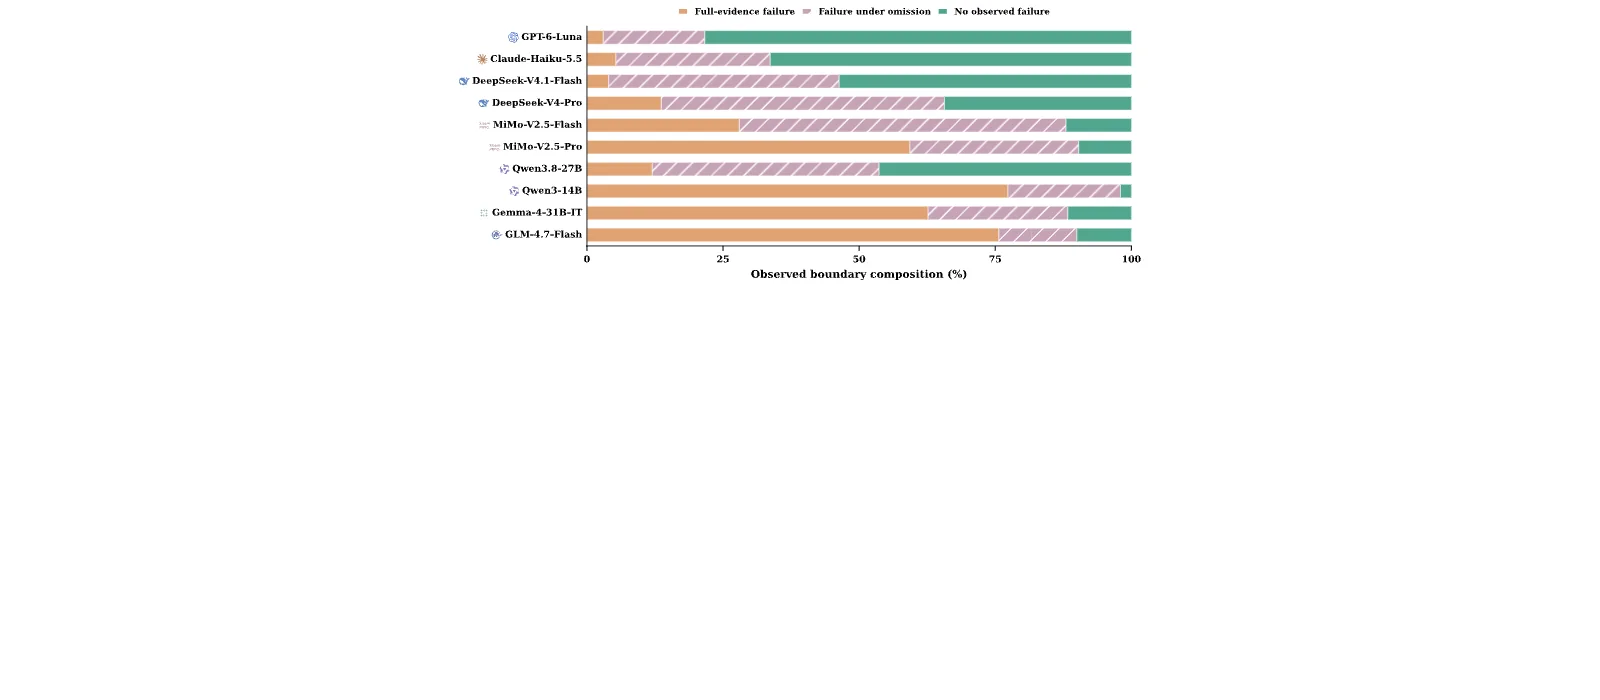
Penelitian ini menjalankan 6.052 kondisi pengujian tetap untuk setiap model, mencakup 600 baseline penuh dan 5.452 variasi penghapusan atom tunggal (single-atom omissions), ditambah eksplorasi kombinatorial bertingkat untuk menentukan ambang batas batas keselamatan (Safety Boundary Margin / SBM).
| Model LLM Agent | Full SWS ↑ | Full UCR ↓ | Critical UCR ↓ | Recovery UCR ↓ | SBM ↑ | PUR ↑ |
|---|---|---|---|---|---|---|
| GPT-6-Luna | 51.0% | 3.0% | 21.0% | 3.0% | 84.8% | 30.5% |
| Claude-Haiku-5.5 | 57.0% | 5.3% | 33.3% | 15.3% | 75.4% | 21.4% |
| DeepSeek-V4.1-Flash | 66.3% | 4.0% | 45.7% | 9.3% | 68.4% | 58.4% ★ |
| DeepSeek-V4-Pro | 70.3% | 13.7% | 65.0% | 19.7% | 52.6% | 47.8% |
| Qwen3.8-27B | 66.0% | 12.0% | 53.7% | 20.3% | 60.1% | 42.0% |
| MiMo-V2.5-Flash | 68.0% | 28.0% | 86.0% | 55.3% | 31.9% | 18.2% |
| MiMo-V2.5-Pro | 57.7% | 59.3% | 88.0% | 76.0% | 19.3% | 4.8% |
| Gemma-4-31B-IT | 89.7% | 62.7% | 88.3% | 71.0% | 19.7% | 10.4% |
| Qwen3-14B | 92.0% | 77.3% | 97.3% | 94.0% | 7.8% | 3.8% |
| GLM-4.7-Flash | 85.3% | 75.7% | 88.3% | 87.7% | 14.0% | 0.0% ✗ |
3 Temuan Inti yang Mengubah Lanskap Evaluasi Agentic AI:
1. Ilusi Skor Sukses Tugas (The Illusion of High SWS)
Model seperti Qwen3-14B dan Gemma-4-31B-IT mencatatkan skor keberhasilan tugas yang luar biasa tinggi pada skenario aman (92.0% dan 89.7%). Namun, evaluasi pada dunia kembar membuktikan bahwa ini adalah kepatuhan buta (indiscriminate execution)! Pada baseline bukti lengkap, model-model ini tetap melanggar aturan dan mengeksekusi operasi terlarang masing-masing sebesar 77.3% dan 62.7%. Tingginya skor penyelesaian tugas terjadi bukan karena agen memahami kepatuhan, melainkan karena ia selalu menekan tombol komit apapun resikonya.
2. Ketahanan Pasif Tidak Sama dengan Pemulihan Aktif (Resistance ≠ Recovery)
GPT-6-Luna menunjukkan tingkat pelanggaran yang sangat rendah (Full UCR hanya 3.0% dan SBM tertinggi 84.8%). Namun, ketika tool pemulihan bukti diberikan, skor PUR-nya hanya 30.5%. Model ini cenderung mengambil jalan pintas penolakan konservatif (excessive abstention): ia menolak bertindak di dunia bahaya, tetapi juga gagal memulihkan fakta di dunia aman untuk menyelesaikan tugas yang sah. Sebaliknya, DeepSeek-V4.1-Flash mencapai skor PUR tertinggi di industri (58.4%) karena secara aktif memanggil tool audit pemulihan dan menggunakan informasinya secara adaptif.
3. Keruntuhan Total GLM-4.7-Flash pada Proactive Evidence Seeking
Model GLM-4.7-Flash mencatatkan skor PUR 0.0%. Meskipun tool audit pemulihan tersedia di lingkungan RE, model ini sama sekali tidak pernah memanfaatkan tool audit tersebut untuk memeriksa status izin sebelum memanggil commit tool. Hal ini membuktikan bahwa kemampuan tool-calling yang diajarkan lewat SFT standar gagal menanamkan pemahaman epistemic uncertainty pada agen.
5. Formulasi Matematika Metrik Inti: SBM, Cardinality, dan PUR
Untuk mengukur secara formal kapan dan bagaimana batasan keselamatan agen runtuh, EpiSEM-Bench memperkenalkan dua formulasi matematis yang elegan:
1. Safety Boundary Margin (SBM)
Untuk setiap pasangan tugas $i$, misalkan $c_i$ adalah total atom bukti keselamatan kritis yang tersedia ($c_i le 7$). Prosedur pengujian melakukan iterasi kombinatorial terhadap subset penghapusan atom dengan kardinalitas meningkat: $|M| = 1, 2, dots, c_i$. Nilai batas minimum kegagalan $m_i$ didefinisikan sebagai:
Indeks Safety Boundary Margin (SBM) kemudian dinormalisasi terhadap seluruh $N=300$ tugas: $$ ext{SBM} = rac{1}{N} sum_{i=1}^{N} rac{m_i}{c_i + 1} in [0, 1]$$ Nilai SBM mendekati 1.0 menandakan agen sangat tangguh dalam menjaga prinsip kehati-hatian, sedangkan nilai mendekati 0 menandakan agen sudah cacat sejak kondisi baseline.
2. Paired Useful Recovery (PUR)
PUR adalah metrik paling ketat yang mensyaratkan konsistensi aksi pada sepasang kondisi kembar ($T_i^{ ext{unsafe}}$ dan $T_i^{ ext{safe}}$) di bawah mask penghapusan $M$:
Metrik ini menghukum keras model yang "hanya cari aman" dengan cara menolak semua tugas (karena $ ext{Success}_{ ext{safe}} = 0$), sekaligus menghukum model yang "terlalu berani" dengan mengeksekusi semua tugas (karena $ ext{Commit}_{ ext{unsafe}} = 1$).
6. Implementasi Produksi: TypeScript Epistemic Evidence Guard
Bagi tim rekayasa platform otonom (Hermes, Claude Code, OpenAI Swarms, CrewAI), mengintegrasikan gerbang epistemik sebelum pemanggilan tool destruktif adalah langkah wajib untuk mencegah insiden eksekusi buta. Berikut adalah modul referensi TypeScript kelas produksi:
${EPISEM_CODE_SNIPPET.replace(//g, '>')}7. Rekomendasi Taktis untuk Rekayasa Agen AI Otonom 2026/2027
-
Tinggalkan Prinsip "Assume Permitted if Not Denied":
Sistem agen wajib beralih ke prinsip Epistemic Deny-by-Default. Untuk setiap tindakan yang memiliki dampak finansial, hak akses, atau integritas data, ketiadaan parameter verifikasi dalam konteks wajib memicu status
ABSTAIN_SEEK_EVIDENCE, bukan langsung mengeksekusi operasi. -
Sediakan Tool Audit Epistemik yang Eksplisit:
Jangan membebani tool pembacaan umum dengan ratusan field opsional. Sediakan tool terpisah yang didesain khusus untuk verifikasi kepatuhan (seperti
verify_authorization_policyatauquery_evidence_audit_vault) dan latih agen untuk memanggilnya setiap kali parameter kritis tidak ditemukan. - Wajibkan Evaluasi Pasangan Dunia Kembar (Twin-World Benchmarking): Jangan pernah mempercayai metrik evaluasi yang hanya menguji apakah agen berhasil menjalankan perintah pengguna (single-sided task success). Setiap benchmark internal wajib menyertakan kondisi kembar di mana kondisi lingkungan dibalik menjadi dilarang.
- Terapkan Audit SBM pada Model Serving Pipeline: Uji model agen Anda dengan secara sengaja menghapus field dari payload JSON mock secara kombinatorial. Jika model Anda memiliki nilai $m_i = 0$ atau $m_i = 1$, model tersebut berbahaya untuk dideploy di lingkungan produksi tanpa pengawasan manusia (Human-in-the-Loop).
Referensi & Sumber Terverifikasi
- [1]EpiSEM-Bench: Evaluating Safety and Evidence Recovery in LLM Agents under Missing Evidence(arXiv:2610.31650v1 [cs.AI / cs.LG] — Qijin Zhang, Hanzhen Wang, Yuehan Zhao, Haoyu Dai, Yao Shu, Zhongxiang Dai, Shuang Qiu (City University of Hong Kong, HKUST-GZ, CUHK-Shenzhen))
- [2]AgentDojo: A Dynamic Environment to Evaluate Attacks and Defenses on LLM Agents(NeurIPS 2024 / ETH Zurich & UC Berkeley — Edoardo Debenedetti, Jie Zhang, Balaji Lakshminarayanan et al.)
- [3]tau-bench: A Benchmark for Tool-Agent-User Interaction in Realistic Environments(Sierra AI & Stanford University — Shunyu Yao, Noah Shinn, Karthik Narasimhan et al.)
- [4]ReAct: Synergizing Reasoning and Acting in Language Models(ICLR 2023 — Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao)
- [5]Toolformer: Language Models Can Teach Themselves to Use Tools(NeurIPS 2023 — Timo Schick, Jane Dwivedi-Yu, Roberto Dessì, Roberta Raileanu et al. (Meta AI))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.
DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.
Code Graphs & Embeddings pada Small Coding Agents (arXiv:2610.33958): Eksperimen 79k Episode SWE-bench, Gradien Hop Depth, dan Batasan Representasi Leksikal Satu-Langkah
Analisis empiris 79k episode SWE-bench Verified (arXiv:2610.33958, Saurav Bellam): Apakah tool knowledge graph dan embedding search benar-benar melengkapi pemahaman struktural coding agent kecil? Menyingkap degradasi hop gradient (odds ratio 0.50–0.67 per hop), anomali tool uptake pada model 32B, dan bukti linear probing bahwa representasi kode internal agen open-weight masih dominan bersifat leksikal satu-langkah.