GEPA-Curator (arXiv:2610.37651): Mengeliminasi Halusinasi Refleksi pada Self-Improving AI Agents via Adaptive Task Curation, Contrastive Prior Success, dan Meta-Harness Optimization
Analisis arsitektural riset frontier UC Berkeley, Furiosa AI, dan KAIST (arXiv:2610.37651, Zack Yu, Nicholas Lee, Matei Zaharia, Amir Gholami): Mengapa optimasi prompt reflektif (GEPA, ACE) rentan mengalami misatribusi kegagalan akibat keterbatasan harness dan kelemahan lingkungan eksternal, bagaimana GEPA-Curator menyaring tugas bising via Adaptive Task Curation dan menyajikan trajektori sukses kontrastif (Prior Success Retrieval), menghasilkan lonjakan akurasi hingga +21.2% di AppWorld dan WebArena, serta implementasi outer-loop harness siap produksi.
Dalam lanskap pengembangan agen otonom masa kini, Recursive Self-Improvement (RSI) melalui optimasi prompt reflektif telah menjadi standar emas untuk meningkatkan kemampuan reasoning dan eksekusi tool tanpa perlu melakukan fine-tuning bobot model dasar yang mahal. Namun, riset terobosan dari UC Berkeley, Furiosa AI, dan KAIST bertajuk arXiv:2610.37651 (GEPA-Curator: Curated Learning for Self Improving Agents) mengungkap paradoks fatal: pada beban kerja agen nyata yang kompleks (seperti WebArena, AppWorld, dan τ-bench), kegagalan eksekusi lebih sering dipicu oleh flakiness lingkungan, bug harness, atau bias evaluator (noisy judge) daripada kelemahan prompt itu sendiri.
Executive Architectural Briefing
Ketika modul Reflector mengasumsikan setiap kegagalan bersumber dari prompt, sistem mengalami halusinasi refleksi—menghasilkan mutasi prompt yang rumit, saling bertentangan, dan merusak performa tugas-tugas lain. GEPA-Curator memecahkan kebuntuan ini dengan menyematkan arsitektur kurasi cerdas dua cabang: Adaptive Task Curation yang menyingkirkan tugas-tugas bising dari minibatch optimasi, dan Prior Success Retrieval yang menyajikan trajektori sukses historis sebagai jangkar diagnosis kontrastif. Hasilnya: lonjakan akurasi hingga +21.2% di AppWorld dan konsistensi lintas optimizer model (Gemini 3.1 Pro & Claude Opus 5).
1. Akar Masalah: Dilema Misatribusi & Halusinasi Refleksi pada Prompt Optimizer
Kerangka optimasi prompt otomatis terdahulu—seperti GEPA (Generalized Execution trace Aggregation), ACE, dan TextGrad—bekerja dengan siklus tertutup: agen mengeksekusi sekumpulan tugas, modul Reflector membaca jejak trajektori kegagalan, menyusun hipotesis perbaikan, lalu melakukan mutasi instruksi sistem (system prompt).
Premis ini mengasumsikan bahwa lingkungan eksekusi bersifat deterministik dan evaluasi bersifat bebas cacat. Namun pada kenyataan rekayasa perangkat lunak dan interaksi browser:
Flakiness Lingkungan & Web Crash
Tombol UI belanja yang tidak merespons, elemen DOM yang lambat termuat, atau koneksi WebSocket yang terputus sering disangka Reflector sebagai kegagalan agen dalam memahami instruksi.
Keterbatasan Harness & Tool Sandbox
Ketika runtime harness Python atau CLI membatasi permission file atau kehabisan alokasi memori, Reflector menyimpulkan agen memerlukan aturan logika baru, memicu instruksi kontradiktif.
Bias & Ketidakkonsistenan LLM Judge
Evaluasi berbasis LLM-as-a-judge sering memberikan nilai kelulusan acak pada dua trajektori yang identik secara fungsional, mencemari gradien tekstual dengan umpan balik palsu.
Akibatnya, ketika dihadapkan pada tugas belanja di mana tombol checkout sedang mengalami kegagalan server, modul Reflector konvensional menambahkan instruksi spekulatif: "Jika tombol beli gagal, lakukan pencarian alternatif atau refresh halaman berulang kali." Instruksi bising ini kemudian merusak efisiensi agen pada tugas-tugas belanja berikutnya yang sistem checkout-nya berfungsi normal.
2. Mengapa Validation Gating & Pareto Selection Saja Tidak Cukup?
Untuk mengatasi masalah di atas, sistem seperti GEPA dan ACE mengandalkan Validation-Based Gating: mutasi prompt baru hanya diterima jika skor rata-rata pada validation set meningkat atau mempertahankan Pareto frontier. Namun, tim peneliti UC Berkeley membuktikan bahwa mekanisme kurasi pasca-mutasi (post-hoc gating) ini memiliki dua cacat struktural:
Skor Agregat Menutupi Regresi Parsial
Stokastisitas eksekusi menyebabkan mutasi yang buruk dapat lolos secara kebetulan karena keberuntungan statistik pada 1-2 tugas validasi, sementara mutasi berkualitas tinggi ditolak karena variansi acak.
Gating Tidak Memperbaiki Kualitas Refleksi Itu Sendiri
Penyaringan pasca-kejadian hanya menentukan apakah suatu prompt diterima atau ditolak; ia tidak dapat mencegah Reflector membuang-buang token reasoning mahal untuk menghasilkan mutasi yang didasari data masukan cacat sejak awal.
3. Arsitektur GEPA-Curator: Outer-Loop Intelligence Stack
GEPA-Curator mengubah paradigma optimasi dengan menyisipkan modul Curator otonom yang bertindak sebagai outer-loop harness di atas prompt optimizer:
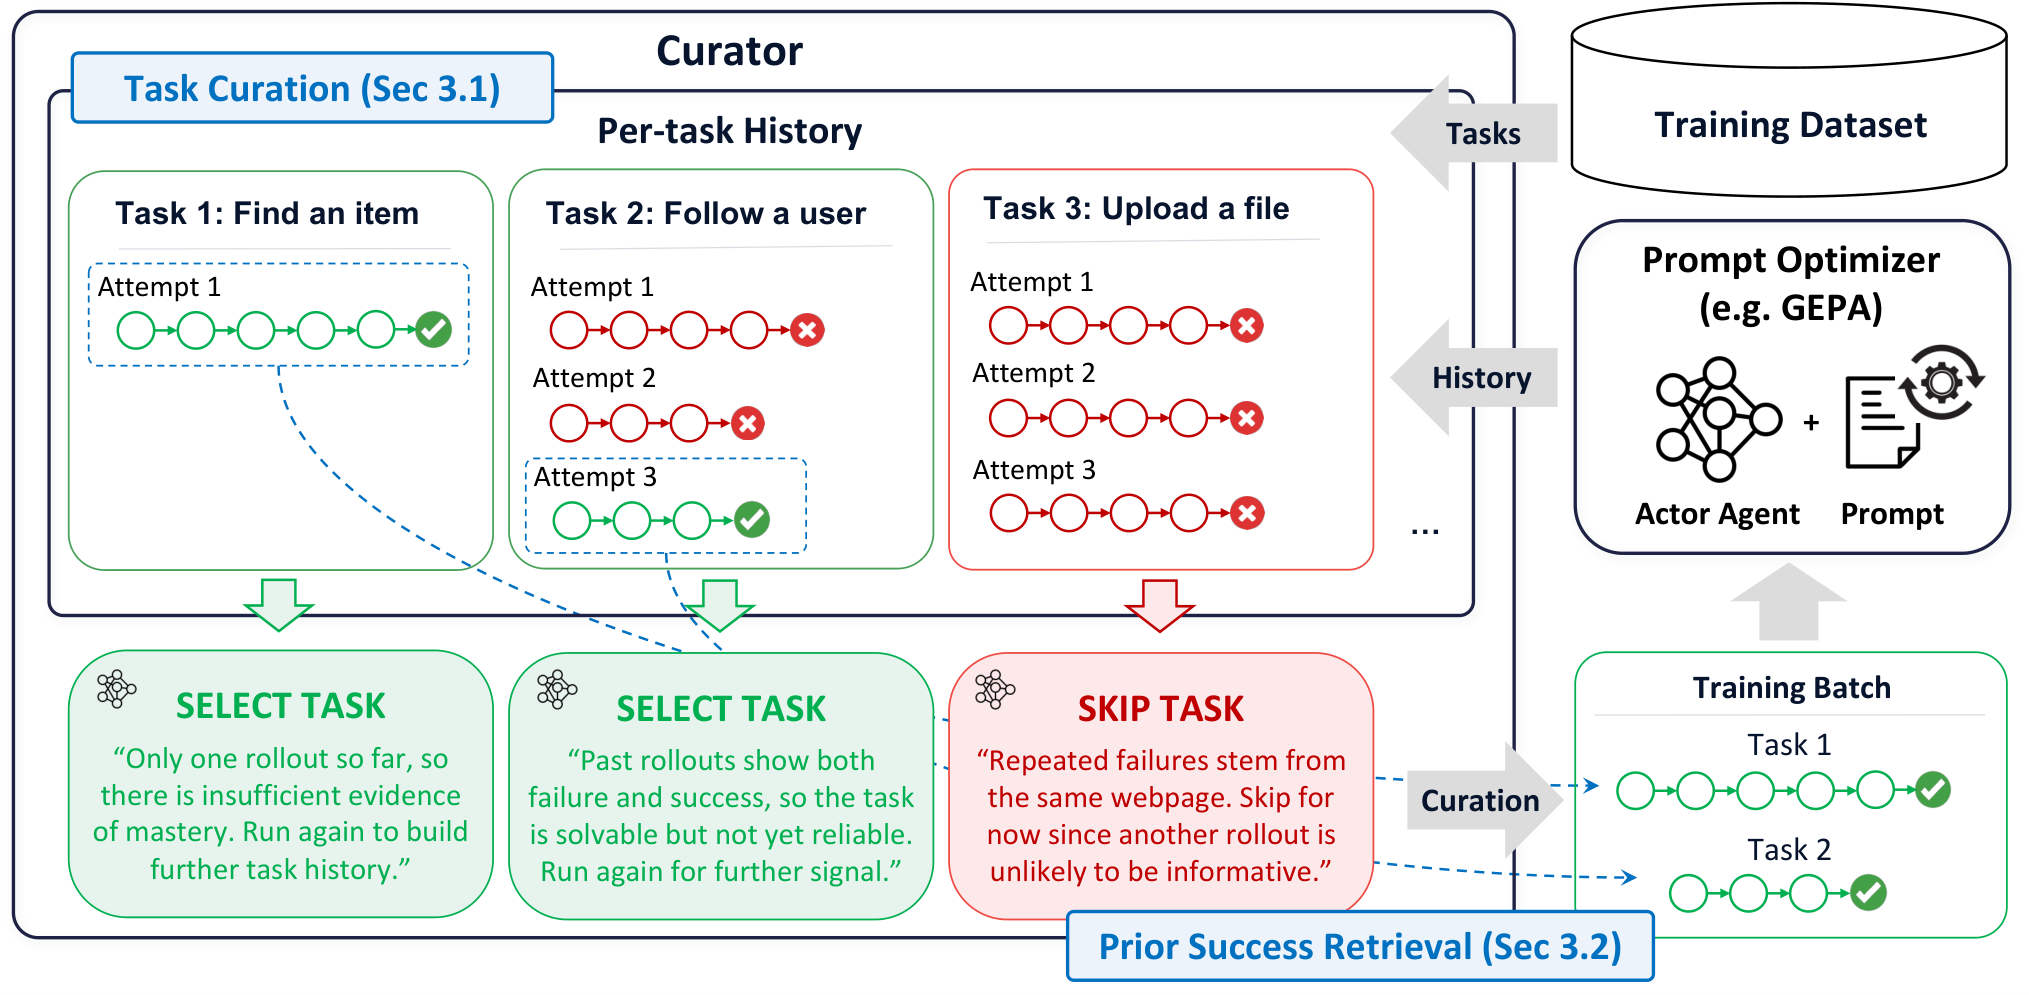
Gambar 1: Alur Kerja GEPA-Curator — Task Curation menyaring minibatch pelatihan dan Prior Success Retrieval menyajikan referensi trajektori sukses masa lalu ke Prompt Reflector (arXiv:2610.37651).
Adaptive Task Curation
Curator memantau riwayat trajektori kumulatif tiap task dari epoch ke epoch. Task baru (underexplored) selalu diprioritaskan. Ketika data riwayat mencukupi, Curator secara selektif men-skip tugas-tugas yang tidak produktif:
- Stable Success: Task yang konsisten berhasil tidak perlu diulang, mencegah prompt mengalami overfitting pada skenario yang sudah dikuasai.
- Isolated Environment Fault: Task dengan catatan kegagalan persisten akibat faktor eksternal (harness bug atau crash server web) disingkirkan agar tidak mencemari analisis.
- Dynamic Re-evaluation: Keputusan skip bersifat sementara (tidak permanen). Di setiap pergantian epoch pelatihan, tugas yang di-skip dievaluasi ulang untuk memastikan tidak terjadi regresi fungsional.
Prior Success Retrieval (Contrastive Grounding)
Alih-alih membiarkan Reflector menebak-nebak penyebab kegagalan dari trajektori error semata, Curator menelusuri memori arsip untuk menemukan trajektori sukses masa lalu dari task tersebut.
Dengan menyandingkan trajektori gagal dengan trajektori sukses sebagai ground-truth reference, Reflector dapat melakukan Contrastive Analysis secara presisi: mengidentifikasi secara pasti di step mana model mengalami deviasi logika, sehingga mutasi prompt terarah secara deterministik.
Proses Task Curation dan Prior Success Retrieval dieksekusi secara bersamaan dalam satu kali pemanggilan LLM Curator per minibatch, menghilangkan beban komputasi tambahan.
4. Hasil Evaluasi Empiris: Lompatan Performa pada WebArena & AppWorld
Evaluasi dilakukan pada aktor agen gpt-oss-120b dengan dua model optimizer frontier berbeda: Gemini 3.1 Pro dan Claude Opus 5, melintasi 4 lingkungan web di GoBrowse (WebArena) dan 3 benchmark agen kompleks (ALFWorld, AppWorld, dan τ-bench).
| Metode Optimasi | GitLab (720 Tasks) | Shopping (585 Tasks) | Shopping Admin (750) | Reddit (585 Tasks) | Rata-Rata Agregat |
|---|---|---|---|---|---|
| Seed Prompt (Baseline) | 78.4 ± 2.2% | 71.8 ± 2.0% | 63.7 ± 2.5% | 77.8 ± 1.4% | 72.9 ± 2.4% |
| GEPA (Agrawal et al.) | 80.8 ± 2.4% | 81.3 ± 2.7% | 72.9 ± 2.4% | 81.9 ± 1.5% | 79.5 ± 1.2% |
| GEPA-Curator (Ours) | 83.1 ± 3.9% | 86.5 ± 3.9% | 80.3 ± 2.9% | 88.2 ± 1.6% | 84.5 ± 1.0% (+5.0%) |
Keunggulan GEPA-Curator tampak semakin masif pada lingkungan multi-turn coding dan interaksi API di AppWorld:
| Optimizer Model | Metode | ALFWorld | AppWorld (Test-N) | AppWorld (Test-C) | τ-bench |
|---|---|---|---|---|---|
| Gemini 3.1 Pro | GEPA | 82.4 ± 2.9% | 38.0 ± 2.3% | 27.8 ± 2.1% | 75.4 ± 5.2% |
| ACE | 90.1 ± 1.3% | 55.7 ± 1.8% | 34.5 ± 1.4% | 80.6 ± 6.6% | |
| GEPA-Curator | 91.8 ± 1.4% | 58.7 ± 1.9% (+20.7%) | 46.2 ± 2.1% (+18.4%) | 84.0 ± 4.8% | |
| Claude Opus 5 | GEPA | 95.8 ± 1.4% | 52.9 ± 5.7% | 32.5 ± 2.7% | 82.9 ± 2.0% |
| ACE | 89.7 ± 2.7% | 61.2 ± 1.7% | 33.4 ± 0.8% | 61.7 ± 5.9% | |
| GEPA-Curator | 98.4 ± 0.6% | 68.8 ± 1.9% (+15.9%) | 46.4 ± 1.1% (+13.9%) | 82.9 ± 2.9% |
5. Analisis Ablasi: Sinergi Task Curation dan Prior Success
Eksperimen kontrol pada 200 tugas validasi GitLab membuktikan kontribusi esensial dari masing-masing komponen:
Menghindari mutasi bising, namun Reflector masih harus menebak penyebab kegagalan tanpa referensi sukses.
Menyediakan context grounded, namun minibatch masih tercemar oleh tugas yang rusak di tingkat harness.
Sinergi optimal: data training bersih disandingkan dengan referensi kontrastif yang tak terbantahkan.
6. Ekstensi Meta-Harness: Mengoptimasi Kode Harness Agen Secara Otonom
Inovasi paling radikal dalam paper ini adalah pengujian konsep kurasi di luar ranah prompt textual, yaitu pada sistem Meta-Harness. Di sini, optimizer tidak memodifikasi prompt, melainkan merevisi langsung kode program Python yang menjadi execution harness bagi agen.
Pada evaluasi penalaran matematika frontier ArXivMath, Meta-Harness standar hanya meraih akurasi 26.09%. Ketika diaugmentasi dengan kurasi agen (MH-Curator), sistem mampu menyaring kegagalan parser sintaks dan menaikkan akurasi hingga 34.78%—membuktikan bahwa prinsip kurasi pengalaman adalah hukum fundamental bagi segala bentuk perbaikan diri otonom (RSI).
7. Implementasi Rekayasa: Outer-Loop Curator Harness Siap Produksi
Berikut adalah implementasi arsitektur GEPACuratorEngine modular dalam TypeScript untuk disematkan pada pipeline agen otonom di lingkungan enterprise:
// Production Implementation: GEPA-Curator Outer-Loop Harness
// Mengeliminasi "Reflection Hallucination" pada Recursive Self-Improvement (RSI) Agents
// Berdasarkan Prinsip Rekayasa arXiv:2610.37651 (UC Berkeley, Furiosa AI, KAIST)

export interface AgentStepTrace {
  step: number;
  action: string;
  observation: string;
  toolCallId?: string;
  status: 'success' | 'client_error' | 'env_failure' | 'timeout';
}

export interface TaskTrajectory {
  taskId: string;
  epoch: number;
  promptVersion: string;
  steps: AgentStepTrace[];
  isSuccess: boolean;
  score: number;
  failureCategory?: 'prompt_defect' | 'harness_bug' | 'env_outage' | 'noisy_judge';
  rawFeedback?: string;
  timestamp: number;
}

export interface TaskCurationMeta {
  taskId: string;
  totalRollouts: number;
  consecutiveSuccesses: number;
  consecutiveFailures: number;
  hasPersistentEnvFault: boolean;
  judgeInconsistencyRatio: number;
  lastCuratorStatus: 'RUN' | 'SKIP_STABLE' | 'SKIP_ENV_FAULT' | 'SKIP_NOISY_EVAL';
}

export interface ContrastiveReflectionPair {
  taskId: string;
  failedTrajectory: TaskTrajectory;
  anchorSuccessfulTrajectory?: TaskTrajectory;
  curatorDiagnosticNotes: string;
}

export class GEPACuratorEngine {
  private readonly historyStore = new Map();
  private readonly metadataStore = new Map();

  constructor(
    private readonly config: {
      stableSuccessThreshold: number;      // e.g. 3 consecutive passes
      persistentEnvFaultThreshold: number; // e.g. 3 consecutive identical harness/env errors
      inconsistentJudgeThreshold: number;  // e.g. > 0.4 score variance on identical actions
      minExplorationRounds: number;        // e.g. 2 minimum tries before eligible to skip
    } = {
      stableSuccessThreshold: 3,
      persistentEnvFaultThreshold: 3,
      inconsistentJudgeThreshold: 0.35,
      minExplorationRounds: 2,
    }
  ) {}

  /**
   * Menganalisis riwayat task untuk menentukan apakah task memberikan sinyal gradien bersih
   * atau harus di-skip sementara untuk mencegah pencemaran prompt.
   */
  public evaluateTaskEligibility(taskId: string): { action: 'RUN' | 'SKIP'; reason: string } {
    const history = this.historyStore.get(taskId) || [];

    // Prioritas 1: Selalu eksplorasi task baru yang belum memiliki riwayat cukup
    if (history.length < this.config.minExplorationRounds) {
      return { action: 'RUN', reason: 'INSUFFICIENT_HISTORY_EXPLORATION_REQUIRED' };
    }

    const meta = this.getOrInitMeta(taskId);

    // Kriteria 1: Stable Success (Task sudah mantap terselesaikan, tidak memberi gradien baru)
    if (meta.consecutiveSuccesses >= this.config.stableSuccessThreshold) {
      meta.lastCuratorStatus = 'SKIP_STABLE';
      return {
        action: 'SKIP',
        reason: `STABLE_SUCCESS: Lolos ${meta.consecutiveSuccesses}x beruntun. Jangan overfit prompt.`
      };
    }

    // Kriteria 2: Persistent Harness/Environment Failure (Tombol web rusak, API timeout)
    if (meta.hasPersistentEnvFault && meta.consecutiveFailures >= this.config.persistentEnvFaultThreshold) {
      meta.lastCuratorStatus = 'SKIP_ENV_FAULT';
      return {
        action: 'SKIP',
        reason: 'ENV_FAILURE_ISOLATED: Kerusakan infrastruktur/web button, bukan cacat prompt.'
      };
    }

    // Kriteria 3: Evaluasi Tidak Konsisten (Noisy LLM-as-a-judge)
    if (meta.judgeInconsistencyRatio > this.config.inconsistentJudgeThreshold) {
      meta.lastCuratorStatus = 'SKIP_NOISY_EVAL';
      return {
        action: 'SKIP',
        reason: 'NOISY_EVAL_DISCARDED: Skor LLM judge bertentangan pada trajektori serupa.'
      };
    }

    meta.lastCuratorStatus = 'RUN';
    return { action: 'RUN', reason: 'CLEAN_OPTIMIZATION_SIGNAL' };
  }

  /**
   * Mengambil trajektori sukses masa lalu yang paling valid sebagai jangkar (anchor)
   * untuk refleksi kontrastif bagi Reflector.
   */
  public retrievePriorSuccess(taskId: string): TaskTrajectory | undefined {
    const history = this.historyStore.get(taskId) || [];
    const successes = history.filter(t => t.isSuccess && t.score >= 1.0);

    if (successes.length === 0) return undefined;

    // Utamakan trajektori sukses dengan langkah terpendek dan verifikasi terbersih
    return successes.sort((a, b) => a.steps.length - b.steps.length)[0];
  }

  /**
   * Menyusun curated minibatch untuk dikirimkan ke Prompt Reflector
   */
  public buildCuratedBatch(candidateTaskIds: string[]): {
    curatedTaskIds: string[];
    skippedTaskIds: { id: string; reason: string }[];
  } {
    const curated: string[] = [];
    const skipped: { id: string; reason: string }[] = [];

    for (const taskId of candidateTaskIds) {
      const decision = this.evaluateTaskEligibility(taskId);
      if (decision.action === 'RUN') {
        curated.push(taskId);
      } else {
        skipped.push({ id: taskId, reason: decision.reason });
      }
    }

    return { curatedTaskIds: curated, skippedTaskIds: skipped };
  }

  /**
   * Menghasilkan konteks refleksi kontrastif terpadu untuk LLM Reflector
   */
  public assembleContrastiveContext(
    failedRun: TaskTrajectory
  ): ContrastiveReflectionPair {
    const priorSuccess = this.retrievePriorSuccess(failedRun.taskId);

    let diagnostic = '';
    if (priorSuccess) {
      diagnostic = `ANALYTIC CONTRAST AVAILABLE: Task ${failedRun.taskId} pernah berhasil diselesaikan pada epoch ${priorSuccess.epoch} dalam ${priorSuccess.steps.length} langkah. Bandingkan titik divergensi aksi pada step kegagalan saat ini.`;
    } else {
      diagnostic = `NO_PRIOR_SUCCESS_ANCHOR: Belum ada referensi sukses terverifikasi. Refleksi berbasis analisa heuristik murni.`;
    }

    return {
      taskId: failedRun.taskId,
      failedTrajectory: failedRun,
      anchorSuccessfulTrajectory: priorSuccess,
      curatorDiagnosticNotes: diagnostic,
    };
  }

  /**
   * Mencatat hasil eksekusi baru dan memperbarui profil statistik task
   */
  public recordExecution(trajectory: TaskTrajectory): void {
    const list = this.historyStore.get(trajectory.taskId) || [];
    list.push(trajectory);
    this.historyStore.set(trajectory.taskId, list);

    const meta = this.getOrInitMeta(trajectory.taskId);
    meta.totalRollouts += 1;

    if (trajectory.isSuccess) {
      meta.consecutiveSuccesses += 1;
      meta.consecutiveFailures = 0;
      meta.hasPersistentEnvFault = false;
    } else {
      meta.consecutiveFailures += 1;
      meta.consecutiveSuccesses = 0;
      if (trajectory.failureCategory === 'env_outage' || trajectory.failureCategory === 'harness_bug') {
        meta.hasPersistentEnvFault = true;
      }
    }
  }

  private getOrInitMeta(taskId: string): TaskCurationMeta {
    if (!this.metadataStore.has(taskId)) {
      this.metadataStore.set(taskId, {
        taskId,
        totalRollouts: 0,
        consecutiveSuccesses: 0,
        consecutiveFailures: 0,
        hasPersistentEnvFault: false,
        judgeInconsistencyRatio: 0,
        lastCuratorStatus: 'RUN',
      });
    }
    return this.metadataStore.get(taskId)!;
  }
}
8. Panduan Rekayasa Praktis untuk Tim AI Engineering
Bagi arsitek sistem yang sedang merancang pipeline recursive self-improvement atau agentic evaluation loop:
Pisahkan Diagnosis Kegagalan dari Refleksi Prompt
Jangan pernah membiarkan modul pembuat prompt menentukan sendiri apakah suatu error merupakan kesalahan prompt atau kesalahan tool. Bangun lapisan isolasi berbasis log exit code, status HTTP, dan DOM error sebelum trajektori diserahkan ke Reflector.
Gunakan Exemplar Kontrastif untuk Tiap Refleksi
Refleksi tanpa contoh sukses masa lalu adalah spekulasi buta. Simpan trajektori emas (golden run) di vector database atau key-value store, dan sajikan pasangan (Gagal vs Sukses) saat memanggil model optimizer.
Terapkan Siklus Evaluasi Ulang Dinamis (Epoch-Based)
Tugas yang di-skip karena keterbatasan masa lalu tidak boleh dibuang selamanya. Setiap kali prompt atau harness diperbarui, uji kembali subset tugas yang sebelumnya gagal untuk menangkap peluang generalisasi baru.
Referensi & Sumber Terverifikasi
- [1]GEPA-Curator: Curated Learning for Self Improving Agents(arXiv:2610.37651 [cs.CL] — Zack Yu, Nicholas Lee, Minjae Lee, Lakshya Agarwal, Luca Manolache, Wonjun Kang, Matei Zaharia, Michael W. Mahoney, Kurt Keutzer, Sehoon Kim, Amir Gholami (UC Berkeley, Furiosa AI, KAIST, ICSI, LBNL))
- [2]GEPA: Reflective Prompt Optimization for Multi-Agent Systems with Generalized Execution Trace Aggregation(arXiv — Lakshya Agarwal et al. (UC Berkeley & Stanford))
- [3]WebArena: A Realistic Web Environment for Building Autonomous Agents(ICLR — Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Grayson Ridgeway, Graham Neubig (Carnegie Mellon University))
- [4]AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents(ACL — Harsh Trivedi, Niranjan Balasubramanian et al. (Stony Brook University))
- [5]Meta-Harness: Automated Test Harness Synthesis and Optimization for Multi-Turn Agentic Benchmarks(arXiv — Nicholas Lee, Matei Zaharia et al. (Stanford IRIS Lab & UC Berkeley))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Economics of Reasoning Effort pada LLM Agents (arXiv:2610.34491): Dilema Credence Good, Inflasi Biaya 42x, Regresi Akurasi Instance-Level, dan Arsitektur Adaptive Escalation
Analisis arsitektural dan implikasi rekayasa dari riset arXiv:2610.34491 (Kaiser Sun, Yongchan Kwon, Zain Hasan, Shang Zhu, Kaitlyn Zhou, Federico Bianchi): Mengapa reasoning effort merupakan credence good ekonomi yang memicu inflasi biaya hingga 42x pada tugas mudah, mengapa set solusi tidak bersarang (non-nested regressions), fenomena hyper-verification pada trajektori agen o1/o3/R1, dan implementasi arsitektur adaptive laddering escalation siap produksi.
DecisionRAG (arXiv:2610.35868): Retriever-Free Retrieval via Decision Models — Eliminasi Capability Asymmetry, Hierarchical Tree Navigation, dan Rekor +17.4% Hit@1 Tanpa Indeks Vektor
Analisis arsitektur DecisionRAG (arXiv:2610.35868, Chao Wan, Paul Jünger, Beixi Du, Bodong Liu, Navaneetha Krishnan, Kilian Q. Weinberger — Cornell University & ASAPP): Mengapa retrieval konvensional (BM25, dense embeddings) menciptakan capability asymmetry terhadap LLM generator modern, dan bagaimana DecisionRAG menavigasi struktur korpus bertingkat menggunakan model keputusan (decision models) dalam konteks bersama (shared context) tanpa token generasi, menghasilkan lompatan +13.8 R@1 di MultiDoc2Dial, +17.4 Hit@1 di Natural Questions, dan latensi secepat 0.68 detik.
DynaFlow (arXiv:2610.34467): Free-Form Multi-Agent Orchestration — Sintesis Alur Kerja Eksekutabel, Eliminasi Defek Aliran Informasi, dan Lonjakan Akurasi 88.08% Tanpa Mengubah Bobot Sub-Agent
Analisis arsitektur DynaFlow (arXiv:2610.34467, Ruhao Liu et al., NUS): Mengapa topologi multi-agent statis memicu overhead komunikasi berlebihan, dan bagaimana integrasi sintesis alur kerja bebas ke dalam ruang aksi Main Agent — dikombinasikan dengan Two-Stage SFT dan kurasi 3 defek orkestrasi — menghasilkan akurasi 88.08% serta memecahkan 100% soal AIME dengan sub-agent berbobot beku.