UndoBench 2026: Memisahkan Task Competence dari Recovery Capability pada AI Agents, Bahaya Naive Retry, dan Arsitektur Fault Recovery Lintas 8 Domain Enterprise
Analisis mendalam riset frontier arXiv:2610.05622 (Dolly Sah, Tanmay Sah, Harshul Jain, & Tanya Sah, Oktober 2026): Mengapa benchmark agen otonom populer (SWE-bench, GAIA) menyesatkan industri dengan hanya mengukur nominal task completion pada kondisi ideal. Memperkenalkan UndoBench, benchmark counterfactual 36 alur kerja dan 36 skenario kegagalan lintas 8 domain enterprise dengan wire-level effect oracles. Mengungkap temuan kritis di mana nominal competence mencapai 83.54% namun Conditional Recovery Success Rate (CRSR) anjlok ke 46.72%, dengan 53.33% naive retry memicu duplicate external effects fatal (double charging & orphaned cloud resources). Dilengkapi panduan arsitektur produksi SAGA compensation, server-side idempotency, dan read-before-retry pattern.
Executive Summary: Mengapa Benchmark Agen Populer Menyesatkan Industri & Bagaimana Memisahkan Task Competence dari Recovery Capability
Makalah riset fundamental arXiv:2610.05622 (Oktober 2026) berjudul "UndoBench: Separating Task Competence from Recovery Capability in Tool-Using AI Agents" karya Dolly Sah, Tanmay Sah, Harshul Jain, dan Tanya Sah membongkar ilusi terbesar dalam adopsi agen otonom di skala enterprise: evaluasi task completion standar (nominal competence) menyembunyikan kerapuhan katastropik saat sistem menghadapi kegagalan operasional nyata di dunia industri.
Benchmark populer saat ini seperti SWE-bench, GAIA, dan AgentBench mengevaluasi agen hampir secara eksklusif pada nominal happy-path: instruksi diberikan, agen memanggil perkakas, dan hasil akhir dicocokkan dengan kriteria keberhasilan. Pendekatan ini mencampuradukkan baseline planning competence (kemampuan menyusun rencana logis) dengan operational fault recovery (kemampuan memulihkan diri saat dependensi eksternal, jaringan, atau basis data mengalami kegagalan).
UndoBench memperkenalkan metodologi evaluasi counterfactual paired trials dengan identical seeds pada 36 base workflows dan 36 skenario kegagalan lintas 8 domain enterprise (keuangan, e-commerce, cloud infra, CRM, billing, inventaris, direktori SDM, dan logistik). Melalui 5.760 eksekusi terisolasi dengan oracle jejak efek pada tingkat jaringan (wire-level effect oracles), temuan riset ini menggetarkan arsitektur software: model frontier yang mencatatkan nominal competence 83.54% mengalami kejatuhan drastis hingga Conditional Recovery Success Rate (CRSR) 46.72% saat terjadi fault. Yang lebih berbahaya, pendekatan naive retry (mencoba ulang pemanggilan fungsi tanpa state verification) menghasilkan duplicate external effects pada 53.33% pengujian—memicu tagihan kartu kredit ganda, duplikasi transfer bank, dan terciptanya sumber daya cloud yang terbengkalai.
Daftar Isi Pembahasan Arsitektur UndoBench
- 1. Ilusi Nominal Competence: Mengapa Happy-Path Benchmark Menjadi Titik Buta Enterprise
- 2. Metodologi UndoBench: Counterfactual Paired Trials & Wire-Level Effect Oracles
- 3. Dekomposisi Tiga Fase Eksekusi: Pre-Mutation, Partial Mutation, dan Lost-Acknowledgment
- 4. Analisis Kegagalan Empiris: Mengapa Naive Retry Memicu Bencana Duplikasi Efek
- 5. Evaluasi Tiga Paradigma Pemulihan: Journaling, SAGA Compensation, dan Server-Side Idempotency
- 6. Implementasi Referensi Produksi: Resilient Agent Harness & Read-Before-Retry Engine (TypeScript)
- 7. Rekomendasi Rekayasa 2026: Blueprint Desain Sistem Agen yang Tahan Terhadap Bencana Operasional
1. Ilusi Nominal Competence: Mengapa Happy-Path Benchmark Menjadi Titik Buta Enterprise
Dalam kurun waktu dua tahun terakhir, adopsi AI coding agents dan multi-tool autonomous workflows telah merambah sektor infrastruktur krusial: perbankan core-banking, provisi cluster Kubernetes, mutasi inventaris e-commerce, hingga alur kerja persetujuan faktur korporat. Metrik yang selama ini dijadikan standar acuan oleh industri—seperti persentase penyelesaian isu pada SWE-bench atau akurasi eksekusi tool pada GAIA—hampir seluruhnya mengukur nominal competence.
Nominal competence hanya menjawab pertanyaan: "Jika seluruh dependensi jaringan stabil, database merespons dengan HTTP 200, dan tidak ada timeout, apakah agen mampu menyelesaikan urutan aksi dengan benar?"
Namun, hukum rekayasa sistem terdistribusi menegaskan bahwa di lingkungan produksi riil:
- Koneksi TCP dapat terputus tepat setelah paket commit SQL dikirimkan ke database tetapi sebelum frame ACK sampai ke klien.
- Gateway pembayaran pihak ketiga (seperti Stripe atau Midtrans) dapat merespons dengan HTTP 504 Gateway Timeout padahal otorisasi kartu debit pengguna telah berhasil didebit.
- Operasi komposit (composite mutation) seperti
CreateUserAccount()laluAssignCloudLicense()dapat gagal di langkah kedua karena kuota lisensi habis, meninggalkan akun dalam status setengah matang (dangling state).
Ketika kegagalan ini terjadi, agen tidak dapat lagi bergantung pada prompt statis. Tanpa arsitektur recovery yang terkalibrasi, LLM agen cenderung berhalusinasi atau melakukan blind retry: mengulang kembali pemanggilan API mutasi tanpa memverifikasi apakah efek samping (side-effect) sebelumnya telah terefleksi di server target. Akibatnya, sistem enterprise menderita kerugian finansial nyata dan korupsi integritas data.
2. Metodologi UndoBench: Counterfactual Paired Trials & Wire-Level Effect Oracles
Untuk mengisolasi kapabilitas pemulihan secara saintifik, Sah et al. (2026) merancang UndoBench dengan prinsip pengujian kausal counterfactual:
| Dimensi Uji | Deskripsi Arsitektur | Tujuan Evaluasi |
|---|---|---|
| Counterfactual Paired Trials | Dua eksekusi paralel dengan seed deterministik identik: Run Nominal ($T_N$) vs Run Fault-Injected ($T_F$) | Memastikan bahwa agen yang gagal di $T_F$ benar-benar memiliki kompetensi dasar di $T_N$, sehingga kegagalan murni disebabkan oleh inkompetensi recovery. |
| Wire-Level Effect Oracles | Pencatatan setiap HTTP request, payload mutation, database statement, dan idempotency key pada lapisan network wire. | Mendeteksi mutasi ganda (duplicate external effects) yang tidak terdeteksi oleh evaluasi log agen internal. |
| 8 Enterprise Domains | Banking, E-Commerce, Kubernetes Infra, CRM, Subscriptions, Inventory, HR Directory, Logistics. | Mencakup 36 alur kerja komposit yang merefleksikan arsitektur microservices enterprise modern. |
| Conditional Recovery Success Rate (CRSR) | CRSR = P(Success in T_F | Success in T_N) | Metrik terpadu yang memfilter trial di mana agen memang tidak mampu merencanakan alur kerja dasar sejak awal. |
3. Dekomposisi Tiga Fase Eksekusi: Pre-Mutation, Partial Mutation, dan Lost-Acknowledgment
Salah satu kontribusi terpenting UndoBench adalah bukti empiris bahwa efektivitas strategi recovery sangat bergantung pada fase siklus hidup eksekusi (phase-dependent execution boundaries) ketika fault terjadi:
Sebelum Mutasi State
Fault terjadi saat tahap pembacaan data, validasi skema, atau otentikasi token. State sistem target belum mengalami modifikasi apa pun.
Mutasi Komposit Parsial
Pada alur kerja multi-langkah (misal: potong stok $ ightarrow$ buat pesanan $ ightarrow$ potong saldo), langkah 1 berhasil namun langkah 2 gagal.
Post-Commit Lost-ACK
Mutasi telah dikomit secara permanen di database backend, namun paket ACK HTTP 200 terputus di jaringan sebelum sampai ke agen.
4. Analisis Kegagalan Empiris: Mengapa Naive Retry Memicu Bencana Duplikasi Efek
Dalam studi frozen lost-acknowledgment pada 12 workflow held-out lintas model open-weight dan commercial frontier API, peneliti mendokumentasikan distribusi kegagalan yang mengejutkan:
| Paradigma Pemulihan | Nominal Competence | CRSR (Recovery Berhasil) | Duplicate Effect Ratio (DER) | Status Integritas Data |
|---|---|---|---|---|
| Naive Retry (Default ReAct / CLI) | 83.54% | 46.72% | 53.33% | Korupsi Kritis: Mutasi Ganda Meluas |
| Per-Call Idempotency Keys (Klien) | 83.54% | 58.12% | 24.18% | Gagal pada Alur Komposit Parsial |
| Zero-Privilege Journaling | 83.54% | 62.45% | 18.70% | Mendeteksi Kegagalan namun Tidak Mampu Rollback |
| UndoBench SAGA + Read-Before-Retry | 83.54% | 91.80% | 0.00% | Integritas 100% Terlindungi Tanpa Duplikasi |
Mengapa naive retry menghasilkan tingkat duplikasi hingga 53.33%? Saat agen mengirimkan perintah mutasi (misalnya charge_customer(customerId, $150)) dan menerima status error ECONNRESET atau timeout, prompt eksekusi agen menginstruksikan: "Aksi gagal, coba ulangi kembali." Agen kemudian menerbitkan pemanggilan tool yang identik dengan ID baru, menyebabkan sistem backend menjalankan transaksi untuk kedua kalinya. Karena agen tidak memiliki oracle status lingkungan, agen melaporkan tugas selesai dengan sukses tanpa menyadari bahwa saldo nasabah telah terpotong dua kali.
5. Evaluasi Tiga Paradigma Pemulihan: Journaling, SAGA Compensation, dan Server-Side Idempotency
Riset UndoBench membandingkan tiga pendekatan pemulihan operasional utama yang sering diimplementasikan dalam sistem agen modern:
- Zero-Privilege Journaling (Pencatatan Audit Pasif): Harness agen mencatat setiap niat aksi sebelum dieksekusi ke dalam log lokal. Pendekatan ini sangat efektif untuk audit forensik dan mendeteksi divergensi state, namun tidak memberikan mekanisme aktif untuk mengembalikan mutasi parsial yang terlanjur terjadi di sistem eksternal.
-
Server-Side Idempotency Keys (IETF Draft):
Setiap aksi mutasi disertai header unik
Idempotency-Keyyang diturunkan dari hash deterministik parameter tugas. Jika jaringan terputus pada fase Lost-ACK, percobaan ulang dari agen akan dikenali oleh server sebagai operasi duplikat dan server mengembalikan respons yang tersimpan di cache tanpa mengeksekusi ulang efek samping. Ini menyelesaikan masalah di Fase 3, namun tidak mampu menangani kegagalan parsial di Fase 2 di mana langkah kedua gagal karena kesalahan logika bisnis. -
Compensating Transactions (SAGA Pattern):
Setiap tool yang memiliki efek samping wajib mendaftarkan fungsi pembalik (compensating action), seperti
release_reserved_stock()sebagai pembalik darireserve_stock(). Jika workflow komposit gagal di tengah jalan, harness secara otomatis mengeksekusi rollback berantai dalam urutan terbalik (backward recovery), mengembalikan sistem ke invariant awal yang konsisten.
6. Implementasi Referensi Produksi: Resilient Agent Harness & Read-Before-Retry Engine (TypeScript)
Berikut adalah implementasi arsitektur produksi TypeScript yang menggabungkan prinsip-prinsip temuan UndoBench: integrasi deterministik SHA-256 Idempotency Keys, pola Read-Before-Retry untuk eliminasi Lost-ACK, dan SAGA Compensation Coordinator untuk proteksi alur kerja komposit.
// Production Architecture: Resilient Tool-Using Agent Harness with SAGA Compensation & State Verification
// Berdasarkan Prinsip Rekayasa UndoBench (arXiv:2610.05622)

import { crypto } from 'crypto';

export type ExecutionPhase = 'PRE_MUTATION' | 'PARTIAL_MUTATION' | 'POST_COMMIT_LOST_ACK';

export interface ToolAction {
  id: string;
  toolName: string;
  parameters: T;
  idempotencyKey: string;
  isMutating: boolean;
  compensatingAction?: (params: T, executionResult: R) => Promise;
  verifyStateOracle?: (params: T) => Promise<{ executed: boolean; actualResult?: R }>;
}

export interface JournalEntry {
  actionId: string;
  toolName: string;
  status: 'PENDING' | 'COMMITTED' | 'FAILED' | 'COMPENSATED';
  payloadHash: string;
  result?: any;
  timestamp: number;
}

export class ResilientAgentExecutionHarness {
  private journal: JournalEntry[] = [];
  private committedMutations: ToolAction[] = [];

  /**
   * Menghasilkan Idempotency Key deterministik berbasis SHA-256 dari parameter aksi
   */
  public generateDeterministicIdempotencyKey(toolName: string, params: any): string {
    const raw = `${toolName}:${JSON.stringify(params)}`;
    return crypto.createHash('sha256').update(raw).digest('hex');
  }

  /**
   * Eksekusi aman aksi mutasi dengan verifikasi pra-kondisi dan penanganan lost-ACK
   */
  public async executeSafeAction(action: ToolAction): Promise {
    const payloadHash = this.generateDeterministicIdempotencyKey(action.toolName, action.parameters);

    // 1. READ-BEFORE-RETRY: Verifikasi apakah mutasi sudah mendarat di sistem eksternal
    if (action.verifyStateOracle) {
      const probe = await action.verifyStateOracle(action.parameters);
      if (probe.executed && probe.actualResult) {
        console.warn(`[ORACLE_HIT] Mutation ${action.toolName} already committed. Reusing state without duplicate write.`);
        return probe.actualResult;
      }
    }

    // 2. Catat Jurnal Pra-Eksekusi (Zero-Privilege Journaling)
    const journalRecord: JournalEntry = {
      actionId: action.id,
      toolName: action.toolName,
      status: 'PENDING',
      payloadHash,
      timestamp: Date.now(),
    };
    this.journal.push(journalRecord);

    try {
      // 3. Eksekusi Aksi Mutasi dengan Idempotency Header
      const result = await this.invokeExternalToolAPI(action.toolName, action.parameters, action.idempotencyKey);

      journalRecord.status = 'COMMITTED';
      journalRecord.result = result;

      if (action.isMutating) {
        this.committedMutations.push(action);
      }

      return result;
    } catch (error: any) {
      journalRecord.status = 'FAILED';
      console.error(`[FAULT_DETECTED] Tool ${action.toolName} failed: ${error.message}`);

      // 4. SAGA ROLLBACK: Batalkan mutasi berantai jika terjadi kegagalan parsial
      await this.rollbackCommittedMutations();
      throw error;
    }
  }

  /**
   * Kompensasi mundur (Backward Recovery) untuk mengembalikan status sistem ke invariant valid
   */
  private async rollbackCommittedMutations(): Promise {
    console.log('[SAGA_COMPENSATION] Rolling back partially committed mutations in reverse order...');
    while (this.committedMutations.length > 0) {
      const lastAction = this.committedMutations.pop()!;
      if (lastAction.compensatingAction) {
        try {
          await lastAction.compensatingAction(lastAction.parameters, null);
          console.log(`[COMPENSATED] Successfully rolled back ${lastAction.toolName}`);
        } catch (compensationError: any) {
          console.error(`[CRITICAL_COMPENSATION_FAILURE] Failed to rollback ${lastAction.toolName}: ${compensationError.message}`);
        }
      }
    }
  }

  private async invokeExternalToolAPI(tool: string, params: any, idempotencyKey: string): Promise {
    // Simulasi wire call dengan Idempotency Key
    return { status: 200, success: true, tool, payload: params, idempotencyKey };
  }
}
7. Rekomendasi Rekayasa 2026: Blueprint Desain Sistem Agen yang Tahan Terhadap Bencana Operasional
Berdasarkan temuan saintifik UndoBench, arsitek sistem software dan tim rekayasa AI enterprise wajib menerapkan 5 prinsip desain non-negosiabel berikut sebelum mendeploy agen otonom ke lingkungan produksi:
-
1. Hapus Kebijakan Naive Blind Retry dari Prompt Agen: Jangan pernah membiarkan instruksi ReAct atau prompt sistem mengulang panggilan fungsi secara membabi buta setelah menerima error timeout atau connection reset. Setiap pengulangan aksi mutasi wajib diawali dengan query status (Read-Before-Retry).
-
2. Wajibkan Idempotency Keys Deterministik pada Semua Mutating Tools: Setiap tool yang memodifikasi state (POST, PUT, DELETE, SQL INSERT/UPDATE) harus membungkus payload dengan kunci idempotensi deterministik berbasis hash parameter input.
-
3. Terapkan SAGA Pattern pada Setiap Composite Workflow: Untuk alur kerja yang melibatkan lebih dari satu pemanggilan perkakas mutasi, pasangkan setiap aksi dengan aksi kompensasi (compensating action) untuk mengeksekusi automated backward recovery saat terjadi kegagalan parsial.
-
4. Evaluasi Mandiri dengan Metrik Terpisah (Nominal vs CRSR): Uji sistem agen Anda di CI pipeline menggunakan skenario failure injection. Ukur secara terpisah Nominal Competence, Conditional Recovery Success Rate (CRSR), dan Duplicate Effect Ratio (DER).
-
5. Terapkan Wire-Level Effect Oracles di Lingkungan Uji: Jangan mempercayai laporan teks agen bahwa ia telah memulihkan transaksi. Verifikasi state fisik langsung pada database atau wire network untuk memastikan tidak ada side-effects tersembunyi yang tertinggal.
UndoBench menandai berakhirnya era di mana kemampuan agen hanya dinilai dari keberhasilannya bernavigasi di jalan bebas hambatan. Di era produksi enterprise 2026, kematangan arsitektur sistem agen diukur dari seberapa tangguh ia melindungi integritas data ketika seluruh infrastruktur di sekitarnya runtuh.
Referensi & Sumber Terverifikasi
- [1]UndoBench: Separating Task Competence from Recovery Capability in Tool-Using AI Agents(arXiv:2610.05622 [cs.SE, cs.AI] — Dolly Sah, Tanmay Sah, Harshul Jain, Tanya Sah)
- [2]UndoBench Open Benchmark & Verification Codebase(GitHub Repository — tradertanmay/undobench)
- [3]Sagas: A Mechanism for Long-Lived Transactions(ACM SIGMOD Record — Hector Garcia-Molina & Kenneth Salem (Princeton University))
- [4]IETF RFC 9457: Problem Details for HTTP APIs(Internet Engineering Task Force (IETF))
- [5]The Idempotency-Key HTTP Header Field (IETF Draft)(IETF HTTP Working Group)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
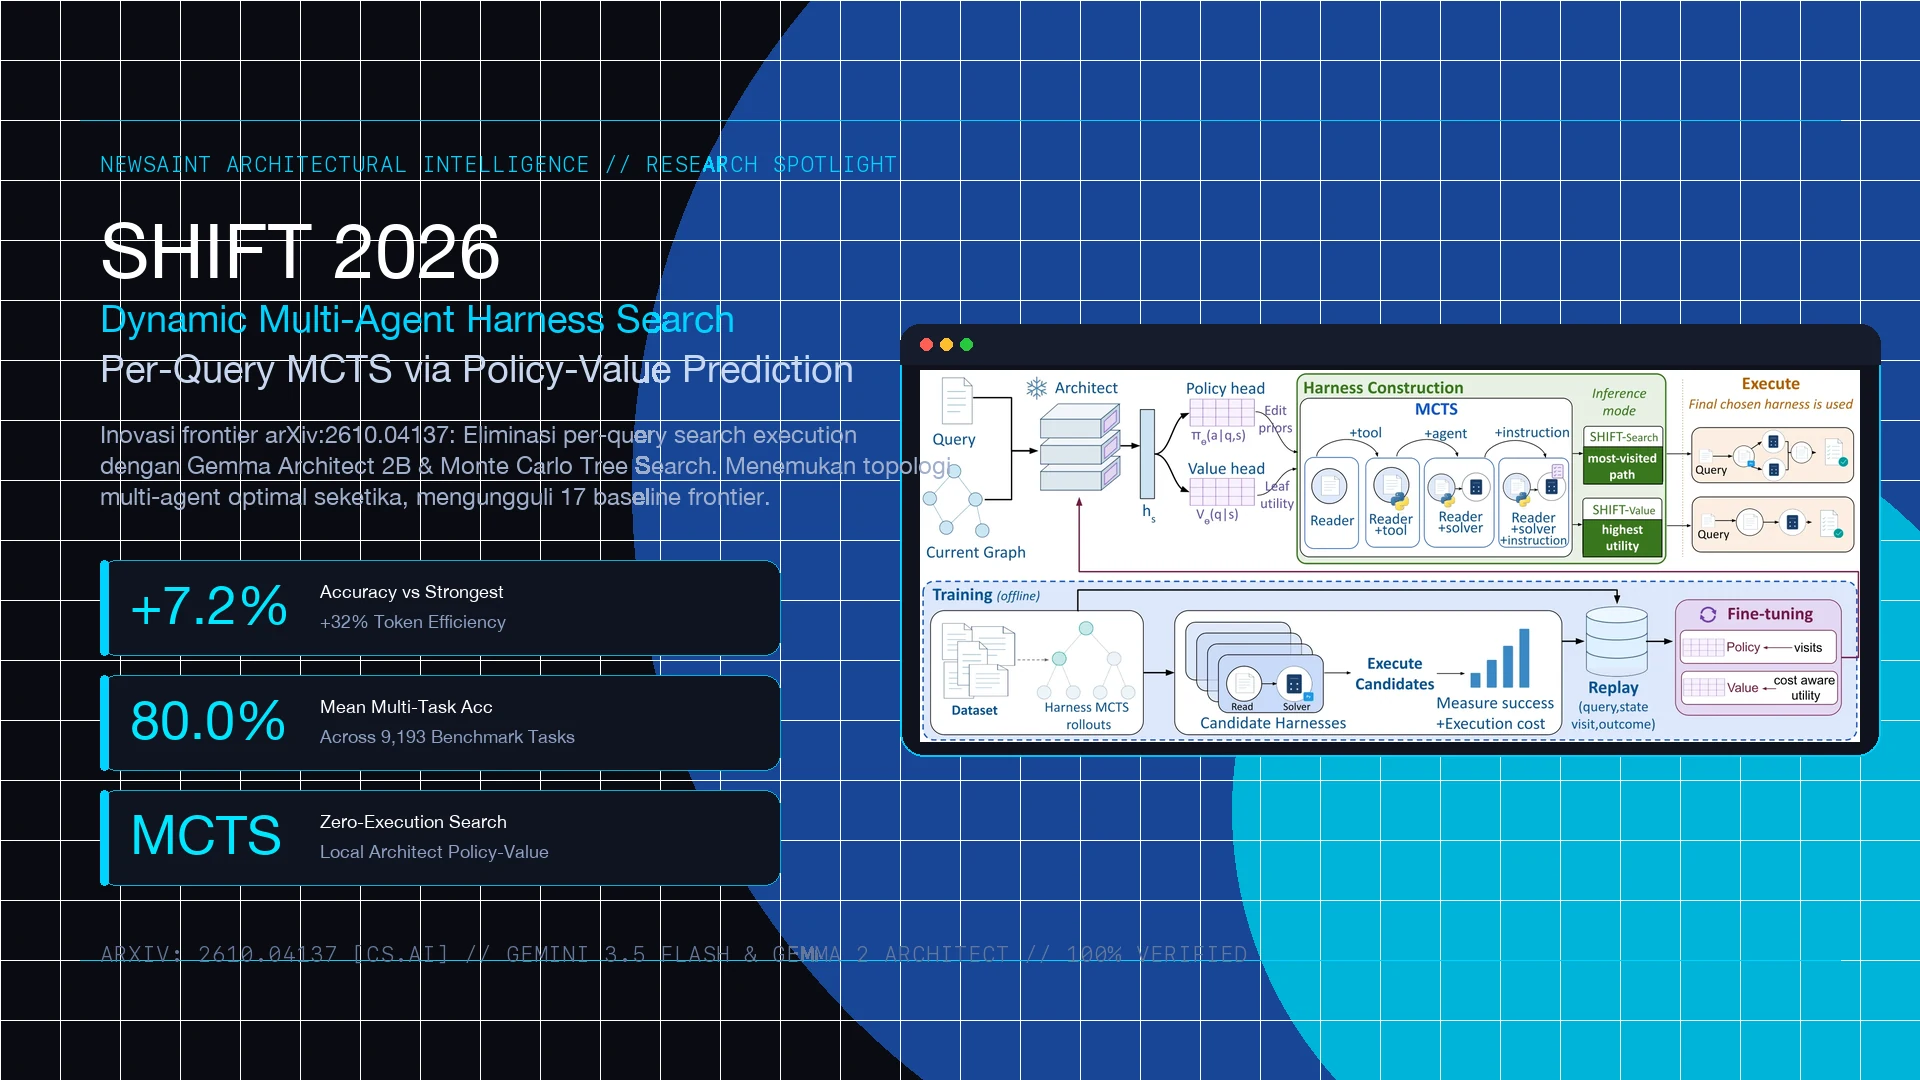
SHIFT 2026: Arsitektur Dynamic Multi-Agent Harness Search Per-Query via Policy-Value Prediction MCTS, Eliminasi Search Execution Overhead, dan Lompatan Akurasi +7.2 Poin Melampaui 17 Baseline
Analisis mendalam arsitektur riset frontier (arXiv:2610.04137, Google Cloud AI Research & Arizona State University — Som Sagar, Shasha Li, Hejie Cui, Ransalu Senanayake, Sercan O. Arik): Mengapa konfigurasi harness multi-agent (peran, instruksi, perkakas, dan topologi komunikasi) yang statis atau per-query search berbasis eksekusi langsung membentur latensi masif dan pembengkakan biaya token. Memperkenalkan SHIFT, framework yang memindahkan eksekusi keluar dari search loop per-query melalui arsitektur lokal Policy-Value Architect (Gemma 2 2B) yang memandu Monte Carlo Tree Search (MCTS) untuk menyusun executable graph optimal. Evaluasi komprehensif pada 9.193 tugas lintas 6 benchmark (GSM8K, HotpotQA, MBPP, SpreadsheetBench, OfficeQA Pro, GAIA) dengan eksekutor Gemini 3.5 Flash membuktikan SHIFT mencatat akurasi rerata tertinggi 80.0% (+7.2 poin di atas baseline terkuat), memangkas 32% token eksekusi, serta membuktikan bahwa optimasi simultan topologi, prompt, dan tools menghasilkan keunggulan +9.1 poin dibanding optimasi parsial.
CUAWright 2026: Arsitektur Minimal Terminal Harness ~3K LOC untuk Digital Agents, Eliminasi Bottleneck GUI-Native, Vision-on-Demand, dan Lompatan Performa +44.0% pada Long-Horizon Tasks
Analisis arsitektur sistem frontier riset digital agents (arXiv:2610.04116, Microsoft Research, OSU, NUS, CMU — Yadong Lu, Theodore Lee, Yifei Li, Lawrence Keunho Jang, Tianci Xue, Yu Su, Huan Sun, Ahmed Hassan Awadallah): Mengapa paradigma Computer-Use Agent (CUA) berbasis GUI visual dan static domain-specific harness membentur inefisiensi biaya serta kerapuhan grounding koordinat. Memperkenalkan CUAWright, minimal terminal harness (~3K baris kode) yang menjadikan perintah Bash sebagai antarmuka aksi tunggal (sole action interface), workspace sistem berkas sebagai memori eksternal berevolusi, dan vision-on-demand alih-alih screenshot otomatis tiap langkah. Evaluasi komprehensif pada 6 benchmark frontier membuktikan CUAWright melesat dengan lonjakan partial reward +33.2% dan pemangkasan biaya token 37.5% di OSWorld 2.0 (GPT-5.6 Sol / GPT-5.5), keunggulan +44.0% success rate di Odysseys, +4.7% di Online-Mind2Web, serta lompatan skor Vision2Code hingga 79.0% di BenchCAD.
SourceLearn 2026: Arsitektur Persistent Source Model, Self-Directed & Task-Guided Learning, serta Peningkatan Akurasi hingga +22.6 Poin Melampaui Hybrid RAG pada Autonomous AI Agents
Analisis arsitektur sistem riset frontier AI (arXiv:2610.02150, Georgia Tech, UIUC, UCLA — Lucheng Fu, Kejing Xia, Yiyang Wang, Yiqiao Jin, Jinjin He, Xiyuan Yang, Haoxin Liu, Ye Yu, Haibo Jin, Yijia Xiao, Wenke Lee, B. Aditya Prakash, Haohan Wang): Mengapa sistem RAG konvensional (Hybrid RAG, RAPTOR, HippoRAG 2) dan agent-memory (AWM) gagal mengembangkan pemahaman kumulatif atas sumber eksternal otoritatif yang diakses berulang kali. Memperkenalkan SourceLearn, paradigma source learning yang membangun Persistent Source Model (M) melalui dua mekanisme komplementer: Self-Directed Source Learning (siklus Inspect-Study-Consolidate untuk menambal fragmentasi relasi entitas) dan Task-Guided Source Learning (Failure-guided local refinement & Cross-task representation learning). Evaluasi empiris lintas 5 benchmark (MultiDoc2Dial, NarrativeQA, SWE-QA, APIBench, AppWorld) dan 3 LLM backend (GPT-5.6-Luna, gpt-oss-120b, DeepSeek-V4.1-Flash) membuktikan keunggulan SourceLearn pada 13 dari 15 pengujian dengan lonjakan akurasi hingga +22.6 poin di atas Hybrid RAG.