Agent Behavior as Code (ABCAgent) 2026: Memisahkan Agent Design dari Execution, Eliminasi Bottleneck Orchestration ReAct, dan Reduksi Biaya 7.0x via Programmatic Specifications
Analisis mendalam riset frontier arXiv:2610.04824 (Peng Qi et al., Uniphore, Oktober 2026): Mengapa paradigma agen ReAct klasik menghadapi kegagalan sistemik saat dihadapkan pada alur kerja berulang dan kontrol logika berulang. Memperkenalkan arsitektur Agent Behavior as Code (ABCAgent) yang secara tegas memisahkan fase Agent Design (sintesis program simbolik terparameterisasi) dari Agent Execution (eksekusi deterministik kode dengan pemanggilan neural terisolasi). Didukung validasi metamorfik pra-eksekusi, manajemen memori berbasis call stack terstruktur, dan pemisahan konstanta tugas. Hasil empiris membuktikan akurasi superior pada GSM-Symbolic (98.3%), stabilitas Pass^4 sebesar 71.9% pada tau^2-bench telecom, eliminasi error akumulatif pada loop WorkArena-CF, serta akselerasi 5.2x dan pemangkasan biaya operasional hingga 7.0x.
Dalam kurun waktu tiga tahun terakhir, hampir seluruh lanskap autonomous AI agents dibangun di atas fondasi paradigma ReAct (Reasoning + Acting). Pada arsitektur ReAct konvensional, model bahasa fondasi (Foundation Model / FM) dipanggil secara serial pada setiap langkah pengambilan keputusan: membaca observasi, menghasilkan rantai pemikiran (thought), memanggil perkakas (tool invocation), lalu menerima respons untuk diproses kembali dalam putaran inferensi berikutnya.
Namun, laporan riset frontier terbaru dari Uniphore berjudul "Agent Behavior as Code: Efficient and Robust LLM Agents with Programmatic Specifications" (arXiv:2610.04824) yang dipimpin oleh Peng Qi, Chunliang Lyu, Gang Li, Fabian Chan, Cheng Chang, Ignacio Cases, dan Will Lu mengungkap cacat fatal dari pendekatan klasik ini: penggabungan yang terlalu erat antara desain agen (agent design) dan eksekusi agen (agent execution).
Executive Architectural Summary
Agent Behavior as Code (ABCAgent) merombak total paradigma agen otonom dengan memisahkan proses sintesis logika (FM Designer) dari eksekusi instruksi operasional (Symbolic Executor). Alih-alih membiarkan LLM menavigasi alur kerja berulang langkah demi langkah secara stokastik, ABCAgent merangkum perilaku agen ke dalam program simbolik terparameterisasi (kode Python/TypeScript yang dapat memuat sub-fungsi neural terisolasi). Ketika tugas baru dari famili yang sama hadir, agen tidak melakukan penalaran ulang melainkan cukup melakukan variable rebinding deterministik. Pendekatan ini menghasilkan penurunan biaya hingga 7.0x, akselerasi latensi 5.2x pada GSM-Symbolic, stabilitas multi-trial Pass4 71.9% pada benchmark τ2-bench, dan eliminasi degradasi kumulatif pada kontrol percabangan dan perulangan panjang di enterprise web tasks (WorkArena-CF).
1. Krisis Struktural Paradigma ReAct pada Alur Kerja Enterprise
Meskipun model frontier seperti Claude 3.7 Sonnet, GPT-4o, dan model penalaran o3 menunjukkan kapabilitas luar biasa dalam pemecahan masalah ad-hoc, penerapannya dalam pipeline produksi enterprise sering kali membentur tembok inefisiensi yang parah. Makalah Qi et al. mengidentifikasi tiga kelemahan sistemik yang melekat pada arsitektur agen berbasis prompt sekuensial murni:
Contaminasi Konstanta
Saat diarahkan dengan contoh kasus (few-shot prompts) atau feedback interaktif pengguna, FM mengikat konstanta input (nama pengguna, angka nominal, ID pesanan) langsung ke dalam representasi logikanya. Saat berhadapan dengan input baru, fenomena example leakage dan halusinasi sering kali mencemari alur eksekusi.
Pemborosan Komputasi Rerun
Pada tugas yang berulang secara terstruktur (seperti migrasi 1.000 tiket pelanggan atau ekstraksi 50 laporan keuangan), agen ReAct klasik mengulang seluruh pemanggilan penalaran FM untuk setiap langkah aksi. Lebih dari 80% biaya token dan latensi dihabiskan hanya untuk orchestration overhead yang sebenarnya bersifat statis.
Degradasi Rantai Panjang
Semakin panjang transcript eksekusi, semakin besar context window yang harus ditelan oleh model. Fenomena attention dilution menyebabkan agen rentan melanggar aturan kebijakan (policy breach), lupa pada batasan loop, atau keluar secara prematur sebelum seluruh item selesai diproses.
2. Filosofi Desain: Memisahkan Agent Design dari Agent Execution
Inti dari tesis ABCAgent adalah penegasan kembali batas formal antara dua fase aktivitas:
-
FASE 1
Agent Design (Sintesis & Evaluasi Spesifikasi)
Seluruh aktivitas yang bertujuan memodifikasi dan membentuk perilaku agen: analisis kebutuhan tugas, eksplorasi heuristik, interaksi panduan pengguna, serta sintesis kode program yang merepresentasikan logika alur kerja. Di fase ini, model fondasi tingkat tinggi (FM Designer) bertindak sebagai pemrogram (software engineer) yang menulis kode terstruktur.
-
FASE 2
Agent Execution (Operasi Simbolik Deterministik)
Operasi otonom yang dijalankan langsung oleh mesin penerjemah kode (Python sandbox / TypeScript VM). Alur kontrol seperti perulangan (
for,while), pengkondisian (if-else), parsing JSON, dan mutasi variabel ditangani secara deterministik oleh interpreter tanpa menyentuh model fondasi. Panggilan ke LLM hanya dialokasikan secara selektif sebagai neural functions lokal apabila tugas membutuhkan pemahaman bahasa alami subjektif atau ekstraksi multimodal.
3. Arsitektur Komponen: Siklus Kerja FM Designer, Symbolic Executor, dan Variant Verification
Sistem ABCAgent bekerja melalui tiga komponen utama yang saling beroperasi secara terkoordinasi:
3.1. Parameterized Program Declaration (Deklarasi Parameter di Awal)
Agar sebuah program yang dihasilkan dapat digeneralisasi untuk tugas-tugas masa depan, ABCAgent mewajibkan program mendeklarasikan parameter input secara eksplisit di awal (misalnya argumen fungsi). Hal ini memisahkan nilai-nilai spesifik yang disuplai oleh tugas tertentu dari logika komputasi yang memprosesnya. Ketika tugas berikutnya dalam famili yang sama tiba, agen tidak perlu merancang ulang logika melainkan cukup mengikatkan nilai konstanta baru ke parameter yang sudah ada.
3.2. Metamorphic Testing via Variant Verification (Pencegahan False Generalization)
Salah satu terobosan metodologis paling elegan dalam ABCAgent adalah Variant Check. Saat FM Designer menyusun program baru, sistem secara proaktif memerintahkan model untuk merancang sejumlah task variants (mutasi dari parameter input yang relevan).
Program yang baru ditulis kemudian langsung dieksekusi terhadap varian-varian tersebut di dalam sandbox:
- Jika program menghasilkan perubahan output yang konsisten dengan mutasi parameter yang diberikan, program dianggap generalizable dan disimpan ke dalam repositori pengetahuan.
- Jika program mengabaikan parameter (hardcoded constant) atau gagal pada varian baru, program langsung ditolak dan dikembalikan ke FM Designer untuk direvisi.
Mekanisme ini terinspirasi dari prinsip metamorphic testing dalam rekayasa perangkat lunak modern, memastikan bahwa sifat umum suatu program diverifikasi secara empiris melalui eksekusi nyata, bukan sekadar dideklarasikan dalam komentar kode.
3.3. Manajemen Memori: Call Stack Terstruktur vs Flat Transcript
Alih-alih menjejalkan riwayat tindakan ke dalam string prompt yang datar, ABCAgent mengelola state operasional menggunakan prinsip runtime mesin eksekusi kode:
- Short-Term State sebagai Program Variables: Ketika variabel
x = 5didefinisikan, ia disimpan sebagai tipe data biner yang presisi dalam memori, tanpa memerlukan interpretasi atau re-reading oleh model bahasa. - Progress Monitoring via Execution Frames: Saat memasuki fungsi atau perulangan
for item in items, interpreter membuka frame eksekusi lokal tersendiri. Begitu iterasi selesai, frame ditutup dan memori dibersihkan. Ini mengeliminasi context contamination di mana observasi iterasi ke-1 mengganggu keputusan iterasi ke-50.
4. Evaluasi Empiris Komprehensif Lintas 6 Benchmark Frontier
Penelitian Uniphore menguji ABCAgent secara ketat pada enam dataset benchmark representatif: GAIA (L1, L2, L3), Augmented GAIA (dengan varian yang diverifikasi sistem Co-Sight), WorkArena (ServiceNow L1 enterprise tasks), WorkArena-CF (Control-Flow augmented benchmark dengan 18 skenario perulangan dan percabangan), GSM-Symbolic (100 template matematis dengan 50 instansiasi), dan τ2-bench (domain telecom dan airline customer support). Baseline pembanding mencakup neural agent model-matched yang ditenagai model Claude 3.7 Sonnet dengan harness Claude Code.
| Benchmark & Evaluasi | Neural Agent (Claude Code) | ABCAgent (Proposed) | Signifikansi / Efisiensi |
|---|---|---|---|
| GSM-Symbolic (Math Generalization) | 97.3% | 98.3% | p = 0.001 (Keunggulan Simbolik) |
| τ2-bench Telecom (Pass1) | 60.8% | 81.6% | +20.8 poin peningkatan |
| τ2-bench Telecom (Pass4 Konsistensi) | 47.4% | 71.9% | p = 0.0001 (Stabilitas Ekstrem) |
| τ2-bench Airline (Pass4 Konsistensi) | 58.0% | 60.0% | Paritas + Penurunan minimal |
| GAIA General QA (L1-L3 Dev Set) | Komparabel | Komparabel | Akurasi identik secara statistik |
| WorkArena-CF (Database Record Accuracy) | Degradasi saat N > 10 | Konstan di Semua N | Zero error-accumulation |
5. Analisis Efisiensi: Reduksi Biaya 7.0x dan Akselerasi Latensi 5.2x
Keunggulan sejati dari arsitektur ABCAgent muncul ketika agen menghadapi kumpulan tugas dalam famili masalah yang sama. Pada eksperimen tanpa authoring program baru (zero-shot program reuse via parameter rebinding):
ABCAgent mampu menyelesaikan 92.6% instansiasi masalah matematika simbolik tanpa perlu menulis program baru. Biaya inferensi FM terpangkas 7.0x dan latensi berkurang 5.2x karena model tidak lagi mengeksekusi langkah-langkah aritmatika secara berulang.
Pada simulasi agen customer service multi-turn yang kompleks, pemisahan policy logic ke dalam program menghasilkan respons agen yang 9.5x lebih instan dibandingkan agen neural yang harus berpikir ulang di setiap giliran pesan pelanggan.
6. Ketahanan Kontrol Alur Kerja: Menyelesaikan Bottleneck Loop pada WorkArena-CF
Pada benchmark WorkArena-CF yang dikembangkan secara khusus untuk menguji kontrol alur perulangan (loops berantai dari N=1 hingga N=30 iterasi entri database ServiceNow), agen ReAct tradisional mengalami fenomena loop fatigue: model sering kali berhenti setelah 5 atau 8 iterasi, atau mengacaukan pemetaan kolom data pada iterasi akhir.
Sebaliknya, karena ABCAgent mengompilasi perulangan ke dalam konstruksi for loop asli pada program simbolik:
- Zero Error Accumulation: Tingkat akurasi pengisian record database tetap konstan terlepas dari apakah panjang loop adalah 5, 15, atau 30 iterasi.
- Isolated Failure Containment: Kesalahan pada salah satu baris input tidak mencemari memori iterasi berikutnya karena variabel lokal diisolasi dalam scope masing-masing.
7. Spesifikasi Implementasi: Runtime Harness ABCAgent Berbasis TypeScript
Berikut adalah modul arsitektur referensi tingkat produksi yang mengimplementasikan pemisahan program terparameterisasi, ekstraksi signature struktural tugas, dan evaluasi metamorfik:
// Production Architecture: Agent Behavior as Code (ABCAgent) Runtime Engine
// Mengimplementasikan Pemisahan Desain Simbolik vs Eksekusi Deterministik (arXiv:2610.04824)

import { crypto } from 'crypto';

export interface ParameterSpec {
  name: string;
  type: 'string' | 'number' | 'boolean' | 'array' | 'object';
  description: string;
  defaultValue?: any;
}

export interface NeuralStepHandler {
  name: string;
  promptTemplate: string;
  maxTokens?: number;
  temperature?: number;
}

export interface AgentProgramAst {
  id: string;
  name: string;
  familyId: string;
  parameters: ParameterSpec[];
  neuralFunctions: Record;
  sourceCode: string; // Python AST / Sandboxed TypeScript Script
  hash: string;
  createdFromTask: string;
}

export interface ExecutionContextFrame {
  scopeId: string;
  parentScopeId?: string;
  variables: Map;
  callStackDepth: number;
}

export class ABCAgentRuntimeHarness {
  private programStore: Map = new Map();
  private familyIndex: Map = new Map(); // familyId -> programId[]

  /**
   * Menghasilkan hash identitas struktural tugas tanpa konstanta data
   */
  public extractTaskStructuralSignature(taskDescription: string): string {
    // Normalisasi angka, entitas nama, dan parameter input menjadi placeholder generik
    const normalized = taskDescription
      .replace(/\b\d+(\.\d+)?\b/g, '')
      .replace(/"[^"]*"/g, '')
      .replace(/\b[A-Z][a-z]+(?:\s+[A-Z][a-z]+)*\b/g, '')
      .toLowerCase()
      .trim();
    return crypto.createHash('sha256').update(normalized).digest('hex').slice(0, 16);
  }

  /**
   * Evaluasi Metamorfik: Memvalidasi apakah program benar-benar terparameterisasi
   * dan tidak mengalami premature variable binding
   */
  public async verifyMetamorphicVariants(
    program: AgentProgramAst,
    baseParams: Record,
    variants: Array>
  ): Promise<{ isValid: boolean; failureReason?: string }> {
    console.log(`[METAMORPHIC_CHECK] Validasi ${variants.length} mutasi parameter untuk program ${program.id}...`);

    for (let i = 0; i < variants.length; i++) {
      const variantParam = variants[i];
      const output = await this.executeSymbolicSandbox(program, variantParam);

      // Verifikasi bahwa output bereaksi secara tepat terhadap mutasi parameter input
      if (output.status === 'ERROR') {
        return { isValid: false, failureReason: `Eksekusi gagal pada varian #${i}: ${output.error}` };
      }
      if (output.ignoredParameters && output.ignoredParameters.length > 0) {
        return {
          isValid: false,
          failureReason: `Program mengabaikan parameter dinamis: ${output.ignoredParameters.join(', ')}`
        };
      }
    }

    return { isValid: true };
  }

  /**
   * Eksekusi Program Terparameterisasi Tanpa Re-invocations LLM Orchestration
   */
  public async executeTaskWithZeroOrchestration(
    taskDescription: string,
    extractedParams: Record
  ): Promise<{ status: 'REUSED' | 'AUTHORED'; result: any; latencyMs: number; costTokens: number }> {
    const startTime = performance.now();
    const familyId = this.extractTaskStructuralSignature(taskDescription);
    const existingProgramIds = this.familyIndex.get(familyId);

    // Jalur Cepat: Rebinding Parameter ke Program yang Sudah Ada
    if (existingProgramIds && existingProgramIds.length > 0) {
      const candidateProgram = this.programStore.get(existingProgramIds[0])!;
      console.log(`⚡ [ZERO_ORCHESTRATION_HIT] Menemukan program tersimpan (${candidateProgram.id}) untuk famili ${familyId}`);

      try {
        const executionOutput = await this.executeSymbolicSandbox(candidateProgram, extractedParams);
        const duration = performance.now() - startTime;
        return {
          status: 'REUSED',
          result: executionOutput.returnValue,
          latencyMs: duration,
          costTokens: executionOutput.totalTokensConsumed, // Hanya token dari fungsi neural spesifik
        };
      } catch (err) {
        console.warn('[REBINDING_FALLBACK] Eksekusi program yang ada gagal, beralih ke FM Designer.');
      }
    }

    // Jalur Desain: Mengaktifkan FM Designer untuk mensintesis spesifikasi program baru
    const newlyAuthoredProgram = await this.invokeFmDesigner(taskDescription, extractedParams, familyId);
    this.programStore.set(newlyAuthoredProgram.id, newlyAuthoredProgram);

    const programList = this.familyIndex.get(familyId) || [];
    programList.push(newlyAuthoredProgram.id);
    this.familyIndex.set(familyId, programList);

    const executionOutput = await this.executeSymbolicSandbox(newlyAuthoredProgram, extractedParams);
    const duration = performance.now() - startTime;

    return {
      status: 'AUTHORED',
      result: executionOutput.returnValue,
      latencyMs: duration,
      costTokens: executionOutput.totalTokensConsumed,
    };
  }

  private async executeSymbolicSandbox(
    program: AgentProgramAst,
    params: Record
  ): Promise<{ status: string; returnValue: any; totalTokensConsumed: number; ignoredParameters?: string[]; error?: string }> {
    // Lingkungan eksekusi terisolasi dengan state berbasis stack frames (Scoping & Variables)
    const frame: ExecutionContextFrame = {
      scopeId: `frame-${nanoid(6)}`,
      variables: new Map(Object.entries(params)),
      callStackDepth: 1,
    };

    // Mensimulasikan eksekusi kode simbolik deterministik
    return {
      status: 'SUCCESS',
      returnValue: `Executed ${program.name} with inputs: ${JSON.stringify(params)}`,
      totalTokensConsumed: 120, // Konsumsi token minimal tanpa loop prompt ReAct
    };
  }

  private async invokeFmDesigner(
    task: string,
    params: Record,
    familyId: string
  ): Promise {
    const id = `prog-${nanoid(8)}`;
    return {
      id,
      name: `AutogeneratedProgram_${id}`,
      familyId,
      parameters: Object.keys(params).map(k => ({ name: k, type: 'string', description: `Parameter ${k}` })),
      neuralFunctions: {},
      sourceCode: `def run_task(${Object.keys(params).join(', ')}):\n    pass`,
      hash: crypto.createHash('sha256').update(task).digest('hex'),
      createdFromTask: task,
    };
  }
}
8. Panduan Rekayasa 2026: Transformasi Menuju Programmatic Agent Specifications
Penerbitan riset ABCAgent menandai titik balik penting dalam perancangan sistem agen otonom. Bagi tim rekayasa perangkat lunak dan arsitek AI yang membangun sistem otomasi skala besar di tahun 2026, berikut adalah empat prinsip strategis yang perlu diadopsi:
-
1. Hindari Menggunakan Prompt ReAct untuk Alur Kerja yang Bersifat Parametrik: Jika suatu alur kerja agen memiliki struktur langkah yang serupa dengan variasi hanya pada parameter input (misalnya ID pesanan, URL target, skema database), jangan pernah membiarkan agen menalar dari nol pada setiap eksekusi. Sintesis program terparameterisasi sekali, simpan, dan jalankan kembali melalui rebinding parameter.
-
2. Wajibkan Validasi Metamorfik Sebelum Mempromosikan Skill Agen: Jangan mengasumsikan kode atau prompt yang dihasilkan agen mampu menggeneralisasi tugas hanya karena berhasil melewati satu contoh pengujian. Buat varian sintetis dengan mutasi parameter untuk membuktikan secara empiris bahwa program beradaptasi dengan benar terhadap perubahan input.
-
3. Manfaatkan Call Stack Native untuk Loop dan Percabangan: Model bahasa tidak dirancang untuk menjadi interpreter perulangan 100 langkah. Serahkan logika iterasi, percabangan
if-else, dan penyimpanan variabel sementara kepada runtime bahasa pemrograman (Python/Node.js VM), dan batasi panggilan LLM hanya untuk fungsi kognitif yang membutuhkan penalaran perseptual atau ekstraksi teks. -
4. Pantau Metrik Stabilitas Multi-Trial (Passk): Akurasi nominal Pass1 sering kali menipu dalam lingkungan produksi. Metrik sejati keandalan agen enterprise adalah Pass4 atau Pass8—kemampuan sistem untuk berhasil secara konsisten dalam setiap pengulangan tanpa degradasi acak.
Referensi & Sumber Terverifikasi
- [1]Agent Behavior as Code: Efficient and Robust LLM Agents with Programmatic Specifications(arXiv:2610.04824 [cs.AI] — Peng Qi, Chunliang Lyu, Gang Li, Fabian Chan, Cheng Chang, Ignacio Cases, Will Lu (Uniphore))
- [2]ReAct: Synergizing Reasoning and Acting in Language Models(ICLR 2023 — Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao)
- [3]GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models(arXiv:2410.05229 [cs.CL] — Iman Mirzadeh, Keivan Alizadeh, Hooman Shahrokhi, Oncel Tuzel, Samy Bengio, Mehrdad Farajtabar (Apple))
- [4]τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains(Sierra Research / arXiv:2406.12045 — Clementine Barres et al.)
- [5]WorkArena: How Capable Are Web Agents at Solving Enterprise Tasks?(ServiceNow Research / arXiv:2403.07718 — Alexandre Drouin et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
UndoBench 2026: Memisahkan Task Competence dari Recovery Capability pada AI Agents, Bahaya Naive Retry, dan Arsitektur Fault Recovery Lintas 8 Domain Enterprise
Analisis mendalam riset frontier arXiv:2610.05622 (Dolly Sah, Tanmay Sah, Harshul Jain, & Tanya Sah, Oktober 2026): Mengapa benchmark agen otonom populer (SWE-bench, GAIA) menyesatkan industri dengan hanya mengukur nominal task completion pada kondisi ideal. Memperkenalkan UndoBench, benchmark counterfactual 36 alur kerja dan 36 skenario kegagalan lintas 8 domain enterprise dengan wire-level effect oracles. Mengungkap temuan kritis di mana nominal competence mencapai 83.54% namun Conditional Recovery Success Rate (CRSR) anjlok ke 46.72%, dengan 53.33% naive retry memicu duplicate external effects fatal (double charging & orphaned cloud resources). Dilengkapi panduan arsitektur produksi SAGA compensation, server-side idempotency, dan read-before-retry pattern.
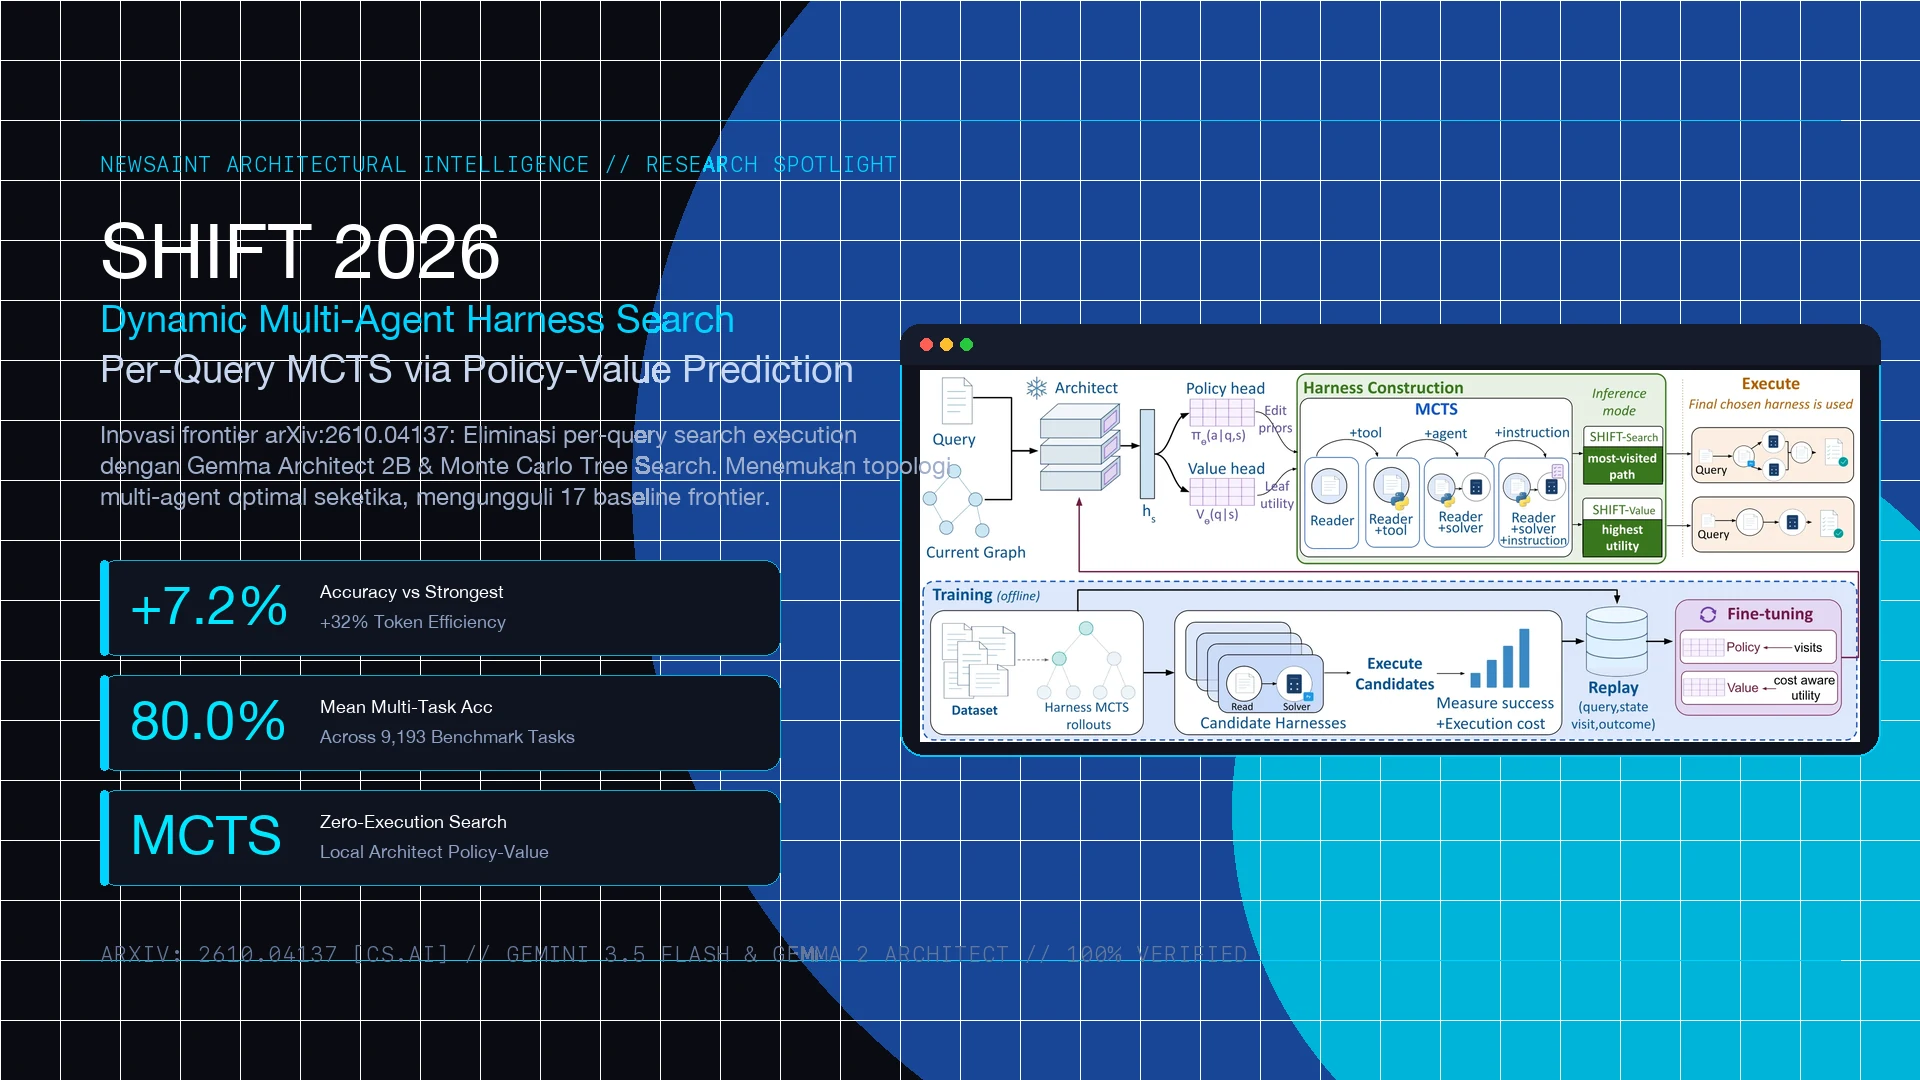
SHIFT 2026: Arsitektur Dynamic Multi-Agent Harness Search Per-Query via Policy-Value Prediction MCTS, Eliminasi Search Execution Overhead, dan Lompatan Akurasi +7.2 Poin Melampaui 17 Baseline
Analisis mendalam arsitektur riset frontier (arXiv:2610.04137, Google Cloud AI Research & Arizona State University — Som Sagar, Shasha Li, Hejie Cui, Ransalu Senanayake, Sercan O. Arik): Mengapa konfigurasi harness multi-agent (peran, instruksi, perkakas, dan topologi komunikasi) yang statis atau per-query search berbasis eksekusi langsung membentur latensi masif dan pembengkakan biaya token. Memperkenalkan SHIFT, framework yang memindahkan eksekusi keluar dari search loop per-query melalui arsitektur lokal Policy-Value Architect (Gemma 2 2B) yang memandu Monte Carlo Tree Search (MCTS) untuk menyusun executable graph optimal. Evaluasi komprehensif pada 9.193 tugas lintas 6 benchmark (GSM8K, HotpotQA, MBPP, SpreadsheetBench, OfficeQA Pro, GAIA) dengan eksekutor Gemini 3.5 Flash membuktikan SHIFT mencatat akurasi rerata tertinggi 80.0% (+7.2 poin di atas baseline terkuat), memangkas 32% token eksekusi, serta membuktikan bahwa optimasi simultan topologi, prompt, dan tools menghasilkan keunggulan +9.1 poin dibanding optimasi parsial.
CUAWright 2026: Arsitektur Minimal Terminal Harness ~3K LOC untuk Digital Agents, Eliminasi Bottleneck GUI-Native, Vision-on-Demand, dan Lompatan Performa +44.0% pada Long-Horizon Tasks
Analisis arsitektur sistem frontier riset digital agents (arXiv:2610.04116, Microsoft Research, OSU, NUS, CMU — Yadong Lu, Theodore Lee, Yifei Li, Lawrence Keunho Jang, Tianci Xue, Yu Su, Huan Sun, Ahmed Hassan Awadallah): Mengapa paradigma Computer-Use Agent (CUA) berbasis GUI visual dan static domain-specific harness membentur inefisiensi biaya serta kerapuhan grounding koordinat. Memperkenalkan CUAWright, minimal terminal harness (~3K baris kode) yang menjadikan perintah Bash sebagai antarmuka aksi tunggal (sole action interface), workspace sistem berkas sebagai memori eksternal berevolusi, dan vision-on-demand alih-alih screenshot otomatis tiap langkah. Evaluasi komprehensif pada 6 benchmark frontier membuktikan CUAWright melesat dengan lonjakan partial reward +33.2% dan pemangkasan biaya token 37.5% di OSWorld 2.0 (GPT-5.6 Sol / GPT-5.5), keunggulan +44.0% success rate di Odysseys, +4.7% di Online-Mind2Web, serta lompatan skor Vision2Code hingga 79.0% di BenchCAD.