EnvSched (arXiv:2610.37609): Environment-Aware Scheduling untuk Rollout-Efficient Agent Reinforcement Learning — Dual-Relation Graph, Prediksi Reward Variance, dan Rekor 48.81 Skor Qwen3-8B pada 40 Langkah GRPO
Analisis arsitektural riset frontier PKU, Tsinghua, XJTU, Samsung Research, CASIA, dan CUHK (arXiv:2610.37609, Sihan Yang, Weichen Bai, Ruichuan An, Yifan Zhang, Wentao Zhang): Mengapa penjadwalan data RL berbasis prompt individual (DPS, LEEPS) gagal saat scaling ke ribuan environment simulasi, bagaimana EnvSched memodelkan pasangan Environment-Task via Dual-Relation Graph (Within-Environment vs Cross-Environment), memprediksi reward variance historis untuk alokasi batch eksplorasi-eksploitasi, melipatgandakan efisiensi komputasi GPU 3x lipat, dan implementasi scheduler siap produksi.
Pelatihan Reinforcement Learning (RL) untuk AI agent pada ribuan executable environments menuntut ratusan ribu jam GPU H800 yang sangat mahal. Riset terobosan EnvSched (Environment-Aware Scheduling) membuktikan bahwa penjadwalan data pada level lingkungan eksekusi — bukan sekadar teks prompt acak — mampu memotong komputasi pelatihan hingga 3x lipat. Pada Qwen3-8B, EnvSched mencetak skor benchmark gabungan 48.81% hanya dalam 40 langkah GRPO, mengungguli skor tertinggi yang diraih penjadwalan random setelah 120-200 langkah penuh.
1. Dilema Skalabilitas & Krisis Komputasi Agentic Reinforcement Learning
Dalam evolusi frontier AI terkini, model bahasa besar tidak lagi hanya dilatih pada data teks statis (Next-Token Prediction) atau dialog tanya-jawab sederhana. Fondasi kecerdasan otonom bertumpu pada Agentic Reinforcement Learning (seperti GRPO dan PPO) di dalam lingkungan eksekusi dinamis (executable environments) yang dilengkapi antarmuka tools, transisi state basis data, dan verifikasi multi-langkah.
Sistem agent mutakhir seperti DeepSeek-V3, GLM-5, dan MiMo-V2.6 telah memperluas cakupan simulasi dari puluhan menjadi lebih dari 7.000 hingga 10.000 lingkungan terisolasi dengan ratusan ribu task instances. Namun, skala raksasa ini menciptakan bottleneck ekonomi yang brutal: post-training agen berbasis RL kini dilaporkan menguras lebih dari 250.000 jam komputasi GPU cluster H800.
Sebagian besar pembengkakan biaya ini bersumber dari satu kelemahan fatal: pengambilan sampel task secara acak (random scheduling) atau penjadwalan berbasis kesulitan prompt terisolasi (seperti DPS atau LEEPS). Ketika lingkungan eksekusi diabaikan, pelatihan RL terus-menerus memboroskan komputasi rollout pada dua jenis tugas yang tidak memberikan gradien belajar:
Tugas Trivial Tanpa Variansi (Zero-Variance Solved)
Tugas-tugas sederhana di mana agen selalu memperoleh reward 1.0 pada setiap trajectory. Dalam algoritma seperti GRPO yang mengandalkan relative advantage dalam grup, variansi reward bernilai nol menghasilkan gradien kebijakan tepat 0. Seluruh eksekusi multi-turn tools dan inferensi token menjadi sampah komputasi murni.
Tugas Imposibel / Environment Asimetris (Zero-Variance Failed)
Tugas yang terlalu sulit atau lingkungan yang rusak di mana agen selalu memperoleh reward 0.0 pada seluruh rollout. Tidak ada sinyal eksplorasi positif yang dapat diekstraksi, sementara simulasi multi-turn membebani CPU container dan I/O basis data secara sia-sia.
2. Arsitektur Dual-Relation Graph: Menjembatani Semantik & Topologi Eksekusi
Inovasi fundamental dari konsorsium riset Peking University, Tsinghua University, dan Samsung Research dalam paper EnvSched (arXiv:2610.37609) adalah memperlakukan pasangan Environment-Task (E, T) sebagai unit atomik penjadwalan, yang dipetakan ke dalam struktur Dual-Relation Graph:
1. Within-Environment Edges (E_within)
Menghubungkan tugas-tugas di dalam lingkungan yang sama berdasarkan kesamaan struktural konkret (Full Similarity):
Mengukur kesamaan skema basis data, nama parameter API tools, representasi state transisi, dan verifier assertion. Memungkinkan propagasi reward langsung antar instans tugas dalam satu domain.
2. Cross-Environment Edges (E_cross)
Menghubungkan tugas lintas domain yang berbeda berdasarkan topologi eksekusi abstrak (Abstract Similarity):
Abstraksi LLM memetakan alur kerja bisnis: misalnya, tugas "Reassign consultant pada CRM enterprise" dan "Memindahkan ranjang pasien di rumah sakit" berbagi struktur alur yang identik: Lookup → Eligibility Check → Relation Replacement → Dependent Validation.
Dengan topologi graf ganda ini, riwayat rollout dari tugas yang sudah diobservasi dapat ditransfer secara instan kepada tugas-tugas baru yang belum pernah dijalankan (zero-shot informativeness prediction). Scheduler tidak perlu melakukan exploratory rollout yang mahal untuk mengetahui apakah suatu tugas potensial memberikan gradien optimal.
3. Mekanisme Kalibrasi Variansi & Dual-Track Batch Allocation
Pada setiap langkah pelatihan RL, EnvSched mengombinasikan dua strategi terkoordinasi dalam komposisi rasio batch ρ = 0.5 (50% Coverage, 50% Exploitation):
Track 1: Coverage-Aware Diversity Sampling (50% Batch)
Mencegah model mengalami catastrophic forgetting atau overfitting pada domain tertentu. Scheduler memprioritaskan environment yang memiliki akumulasi eksposur paling rendah dalam dataset, serta task yang belum pernah diobservasi. Kuota ketat (maksimal 4 task per environment per batch) diterapkan untuk menghentikan monopoli domain.
Track 2: Informativeness Exploitation via Variance Calibration (50% Batch)
Memilih tugas-tugas dengan prediksi variansi reward tertinggi (high predicted reward variance). Variansi dihitung dari fusi antara riwayat lokal task dan propagasi graph prior. Tugas yang dipilih diberi faktor diskon eksposur kumulatif (1 + c_{i,t}/c_0)^{-1/2} agar model tidak terus-menerus mengeksploitasi tugas yang sama setelah variasinya menyusut.
4. Tolok Ukur Kinerja Empiris: Lonjakan Efisiensi Qwen3-8B & Qwen3-30B
Peneliti menguji EnvSched secara ketat pada tiga tolok ukur agen paling otoritatif di dunia: Berkeley Function-Calling Leaderboard (BFCL-v3), τ-Bench (lingkungan stateful dinamis dengan interaksi pengguna nyata), dan ACEBench-Agent (eksekusi API multi-step). Seluruh eksperimen diulang dengan tiga seed independen.
| Arsitektur & Metode Sampling | Steps RL | BFCL-v3 (Overall) | τ-Bench (Overall) | ACEBench-Agent | GPU Cost Relative |
|---|---|---|---|---|---|
| Qwen3-8B (Base Untrained) | - | 28.88% | 41.41% | 58.67% | Baseline |
| Qwen3-8B + Random Sampling | 200 steps | 33.88% | 47.27% | 55.33% | 1.0x (100%) |
| Qwen3-8B + DPS (Prompt-Only) | 200 steps | 35.50% | 48.08% | 58.00% | 1.0x (100%) |
| Qwen3-8B + LEEPS (Loss-Based) | 200 steps | 35.71% | 47.68% | 54.67% | 1.0x (100%) |
| Qwen3-8B + EnvSched (Super Fast) | 40 steps | 37.71% (+3.83) | 50.71% (+3.44) | 58.00% (+2.67) | 0.20x (-80% GPU Cost!) |
| Qwen3-8B + EnvSched (Full Convergence) | 200 steps | 39.00% (+5.12) | 50.30% (+3.03) | 60.00% (+4.67) | 1.0x (SOTA Accuracy) |
| Qwen3-30B-A3B (MoE) + EnvSched | 200 steps | 37.79% (+3.92) | 54.75% (+3.03) | 70.67% (+2.67) | Optimal Scale |
Perhatikan fakta krusial pada tabel di atas: EnvSched hanya membutuhkan 40 training steps untuk melampaui hasil 200 steps dari metode konvensional. Pada 40 steps, rata-rata skor gabungan mencapai 48.81%, mengungguli skor puncak random sampling (45.49%) yang harus berjalan 5x lebih lama. Secara statistik telemetri internal:
-
Lonjakan Variansi Reward (+34% Mean, +44% Median): EnvSched secara presisi menghindari tugas-tugas mati (dead compute) dan mengonsentrasikan komputasi rollout pada zona transisi kemampuan model, di mana sinyal gradient policy paling kuat terbentuk.
-
Ekspansi Cakupan Lingkungan & Tools (+26% Environments, +16% Unique Tools): Mekanisme kuota dan penalti redundansi memastikan model terpapar pada keragaman API bisnis yang luas dalam setiap batch, mencegah ketergantungan pada subset tools yang sempit.
5. Implementasi Kontroler Scheduler Online Siap Produksi
Berikut adalah implementasi referensi controller EnvSchedController dalam TypeScript. Modul ini dapat langsung diintegrasikan ke dalam pipeline training loop Ray / PyTorch RL runtime:
// Production Implementation: EnvSched Online Scheduler Engine
// Berdasarkan Prinsip Rekayasa arXiv:2610.37609 (PKU, Tsinghua, XJTU, CASIA)
// Mengoptimalkan Rollout Reinforcement Learning (GRPO/PPO) via Dual-Relation Graph

export interface EnvironmentTaskNode {
  id: string;
  envId: string;
  taskPrompt: string;
  tools: string[];
  stateSchema: Record<string, string>;
  verifierType: 'state_diff' | 'exact_match' | 'llm_judge';
  abstractTopology: string; // e.g., 'lookup -> eligibility -> relation_update -> validation'

  // Historical rollout statistics
  rolloutCount: number;
  cumulativeExposure: number;
  rewardHistory: number[];
  meanReward: number;
  rewardVariance: number;
  meanCorrectedDispersion: number;
}

export interface DualRelationEdge {
  sourceId: string;
  targetId: string;
  relationType: 'within_env' | 'cross_env';
  weight: number; // Cosine similarity in feature space
}

export class EnvSchedController {
  private readonly nodes: Map<string, EnvironmentTaskNode> = new Map();
  private readonly withinEdges: Map<string, DualRelationEdge[]> = new Map();
  private readonly crossEdges: Map<string, DualRelationEdge[]> = new Map();

  constructor(
    private readonly coverageRatio: number = 0.5, // rho = 0.5 (50% coverage, 50% exploitation)
    private readonly exposureHalfLife: number = 10,  // c_0 discount scale
    private readonly maxBatchPerEnv: number = 4     // Quota per environment in single batch
  ) {}

  public registerNode(node: EnvironmentTaskNode): void {
    this.nodes.set(node.id, {
      ...node,
      rolloutCount: node.rolloutCount || 0,
      cumulativeExposure: node.cumulativeExposure || 0,
      rewardHistory: node.rewardHistory || [],
      meanReward: node.meanReward || 0,
      rewardVariance: node.rewardVariance || 0,
      meanCorrectedDispersion: node.meanCorrectedDispersion || 0,
    });
  }

  public addEdge(edge: DualRelationEdge): void {
    const map = edge.relationType === 'within_env' ? this.withinEdges : this.crossEdges;
    if (!map.has(edge.sourceId)) {
      map.set(edge.sourceId, []);
    }
    map.get(edge.sourceId)!.push(edge);
  }

  /**
   * Mengupdate statistik reward dari hasil rollout batch terkini
   */
  public recordBatchRollouts(batchResults: Array<{ taskId: string; rewards: number[] }>): void {
    for (const res of batchResults) {
      const node = this.nodes.get(res.taskId);
      if (!node) continue;

      node.rolloutCount += res.rewards.length;
      node.cumulativeExposure += 1;
      node.rewardHistory.push(...res.rewards);

      // Hitung mean reward dan variance
      const n = node.rewardHistory.length;
      const mean = node.rewardHistory.reduce((a, b) => a + b, 0) / n;
      const variance = node.rewardHistory.reduce((acc, r) => acc + Math.pow(r - mean, 2), 0) / n;

      // Mean-corrected dispersion: d = variance / (mean * (1 - mean) + 1e-5)
      const maxVar = Math.max(1e-5, mean * (1 - mean));
      const dispersion = variance / maxVar;

      node.meanReward = mean;
      node.rewardVariance = variance;
      node.meanCorrectedDispersion = dispersion;
    }
  }

  /**
   * Memprediksi Informativeness (Reward Variance) via Propagasi Dual-Relation Graph
   */
  public predictInformativeness(taskId: string): number {
    const node = this.nodes.get(taskId);
    if (!node) return 0;

    // Jika node memiliki riwayat rollout yang cukup (>= 5), gunakan variance historisnya
    if (node.rolloutCount >= 5) {
      return node.rewardVariance;
    }

    // Jika unobserved atau underobserved, propagasikan estimasi dari tetangga terdekat
    let withinVarianceSum = 0;
    let withinWeightSum = 0;
    const withinNeighbors = this.withinEdges.get(taskId) || [];
    for (const edge of withinNeighbors) {
      const neighbor = this.nodes.get(edge.targetId);
      if (neighbor && neighbor.rolloutCount > 0) {
        withinVarianceSum += neighbor.rewardVariance * edge.weight;
        withinWeightSum += edge.weight;
      }
    }

    let crossVarianceSum = 0;
    let crossWeightSum = 0;
    const crossNeighbors = this.crossEdges.get(taskId) || [];
    for (const edge of crossNeighbors) {
      const neighbor = this.nodes.get(edge.targetId);
      if (neighbor && neighbor.rolloutCount > 0) {
        crossVarianceSum += neighbor.rewardVariance * edge.weight;
        crossWeightSum += edge.weight;
      }
    }

    const withinEstimate = withinWeightSum > 0 ? withinVarianceSum / withinWeightSum : 0.02;
    const crossEstimate = crossWeightSum > 0 ? crossVarianceSum / crossWeightSum : 0.02;

    // Graph Prior: Bobot seimbang antara within-environment dan cross-environment
    const graphPrior = 0.6 * withinEstimate + 0.4 * crossEstimate;

    if (node.rolloutCount === 0) {
      return graphPrior;
    }

    // Fusi antara graph prior dan data lokal yang terbatas
    const alpha = node.rolloutCount / 5;
    return alpha * node.rewardVariance + (1 - alpha) * graphPrior;
  }

  /**
   * Memilih Batch Rollout untuk Iterasi Pelatihan RL Berikutnya
   * Menyeimbangkan Coverage (50%) dan Exploitation Informativeness (50%)
   */
  public sampleBatch(batchSize: number): EnvironmentTaskNode[] {
    const selectedNodes: EnvironmentTaskNode[] = [];
    const envCounts: Map<string, number> = new Map();
    const candidatePool = Array.from(this.nodes.values());

    const numCoverage = Math.floor(batchSize * this.coverageRatio);
    const numExploit = batchSize - numCoverage;

    // 1. Coverage Phase: Prioritaskan environment yang underobserved & task yang jarang dicoba
    candidatePool.sort((a, b) => {
      // Prioritas 1: Lingkungan dengan eksposur kumulatif terkecil
      if (a.cumulativeExposure !== b.cumulativeExposure) {
        return a.cumulativeExposure - b.cumulativeExposure;
      }
      // Prioritas 2: Task dengan rollout count terkecil
      return a.rolloutCount - b.rolloutCount;
    });

    for (const node of candidatePool) {
      if (selectedNodes.length >= numCoverage) break;
      const count = envCounts.get(node.envId) || 0;
      if (count < this.maxBatchPerEnv) {
        selectedNodes.push(node);
        envCounts.set(node.envId, count + 1);
      }
    }

    // 2. Exploitation Phase: Prioritaskan task dengan predicted reward variance tertinggi
    const remainingCandidates = candidatePool.filter(n => !selectedNodes.includes(n));
    remainingCandidates.sort((a, b) => {
      const varA = this.predictInformativeness(a.id);
      const varB = this.predictInformativeness(b.id);

      // Terapkan exposure discount factor: (1 + c_{i,t} / c_0)^(-1/2)
      const discountA = Math.pow(1 + a.cumulativeExposure / this.exposureHalfLife, -0.5);
      const discountB = Math.pow(1 + b.cumulativeExposure / this.exposureHalfLife, -0.5);

      return (varB * discountB) - (varA * discountA);
    });

    for (const node of remainingCandidates) {
      if (selectedNodes.length >= batchSize) break;
      const count = envCounts.get(node.envId) || 0;
      if (count < this.maxBatchPerEnv) {
        selectedNodes.push(node);
        envCounts.set(node.envId, count + 1);
      }
    }

    return selectedNodes;
  }
}
6. Panduan Praktis & Checklist Implementasi bagi AI Platform Engineers
Jika organisasi Anda sedang membangun atau mengoptimalkan pipeline post-training untuk autonomous AI agents, terapkan tiga prinsip rekayasa berikut:
Gantikan Prompt Sampling dengan Environment-Task Pairs
Jangan pernah melakukan sampling prompt tanpa mengikatnya pada identitas lingkungan simulasi dan spesifikasi schema verifier. Lingkungan adalah penentu utama struktur transisi dan tingkat kesulitan evaluasi.
Audit Zero-Variance Rollouts Secara Real-Time
Pantau metrik variansi reward intra-batch. Jika lebih dari 40% batch menghasilkan variansi nol (seluruh rollout sukses atau seluruh rollout gagal), segera lakukan penyesuaian scheduler untuk menghentikan pembakaran GPU sia-sia.
Pertahankan 50:50 Coverage vs Exploitation Ratio
Eksploitasi murni terhadap tugas dengan variansi tinggi akan menjebak model pada pola spesifik. Alokasikan minimal 50% kuota batch untuk eksplorasi lingkungan baru guna menjamin kemampuan generalisasi zero-shot.
Referensi & Sumber Terverifikasi
- [1]EnvSched: Environment-Aware Scheduling for Rollout-Efficient Agent Reinforcement Learning(arXiv:2610.37609 [cs.LG, cs.AI] — Sihan Yang, Weichen Bai, Ruichuan An, Yiming Cheng, Zhiyuan Feng, Tianyi Jiang, Renye Yan, Ning Ding, Yifan Zhang, Renrui Zhang, Yehui Tang, Wentao Zhang (Peking University, Xi'an Jiaotong University, Tsinghua University, Samsung Research, CASIA, CUHK))
- [2]Berkeley Function-Calling Leaderboard (BFCL-v3) & Multi-Turn Benchmark Evaluation(Gorilla LLM & UC Berkeley — Shishir G. Patil et al.)
- [3]tau-Bench: A Benchmark for Tool-Agent Users in Dynamic Stateful Environments(Sierra Research & Stanford University)
- [4]ACEBench-Agent: Evaluating Multi-Step Autonomous Agent Execution in Enterprise APIs(arXiv — Tsinghua University & Alibaba Cloud)
- [5]DeepSeek-V3 Technical Report: Large-Scale Post-Training and Agentic Scaling Laws(DeepSeek AI Research)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Heads of Security (arXiv:2610.37657): Learned Attention Gates untuk Robustness Prompt Injection — Pemisahan Instruksi-Data via 46K Parameter, Reduksi ASR RL-Hammer 97% ke 10%, dan Preservasi Utilitas Tool Calling
Analisis arsitektural riset frontier Imperial College London, Tübingen AI Center, ELLIS Institute, Max Planck, dan Fraunhofer HHI (arXiv:2610.37657, Igor Shilov, Xiaoxue Yang, Alexander Panfilov, Jonas Geiping, Yves-Alexandre de Montjoye): Mengapa metode finetuning (SecAlign++) dan arsitektural masif (ASIDE) gagal menjaga utilitas few-shot dan merusak kapabilitas tool use agen, bagaimana Heads of Security (HoS) merekayasa pemisahan instruksi-data hanya dengan 46.080 scalar gate logits per-head (0.00006% parameter model), menahan serangan adaptive RL-Hammer hingga ASR tersisa 1-10% (vs 82-97%), memaksa serangan white-box Claudini membutuhkan 3x lipat komputasi FLOPs, dan implementasi arsitektur inference gating siap produksi.
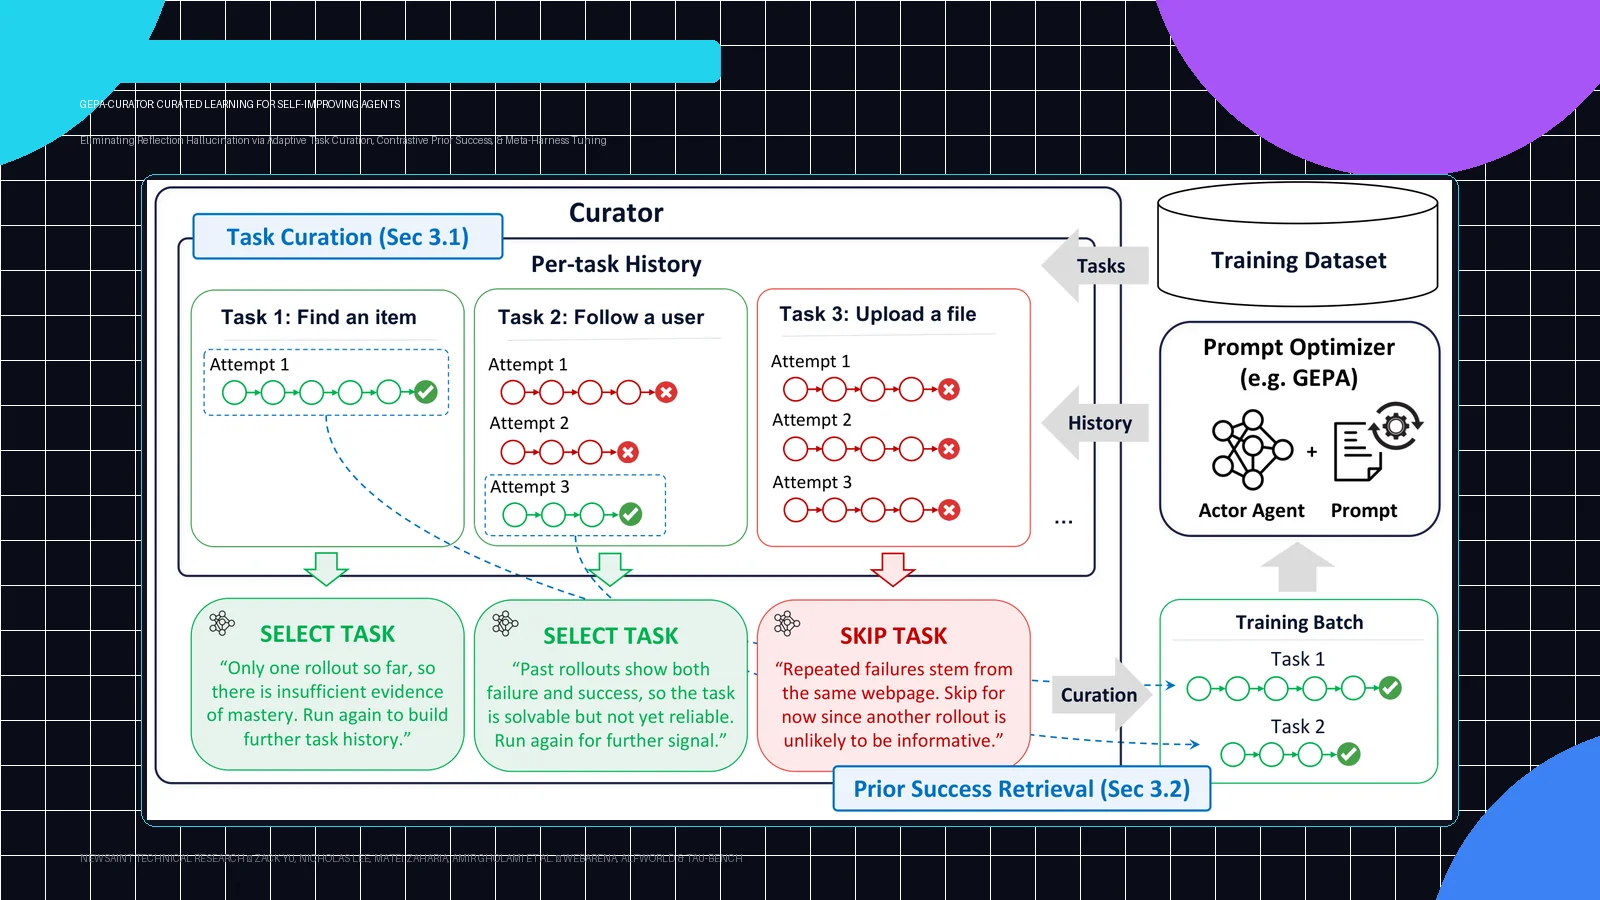
GEPA-Curator (arXiv:2610.37651): Mengeliminasi Halusinasi Refleksi pada Self-Improving AI Agents via Adaptive Task Curation, Contrastive Prior Success, dan Meta-Harness Optimization
Analisis arsitektural riset frontier UC Berkeley, Furiosa AI, dan KAIST (arXiv:2610.37651, Zack Yu, Nicholas Lee, Matei Zaharia, Amir Gholami): Mengapa optimasi prompt reflektif (GEPA, ACE) rentan mengalami misatribusi kegagalan akibat keterbatasan harness dan kelemahan lingkungan eksternal, bagaimana GEPA-Curator menyaring tugas bising via Adaptive Task Curation dan menyajikan trajektori sukses kontrastif (Prior Success Retrieval), menghasilkan lonjakan akurasi hingga +21.2% di AppWorld dan WebArena, serta implementasi outer-loop harness siap produksi.
Economics of Reasoning Effort pada LLM Agents (arXiv:2610.34491): Dilema Credence Good, Inflasi Biaya 42x, Regresi Akurasi Instance-Level, dan Arsitektur Adaptive Escalation
Analisis arsitektural dan implikasi rekayasa dari riset arXiv:2610.34491 (Kaiser Sun, Yongchan Kwon, Zain Hasan, Shang Zhu, Kaitlyn Zhou, Federico Bianchi): Mengapa reasoning effort merupakan credence good ekonomi yang memicu inflasi biaya hingga 42x pada tugas mudah, mengapa set solusi tidak bersarang (non-nested regressions), fenomena hyper-verification pada trajektori agen o1/o3/R1, dan implementasi arsitektur adaptive laddering escalation siap produksi.