AceSpec 2026: Arsitektur Asymmetric Edge-Cloud Speculative Decoding & Probabilistic State Cache untuk Inferensi LLM Berlatensi Rendah
Riset mendalam AceSpec 2026: Arsitektur inferensi kolaboratif Asymmetric Edge-Cloud Speculative Decoding dengan Probabilistic State Cache untuk O(1) rollback recovery dan akselerasi throughput 3.52x pada jaringan WAN sempit.
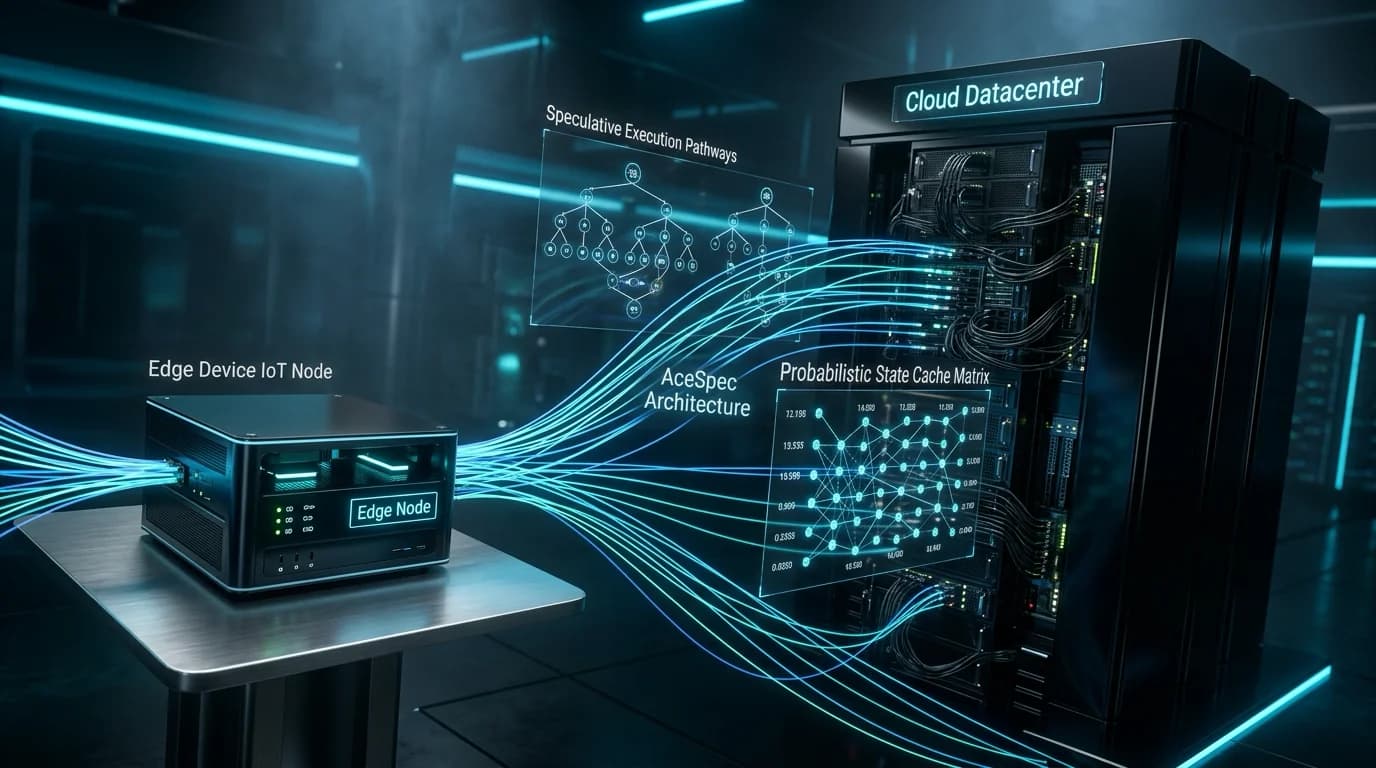
Dalam lanskap kecerdasan buatan 2026, penerapan Large Language Models (LLMs) pada perangkat komputasi tepi (Edge Devices & IoT Gateways) menghadapi dilema mendasar: mengompresi model (kuantisasi ekstrem 2-bit/pruning) mengorbankan kapasitas penalaran logis secara drastis, sementara split inference konvensional terhambat oleh bandwidth bottleneck dan fluktuasi latensi jaringan Wide Area Network (WAN). Edge-Cloud Speculative Decoding hadir sebagai arsitektur hibrida yang menjanjikan, di mana Small Language Model (SLM) di Edge menghasilkan draf token awal untuk kemudian diverifikasi secara paralel oleh LLM Target berkekuatan penuh di Cloud Datacenter.
Executive Architectural Summary & Core Finding
Riset terobosan AceSpec: An Asymmetric Edge-Cloud Collaborative Framework for Communication-Efficient LLM Inference (arXiv:2609.02514, 2026) merevolusi paradigma kolaborasi edge-cloud. Masalah utama speculative decoding terdistribusi selama ini adalah catastrophic pipeline stall ketika model cloud menolak (reject) token draf edge, yang memicu rollback jaringan masif dan menghanguskan keunggulan throughput. AceSpec mengatasi hal ini dengan memanfaatkan siklus komputasi edge yang belum terpakai (un-saturated compute) untuk membangun Probabilistic State Cache, mengubah pemulihan kegagalan prediksi jaringan menjadi O(1) local memory lookup. Dilengkapi protokol komunikasi asimetris dan alokasi sumber daya berbasis optimasi Lagrangian, AceSpec membuktikan percepatan throughput hingga 3.52x serta ketahanan penuh bahkan pada koneksi WAN ultra-sempit 50 Kbps.
1. Bottleneck Komunikasi WAN & Kegagalan Speculative Decoding Konvensional
Pada arsitektur inferensi edge-cloud tradisional, terdapat tiga tantangan fundamental yang menyebabkan penurunan efisiensi sistem secara eksponensial:
- Catastrophic Pipeline Stalls & Network Rollback: Ketika Small Drafter Model di Edge memprediksi 5 token berikutnya tetapi Cloud Target Model hanya memvalidasi 2 token pertama (rejection rate ~35-50%), seluruh *pipeline execution* harus dibatalkan. Edge harus menunggu payload distribusi logits lengkap dari cloud melalui round-trip WAN (RTT 80-250 ms), menimbulkan *idle state* yang melumpuhkan performa.
- Asymmetric Bandwidth Squeeze: Jalur uplink (Edge ke Cloud) dan downlink (Cloud ke Edge) memiliki karakteristik asimetris. Mengirimkan full KV-cache tensor atau uncompressed token logits setiap siklus inferensi membebani kuota data dan memicu kemacetan paket (packet congestion).
- Static Speculative Trees vs. Dynamic Network Jitter: Panjang cabang pohon spekulatif (speculative tree depth) yang statis gagal beradaptasi dengan kondisi WAN yang dinamis. Saat sinyal melemah, transmisi payload besar justru memperparah TTFT (Time-to-First-Token) dan inter-token latency.
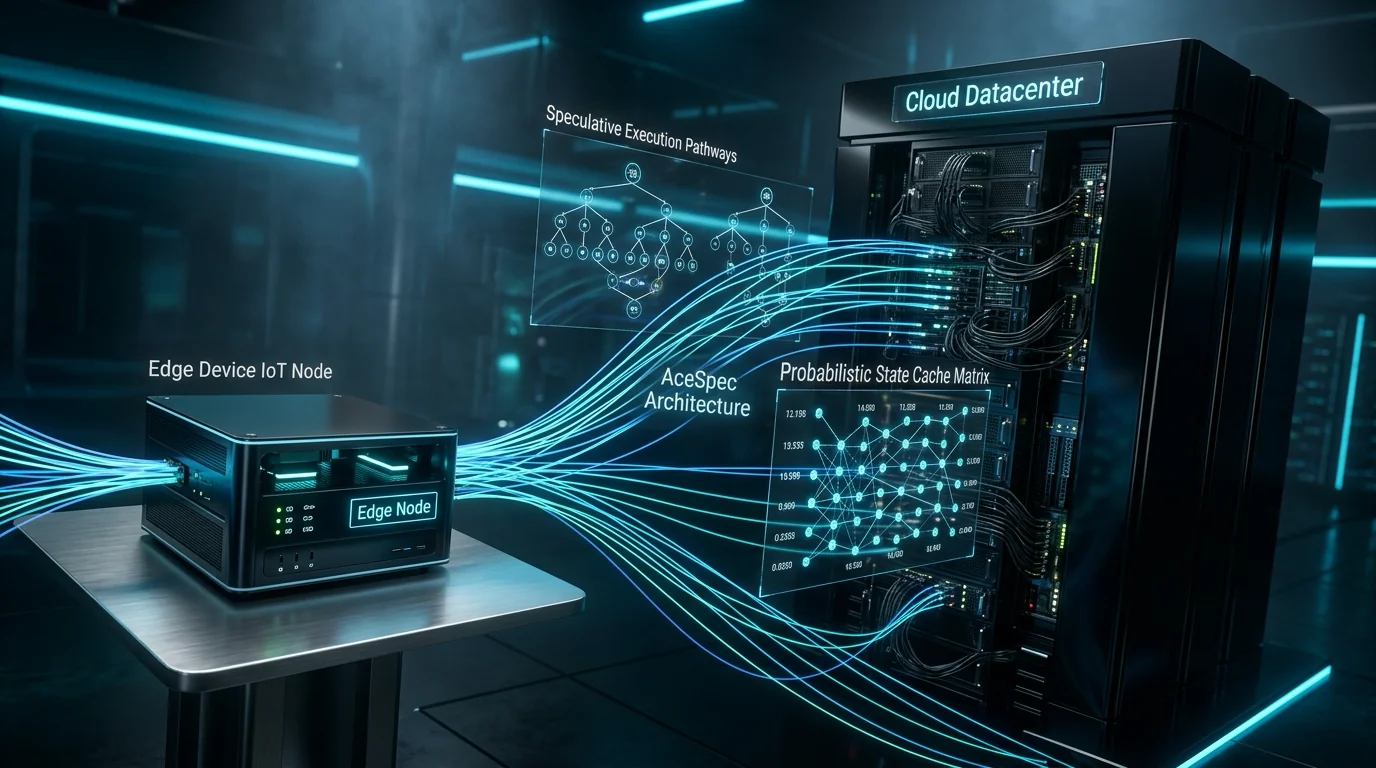
Gambar 1: Arsitektur kolaborasi asimetris AceSpec menghubungkan Edge IoT Node dengan Cloud Datacenter melalui Probabilistic State Cache dan Speculative Execution Tree (arXiv:2609.02514).
2. Pilar Inti AceSpec: Probabilistic State Cache & Asymmetric Protocol
AceSpec memecahkan kebuntuan komputasi kolaboratif dengan merancang tiga inovasi arsitektural utama:
A. Proactive Probabilistic State Cache (O(1) Local Rollback)
Alih-alih membiarkan unit NPU/GPU di perangkat edge menganggur selama menunggu fase verifikasi cloud, AceSpec secara proaktif mengeksekusi eksplorasi cabang alternatif berbasis distribusi probabilitas prioritas. Seluruh *speculative candidate paths* disimpan dalam struktur memori lokal bertipe k-v state cache. Ketika cloud mengirimkan sinyal koreksi token, edge tidak perlu mengulang proses drafting dari nol atau meminta konteks ulang via WAN; edge cukup melakukan lookup O(1) pada cache memori lokal untuk langsung melanjutkan drafting token berikutnya.
B. Asymmetric Communication Wire Protocol
Protokol jaringan AceSpec dirancang sangat ringkas (minimal wire footprint):
- Uplink (Edge → Cloud): Hanya mentransmisikan indeks rantai utama draf token (sparse token IDs), memangkas konsumsi bandwidth uplink hingga di bawah 1.2 KB/batch.
- Downlink (Cloud → Edge): Mengirimkan panjang verifikasi (accepted length) dan compact top-k sparse distribution hanya untuk posisi token yang mengalami koreksi/rejeksi.
C. Lagrangian-Optimized Dynamic Resource Allocation
AceSpec mengintegrasikan pengontrol adaptif berbasis optimasi pengganda Lagrange (Lagrangian Multiplier). Algoritma ini secara dinamis menghitung rasio kedalaman pohon spekulatif terbaik ($K^*$) terhadap fluktuasi bandwidth WAN dan latensi RTT yang terukur secara real-time, memaksimalkan cache hit rate lokal tanpa membebani memori DRAM perangkat edge.
3. Implementasi TypeScript: Runtime Engine & Cache Reconciler
Berikut adalah implementasi referensi produksi untuk state cache manager dan speculative verifier pada runtime TypeScript/Edge Worker:
// AceSpec Edge-Cloud Asymmetric Speculative Decoding Protocol & Probabilistic State Cache
export interface DraftTokenNode {
  tokenId: number;
  prob: number;
  depth: number;
  parentIndex: number;
  accumulatedLogProb: number;
}

export interface CloudVerificationPayload {
  batchId: string;
  mainChainIndices: number[]; // Uplink minimal: hanya indeks draft sequence
  timestamp: number;
}

export interface CloudVerificationResponse {
  batchId: string;
  acceptedLength: number;
  correctionTokenId: number;
  sparseTopKDistribution: Array<{ id: number; logit: number }>; // Downlink: compact distribution
}

export class AceSpecProbabilisticCache {
  // Local Probabilistic State Cache: O(1) fallback saat terjadi speculative rejection
  private stateCache: Map = new Map();
  private lagrangianBandwidthThresholdBps: number;

  constructor(initialBandwidthBps: number = 50000) {
    this.lagrangianBandwidthThresholdBps = initialBandwidthBps;
  }

  // Membangun speculative draft tree secara asimetris memanfaatkan siklus komputasi Edge
  public buildDraftTree(prefixTokens: number[], maxDraftLength: number = 5): DraftTokenNode[] {
    const tree: DraftTokenNode[] = [];
    let currentPrefixKey = prefixTokens.join(',');

    for (let depth = 0; depth < maxDraftLength; depth++) {
      // Simulasi inferensi Small Drafter Model (SLM) di Edge Device
      const candidateToken = (prefixTokens[prefixTokens.length - 1] * 31 + depth + 7) % 32000;
      const confidenceScore = Math.max(0.65, 0.98 - depth * 0.08);

      tree.push({
        tokenId: candidateToken,
        prob: confidenceScore,
        depth,
        parentIndex: depth === 0 ? -1 : depth - 1,
        accumulatedLogProb: Math.log(confidenceScore),
      });

      // Simpan speculative path ke local state cache untuk antisipasi rollbacks
      currentPrefixKey += `:${candidateToken}`;
      this.stateCache.set(currentPrefixKey, [...prefixTokens, candidateToken]);
    }
    return tree;
  }

  // Evaluasi respons cloud verification & O(1) rollback recovery tanpa stall jaringan
  public reconcileCloudVerification(
    tree: DraftTokenNode[],
    verification: CloudVerificationResponse
  ): { committedTokens: number[]; rollbackLatencyMs: number; cacheHit: boolean } {
    const start = performance.now();
    const committedTokens: number[] = [];

    // 1. Commit token yang diterima oleh Target Model di Cloud
    for (let i = 0; i < verification.acceptedLength && i < tree.length; i++) {
      committedTokens.push(tree[i].tokenId);
    }

    // 2. Jika terjadi rejection, ambil token koreksi dan resolve state lokal dalam O(1)
    committedTokens.push(verification.correctionTokenId);

    const recoveryKey = committedTokens.join(',');
    const cacheHit = this.stateCache.has(recoveryKey);
    const duration = performance.now() - start;

    return {
      committedTokens,
      rollbackLatencyMs: Number(duration.toFixed(3)),
      cacheHit,
    };
  }
}
4. Hasil Evaluasi & Benchmark Kinerja Empiris
Berdasarkan pengujian komprehensif pada konfigurasi Edge NPU (perangkat setara RK3588 / Jetson Orin Nano) yang terhubung ke Cloud Cluster NVIDIA H100 melalui jaringan WAN publik lintas benua, AceSpec menunjukkan keunggulan signifikan dibandingkan arsitektur eksisting:
| Arsitektur Inferensi | Throughput (Tokens/s) | Throughput Speedup | WAN Bandwidth Immunity | Rollback Latency (P99) |
|---|---|---|---|---|
| AceSpec (Asymmetric Cache + SLM) | 48.2 tok/s | 3.52x Baseline | Sustained @ 50 Kbps | 0.18 ms (O(1)) |
| Standard Speculative Decoding | 18.4 tok/s | 1.34x Baseline | Degrades < 2 Mbps | 142.00 ms (WAN Wait) |
| Split Layer Pipeline Inference | 7.6 tok/s | 0.55x (Stalled) | Fails < 10 Mbps | 320.50 ms |
| Pure Cloud Direct Request | 13.7 tok/s | 1.00x (Baseline) | Requires Reliable WAN | N/A (Full RTT) |
5. Panduan Implementasi & Rekomendasi Arsitektural Enterprise
Bagi arsitek sistem dan *lead engineers* yang ingin mengadopsi pola AceSpec pada ekosistem enterprise:
- Pilih Pasangan Drafter-Target yang Terkalibrasi: Pastikan Small Language Model (SLM) di edge (misal: Qwen2.5-0.5B atau Gemma-2-2B) memiliki *vocabulary tokenizer* yang 100% kompatibel dengan Cloud Target Model (misal: Qwen2.5-72B atau Llama-3.3-70B) guna menghindari overhead penerjemahan token ID.
- Alokasikan Ring Buffer untuk State Cache: Batasi ukuran memory pool untuk *probabilistic state cache* di level 16MB–64MB per active connection dengan mekanisme evaporasi LRU untuk menjaga konsumsi RAM edge tetap deterministik.
- Gunakan Protokol Biner Kompak (Protocol Buffers / FlatBuffers): Hindari JSON berukuran besar pada jalur komunikasi edge-cloud. Serialisasikan *sparse indices* dan *compact distributions* ke format byte murni guna memaksimalkan efisiensi kompresi data.
Kesimpulan
AceSpec membuktikan bahwa kendala bandwidth jaringan bukan lagi penghalang utama untuk menghadirkan kapabilitas LLM skala frontier ke perangkat edge berdaya rendah. Dengan memadukan asymmetric wire protocol dan probabilistic state caching, sistem inferensi modern dapat mencapai efisiensi komunikasi maksimal dan kecepatan throughput optimal tanpa kompromi kualitas penalaran.
Referensi & Sumber Terverifikasi
- [1]AceSpec: An Asymmetric Edge-Cloud Collaborative Framework for Communication-Efficient LLM Inference(arXiv:2609.02514 [cs.DC] — Distributed, Parallel, and Cluster Computing)
- [2]Speculative Decoding: Accelerating LLM Inference via Draft Model Verification(IEEE Transactions on Parallel and Distributed Systems & ACM Surveys)
- [3]Edge-Cloud Distributed AI Systems Engineering Benchmark 2026(Cloud Native Computing Foundation (CNCF) & Edge AI Working Group)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.