VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

VenusRL: Sistem Agentic RL Terdisagregasi Penuh dengan Priority Scheduling dan Scalable Sandbox Multiplexing
Pelatihan model bahasa fondasi berbasis agen otonom (Agentic Reinforcement Learning) melalui interaksi multi-turn dengan lingkungan eksternal (bash terminal, web browser, interpreter kode) kini menjadi pilar utama di balik model penalaran seperti OpenAI o-series, Claude 3.7 Sonnet Thinking, dan Qwen3 Thinking. Namun, sifat interaktif multi-turn menghadirkan dua bottleneck sistemik ekstrem pada kluster pelatihan berskala masif: Pertama, Group Completion Barrier: algoritma optimasi RL kontemporer (seperti GRPO dan PPO) mereplikasi setiap prompt menjadi satu kelompok berisi $K$ lintasan rollout (misal $K=8$) untuk kalkulasi advantage. Batch pelatihan terhambat oleh lintasan paling lambat (straggler trajectory). Pendekatan penjadwalan saat ini (Slime, RollFlash) hanya berfokus pada saturasi utilisasi GPU rollout per-slot, sehingga kemajuan rollout tercecer ke terlalu banyak kelompok sampel dan menahan komputasi gradien pada GPU trainer. Kedua, Sandbox Memory Stranding: lingkungan eksekusi (microVM seperti E2B dan Firecracker) dialokasikan secara statis berdasarkan kuota memori deklaratif (misal 4GB per sandbox), menyebabkan hingga 90% memori fisik host terdampar menganggur, padahal ribuan sandbox yang berasal dari template prompt yang sama mengeksekusi kode setup yang nyaris identik. Untuk mendobrak keterbatasan ini, sebuah konsorsium periset dari Tsinghua University, RISys Lab, dan ByteDance (arXiv:2610.03286) merilis VenusRL: arsitektur sistem agentic RL pertama yang terdisagregasi secara penuh. Dengan memperkenalkan Priority-Aware Action Scheduler dan Environment Resource Manager berbasis Intra-Group Page Sharing, VenusRL berhasil mencatatkan percepatan throughput pelatihan hingga 4.24x, melipatgandakan densitas sandbox per node sebesar 905% (dari 100 menjadi 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU sebesar 89% pada pengujian 32 GPU Hopper.
1. Paradoks Agentic RL: Mengapa Utilisasi GPU Tinggi Tidak Menjamin Kecepatan Pelatihan?
Dalam pelatihan LLM tradisional (single-turn reasoning atau pre-training), komputasi bersifat deterministik: setiap request menghasilkan token hingga batas akhir tertentu tanpa jeda eksternal. Namun, dalam Agentic RL, agen berulang kali mengeksekusi pola aksi: menghasilkan tool call, menunggu lingkungan merespons, memproses observasi baru, lalu melanjutkan rantai penalaran hingga 300 putaran interaksi.
Arsitektur generasi sebelumnya (seperti RollFlash) memperkenalkan penjadwalan level-aksi (action-level scheduling) untuk menutupi gelembung latensi alat (tool execution bubble). Saat satu agen menunggu eksekusi terminal bash, slot GPU dialihkan untuk melayani token generasi agen lain. Sekilas, metrik GPU utilization terlihat mencapai 95-99%. Namun, para insinyur menemukan paradoks yang membingungkan di kluster produksi: kecepatan pelatihan end-to-end justru macet parah.
Penyebab utamanya terletak pada formulasi matematika optimasi grup GRPO/PPO:
Di sini, $B$ adalah ukuran batch micro-step trainer. Satu kelompok sampel $g = {r_{g,1}, dots, r_{g,K}}$ baru dapat dikirim ke worker training setelah seluruh $K$ lintasan dalam kelompok tersebut selesai. Jika penjadwal mendistribusikan slot komputasi secara merata ke puluhan kelompok baru tanpa memprioritaskan kelompok yang hampir selesai, waktu tunggu batch berikutnya ($T_{ ext{next}}$) membengkak tajam. Lebih buruk lagi, membuka terlalu banyak lintasan aktif secara bersamaan memicu perebutan memori KV Cache, menyebabkan eviksi paksa dan overhead re-prefill yang masif.
2. Priority-Aware Action Scheduler: Mengurai Hambatan Straggler Group
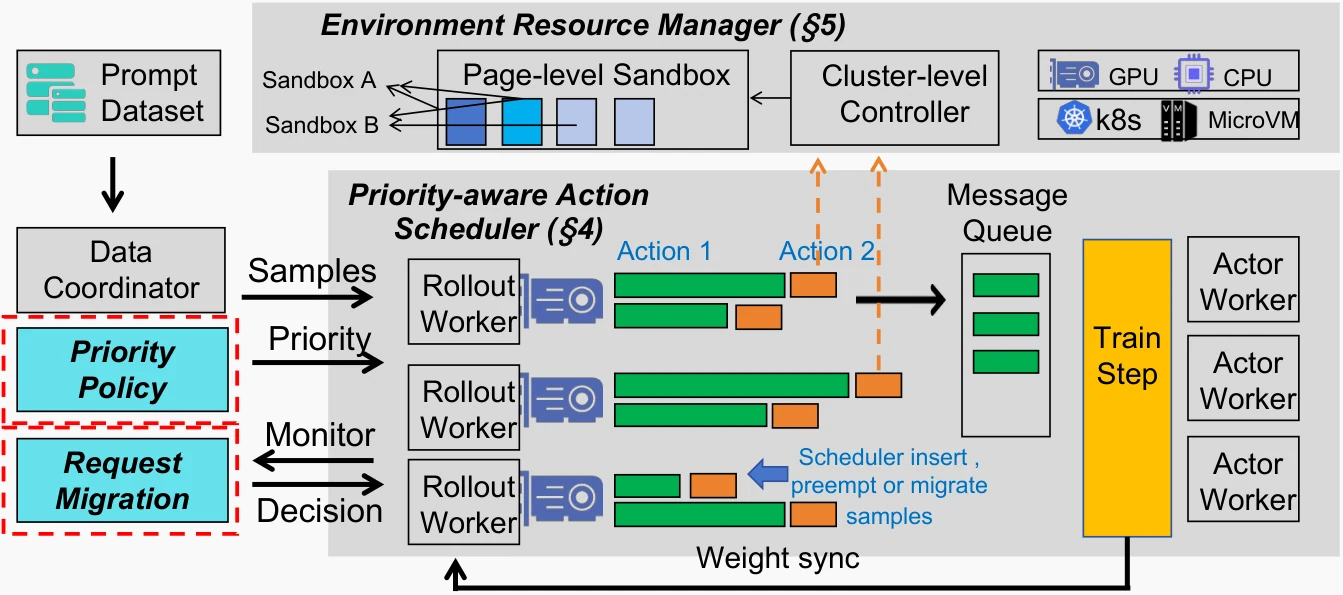
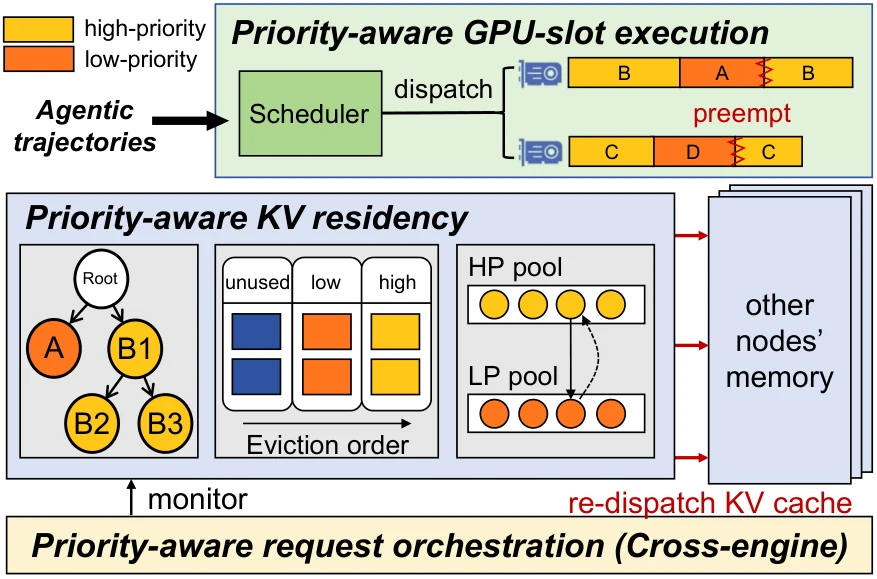
VenusRL memecahkan dilema penjadwalan ini melalui mekanisme Priority-Aware Action Scheduler yang beroperasi pada tiga dimensi komputasi:
Menggunakan model prediksi panjang ringan berbasis Random Forest yang mengevaluasi panjang prompt awal dan pola token pada putaran-putaran awal. VenusRL secara dinamis mengidentifikasi subkumpulan grup yang penyelesaiannya paling instan membuka batch pelatihan berikutnya.
Sampel dari grup prioritas rendah dieksekusi secara oportunistik hanya ketika slot GPU berpotensi idle. Begitu lintasan prioritas tinggi kembali dari eksekusi alat eksternal, scheduler langsung memberikan slot komputasi secara preemptif.
Ketika terjadi ketidakseimbangan beban kerja antar rollout worker, VenusRL dapat memigrasikan request prioritas tinggi ke worker lain yang memiliki slot kosong, menghindari penumpukan antrean lokal.
3. Trajectory-Aware Radix Cache: Eliminasi Eviksi Paksa pada Siklus Multi-Turn
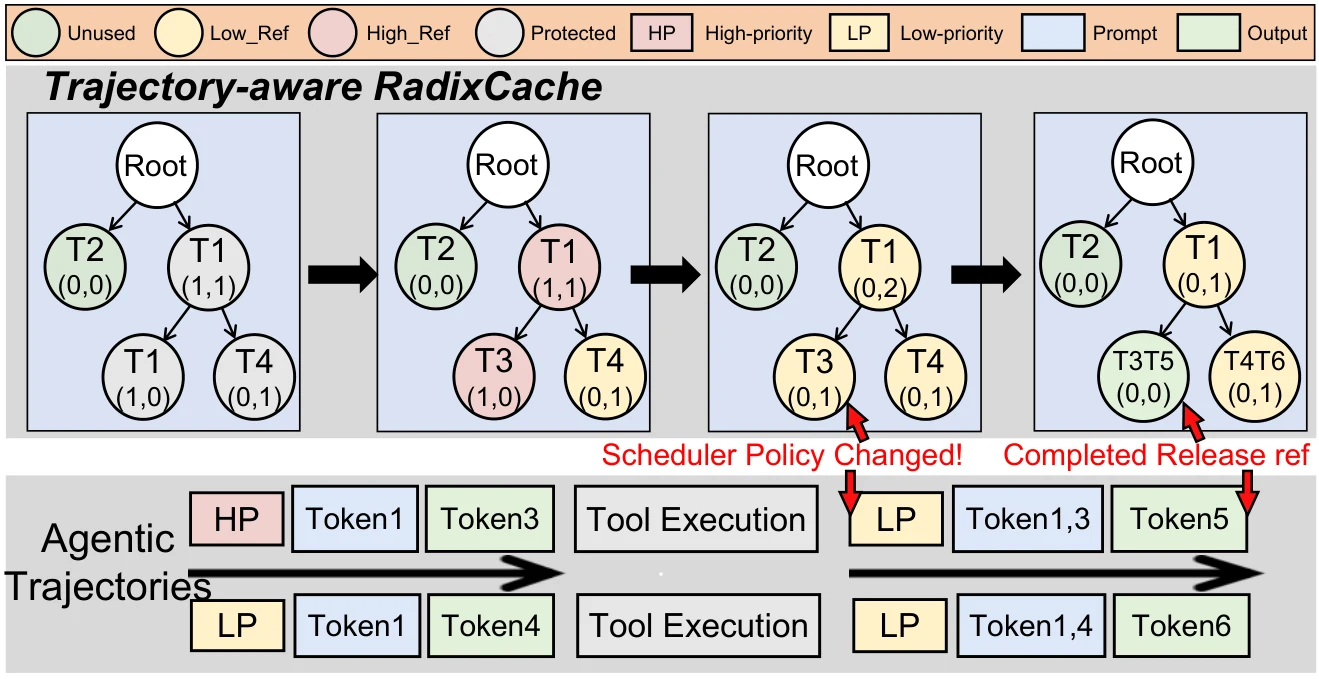
Pada sistem serving standar seperti SGLang, mekanisme RadixAttention mengelola cache KV menggunakan pohon radix berbasis LRU (Least Recently Used). Namun, pada pelatihan agentic RL, asumsi LRU runtuh: lintasan yang sedang menunggu respons dari lingkungan (bisa memakan waktu 2–10 detik) memiliki akses timestamp yang tua. Akibatnya, cache KV lintasan tersebut sering kali dieviksi oleh request baru yang tiba.
Saat respons alat akhirnya kembali, rollout worker terpaksa menghitung ulang seluruh prefix KV dari awal (re-prefill penalty), yang membuang puluhan teraflops komputasi GPU.
VenusRL merevolusi ini dengan Trajectory-Aware Radix Cache. Pohon radix kini melacak keterikatan kelompok (group membership) dan skor prioritas lintasan. Node cache milik lintasan prioritas tinggi diberi pin residensi khusus (retention guard), melindunginya dari algoritma eviksi selama jeda interaksi lingkungan berlangsung.
4. Environment Resource Manager: Lompatan Densitas Sandbox hingga 905%
Biaya non-GPU dalam pelatihan agentic RL sering kali diabaikan, padahal menjalankan puluhan ribu instans sandbox per hari menelan biaya infrastruktur cloud yang luar biasa. Kerangka kerja seperti E2B dan Firecracker menggunakan Linux userfaultfd untuk mengisi halaman memori dari snapshot secara lazy. Artinya, halaman fisik hanya dialokasikan saat pertama kali disentuh oleh proses guest.
Meskipun deklarasi memori virtual per sandbox disetel ke 4GB, penggunaan fisik sebenarnya sering kali hanya 200–400MB. Namun, alokasi konvensional bersifat konservatif: pada node server dengan 400GB RAM, sistem menolak instansiasi baru setelah mencapai 100 sandbox (karena batas 100 x 4GB = 400GB tercapai), menyebabkan 80–90% RAM fisik menganggur (stranded memory).
VenusRL menerapkan solusi tingkat kernel yang elegan:
- Dynamic Admission Threshold Adaptation (Algoritma 1): Node menerima sandbox baru berdasarkan footprint fisik aktual ditambah estimasi laju pertumbuhan memori aktif, bukan kuota virtual. Sistem dilengkapi mekanisme fallback sandbox migration jika terjadi lonjakan memori tak terduga.
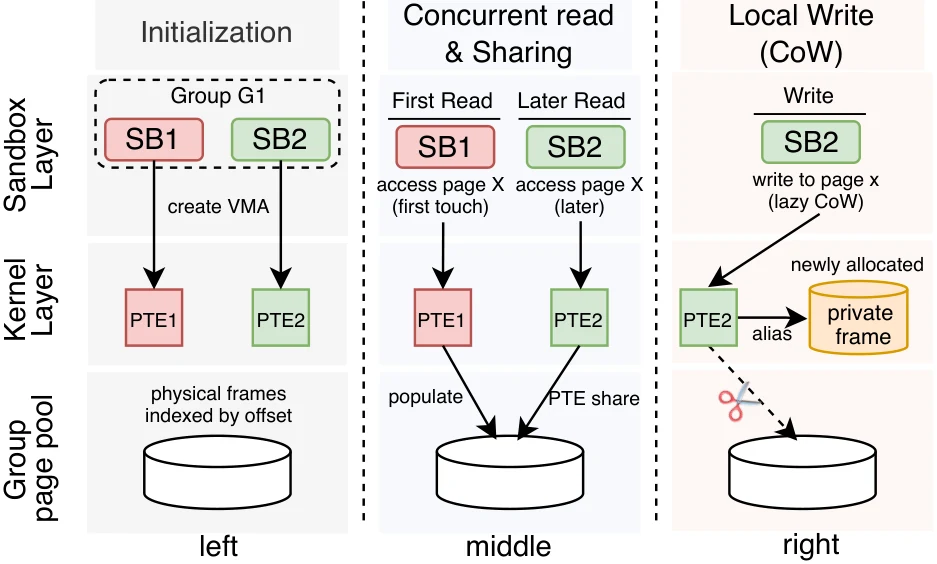
- Intra-Group Page Sharing: Karena seluruh $K$ lintasan dalam satu grup GRPO diluncurkan dari prompt dan template lingkungan yang sama, proses inisialisasi mengeksekusi kode setup, import pustaka Python, dan dependensi OS yang identik. VenusRL memisahkan kepemilikan alamat virtual dari residensi halaman fisik melalui write-protected Page Table Entry (PTE) aliasing. Seluruh sandbox membaca dari frame fisik memori yang sama; pemisahan halaman fisik hanya terjadi saat ada modifikasi lokal melalui Copy-on-Write (CoW).
5. Hasil Evaluasi Empiris: Tolok Ukur Kecepatan Pelatihan dan Penghematan Biaya
VenusRL diimplementasikan dengan 24.000 baris kode gabungan Python, Rust, dan Golang, diuji secara komprehensif pada kluster 32 GPU NVIDIA Hopper (16 GPU dialokasikan untuk rollout inferensi dan 16 GPU untuk pelatihan bobot model) yang saling terhubung melalui 900 GB/s NVLink dan 400 Gb/s Mellanox InfiniBand. Model yang dievaluasi mencakup Qwen3-4B dan Qwen3-32B pada dataset SWE-agent OpenSWE yang memuat 45.320 lingkungan Docker executable dengan batas 128K context window dan 300 putaran per lintasan.
| Konfigurasi Pengujian | Baseline (Slime / RollFlash) | VenusRL | Peningkatan Performa |
|---|---|---|---|
| End-to-End Training Speedup | 1.00x | 1.06x – 4.24x | Hingga +324% Lebih Cepat |
| Densitas Sandbox per Node (400GB) | 100 sandbox (E2B Saturation) | 905 sandbox | +905% (9.05x Density) |
| Efisiensi Biaya Non-GPU Sandbox | $100% Baseline Expense | 11% Expense | -89% Pemotongan Biaya |
| KV Cache Hit Ratio Multi-Turn | 38.4% (Tergusur Eviksi) | 79.2% | +106% Retensi Cache |
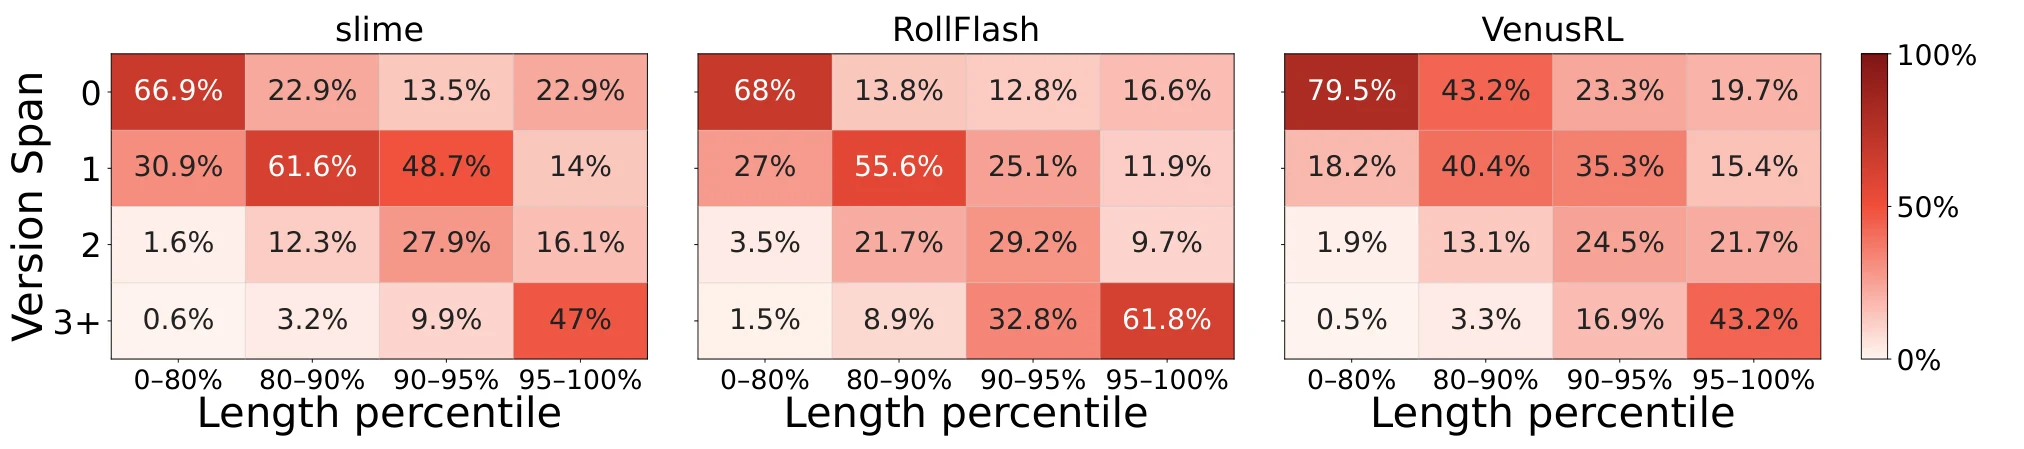
| Weight Staleness Degradation | Tinggi (>3 version lag) | Minimal (≤1 version lag) | Stabilitas Konvergensi Optimal |
6. Implementasi Arsitektur Sistem: Scheduler & Memory Manager
Berikut adalah implementasi referensi modul TypeScript untuk mengintegrasikan logika penjadwalan grup kritis dan manajemen page-sharing sandbox ke dalam pipeline orchestrator agen berskala besar:
// Production Architecture: VenusRL Priority-Aware Scheduler & Page-Sharing Sandbox Manager
// Berdasarkan Arsitektur Sistem VenusRL (arXiv:2610.03286 - Oktober 2026)
//
// Karakteristik Inti:
// 1. Critical Group Identification: Memprioritaskan grup sampel yang paling cepat membuka batch trainer berikutnya.
// 2. Trajectory-Aware Radix Cache: Menahan entri KV Cache dari lintasan prioritas tinggi agar tidak tereviction saat eksekusi tool.
// 3. Dynamic Admission Threshold: Mencegah memory stranding sandbox dengan admission berbasis footprint fisik nyata.
// 4. Intra-Group Page Sharing: Meng-alias page table entry (PTE) write-protected antar-sandbox dalam grup template yang sama.

export interface SampleTrajectory {
  id: string;
  groupId: string;
  promptId: string;
  currentTurn: number;
  tokensGenerated: number;
  predictedRemainingTokens: number;
  state: 'ROLLOUT_PENDING' | 'ROLLOUT_RUNNING' | 'TOOL_WAITING' | 'COMPLETED';
  lastActiveTimestamp: number;
}

export interface SampleGroup {
  groupId: string;
  promptId: string;
  groupSize: number; // K sampel per prompt (e.g. K=8 untuk GRPO)
  completedCount: number;
  trajectories: SampleTrajectory[];
}

export class VenusPriorityScheduler {
  private activeGroups: Map = new Map();
  private batchSizeThreshold: number; // Jumlah grup selesai yang dibutuhkan untuk 1 trainer micro-batch

  constructor(batchSizeThreshold: number = 16) {
    this.batchSizeThreshold = batchSizeThreshold;
  }

  /**
   * Mengestimasi sisa waktu penyelesaian grup berdasarkan sampel terlambat (straggler)
   * T_remain(g) = max_{r in g} (predicted_remaining_tokens / generation_speed + tool_latency)
   */
  public calculateGroupEstimatedRemainingTime(group: SampleGroup): number {
    let maxRemaining = 0;
    for (const traj of group.trajectories) {
      if (traj.state !== 'COMPLETED') {
        const estTime = traj.predictedRemainingTokens * 0.02 + 0.5; // heuristik latensi
        if (estTime > maxRemaining) {
          maxRemaining = estTime;
        }
      }
    }
    return maxRemaining;
  }

  /**
   * Menyeleksi critical groups untuk meminimalisir waktu rilis batch trainer (T_next)
   */
  public selectCriticalGroups(limit: number): Set {
    const sortedGroups = Array.from(this.activeGroups.values())
      .filter((g) => g.completedCount < g.groupSize)
      .sort((a, b) => {
        // Prioritaskan grup yang hampir selesai (completion ratio tertinggi dan sisa waktu terpendek)
        const aProgress = a.completedCount / a.groupSize;
        const bProgress = b.completedCount / b.groupSize;
        if (bProgress !== aProgress) return bProgress - aProgress;
        return this.calculateGroupEstimatedRemainingTime(a) - this.calculateGroupEstimatedRemainingTime(b);
      });

    const criticalSet = new Set();
    for (let i = 0; i  = new Map();

  constructor(totalMemoryGb: number = 400) {
    this.totalPhysicalMemoryBytes = totalMemoryGb * 1024 * 1024 * 1024;
    this.admissionThresholdBytes = this.totalPhysicalMemoryBytes * 0.85; // 85% safety bound
  }

  /**
   * Algoritma 1: Dynamic Admission Threshold Adaptation
   * Memeriksa apakah kandidat sandbox dapat diterima berdasarkan prediksi pertumbuhan memori aktif
   */
  public admitSandbox(estimatedFootprintBytes: number): boolean {
    if (this.currentUsedMemoryBytes + estimatedFootprintBytes > this.admissionThresholdBytes) {
      return false; // Tolak / migrasi untuk menghindari risiko OOM
    }
    this.currentUsedMemoryBytes += estimatedFootprintBytes;
    return true;
  }

  /**
   * Mekanisme Intra-Group Page Sharing:
   * Mengaitkan virtual page address ke shared physical frame dengan flag Write-Protected
   */
  public mapSharedPage(templateKey: string, pageOffset: number): { physicalFrameId: number; isCow: boolean } {
    const key = `${templateKey}:${pageOffset}`;
    let entry = this.pageSharingPool.get(key);
    if (!entry) {
      entry = { physicalFrameId: Math.floor(Math.random() * 1000000), refCount: 1 };
      this.pageSharingPool.set(key, entry);
    } else {
      entry.refCount++;
    }
    return { physicalFrameId: entry.physicalFrameId, isCow: true };
  }
}
7. Implikasi Arsitektural bagi Rekayasa AI Skala Industri 2026
Riset VenusRL membuktikan bahwa peralihan dari model fondasi teks pasif menuju agen otonom interaktif menuntut perombakan total pada arsitektur sistem komputasi terdistribusi:
- Penjadwalan Sadar Konvergensi (Convergence-Aware Scheduling): Mengoptimalkan sistem komputasi tidak lagi cukup hanya dengan memantau saturasi FLOPs GPU. Bidang kendali harus memahami dependensi struktural algoritma RL (seperti group barrier GRPO) agar setiap watt daya komputasi langsung berkontribusi pada penurunan waktu iterasi pelatihan.
- Sinergi Co-Design OS dan AI Runtime: Isolasi lingkungan eksekusi agen tidak boleh diperlakukan sebagai kotak hitam terisolasi. Melalui kolaborasi antara runtime inferensi (SGLang) dan primitif kernel OS (Copy-on-Write, virtual memory aliasing), pemborosan memori dapat dieliminasi hingga level minimal.
- Demokratisasi Pelatihan Model Coding Skala Besar: Dengan memangkas 89% biaya lingkungan dan mempercepat throughput 4x lipat, kluster komputasi yang sebelumnya hanya mampu melatih model kecil kini memiliki kapasitas untuk mengeksekusi long-horizon reinforcement learning pada repository kode dunia nyata berskala enterprise.
Referensi & Sumber Terverifikasi
- [1]VenusRL: A Fully Disaggregated Agentic RL System with Priority Scheduling and Scalable Interaction(arXiv:2610.03286v1 [cs.DC, cs.AI] — Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang (Tsinghua University, RISys Lab, ByteDance, BUPT))
- [2]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Specification)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, et al.)
- [3]SGLang: Efficient Execution of Structured Language Model Programs with RadixAttention(arXiv:2312.07104 — Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Jeff Huang, Chuyue Sun, et al.)
- [4]Firecracker: Lightweight Virtualization for Serverless Applications(ACM NSDI 2020 — Alexandru Agache, Marc Brooker, Andreea Florescu, Alexandra Iordache, et al. (Amazon Web Services))
- [5]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 — Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, Karthik Narasimhan)
- [6]VenusRL: A Fully Disaggregated Agentic RL System with Priority Scheduling and Scalable Interaction(arXiv:2610.03286v1 [cs.DC, cs.AI] — Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang (Tsinghua University, RISys Lab, ByteDance, BUPT))
- [7]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Specification)(arXiv:2402.03300 — Zhihong Shao, Peiyi Wang, Qihao Zhu, Runxin Xu, Junxiao Song, et al.)
- [8]SGLang: Efficient Execution of Structured Language Model Programs with RadixAttention(arXiv:2312.07104 — Lianmin Zheng, Liangsheng Yin, Zhiqiang Xie, Jeff Huang, Chuyue Sun, et al.)
- [9]Firecracker: Lightweight Virtualization for Serverless Applications(ACM NSDI 2020 — Alexandru Agache, Marc Brooker, Andreea Florescu, Alexandra Iordache, et al. (Amazon Web Services))
- [10]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 — Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, Karthik Narasimhan)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.
AutoCompact 2026: Arsitektur Proactive Context Compaction pada Long-Horizon Coding Agents, Eliminasi Context Bloat Tanpa Menunggu Window Overflow, dan Terobosan SFT + Outcome-Based RL
Analisis arsitektur sistemik riset frontier software engineering autonomous agents (arXiv:2610.02163, Xuan Zhang, Longtao Zheng, Cunxiao Du, Bo An, Xin Dong — SMU, NTU, Harvard): Mengapa strategi pemadatan konteks tradisional (length-triggered compaction) gagal total pada trajectory panjang repository-level karena baru merangkum setelah mencapai batas context window (16K/32K/128K). Memperkenalkan AutoCompact, framework yang mengintegrasikan aksi proactive compact() ke dalam policy model itu sendiri. Melalui 3 pilar penentu (When to compact, What to keep, How to continue), pengumpulan data on-policy berbasis online judge correction (Trigger 24%, Working-state 53%, Continuation 23%), serta joint training SFT dilanjutkan Outcome-Based RL (GRPO dengan binary task success), AutoCompact mendongkrak pass rate SWE-bench Verified sebesar +9.2% dan SWE-PolyBench Verified sebesar +5.0%, membuktikan bahwa konteks panjang 256K sekalipun membutuhkan pembersihan proaktif dari akumulasi hipotesis usang dan noise eksplorasi.