AutoCompact 2026: Arsitektur Proactive Context Compaction pada Long-Horizon Coding Agents, Eliminasi Context Bloat Tanpa Menunggu Window Overflow, dan Terobosan SFT + Outcome-Based RL
Analisis arsitektur sistemik riset frontier software engineering autonomous agents (arXiv:2610.02163, Xuan Zhang, Longtao Zheng, Cunxiao Du, Bo An, Xin Dong — SMU, NTU, Harvard): Mengapa strategi pemadatan konteks tradisional (length-triggered compaction) gagal total pada trajectory panjang repository-level karena baru merangkum setelah mencapai batas context window (16K/32K/128K). Memperkenalkan AutoCompact, framework yang mengintegrasikan aksi proactive compact() ke dalam policy model itu sendiri. Melalui 3 pilar penentu (When to compact, What to keep, How to continue), pengumpulan data on-policy berbasis online judge correction (Trigger 24%, Working-state 53%, Continuation 23%), serta joint training SFT dilanjutkan Outcome-Based RL (GRPO dengan binary task success), AutoCompact mendongkrak pass rate SWE-bench Verified sebesar +9.2% dan SWE-PolyBench Verified sebesar +5.0%, membuktikan bahwa konteks panjang 256K sekalipun membutuhkan pembersihan proaktif dari akumulasi hipotesis usang dan noise eksplorasi.
AutoCompact: Arsitektur Proactive Context Compaction pada Long-Horizon Coding Agents Tanpa Menunggu Jendela Konteks Penuh
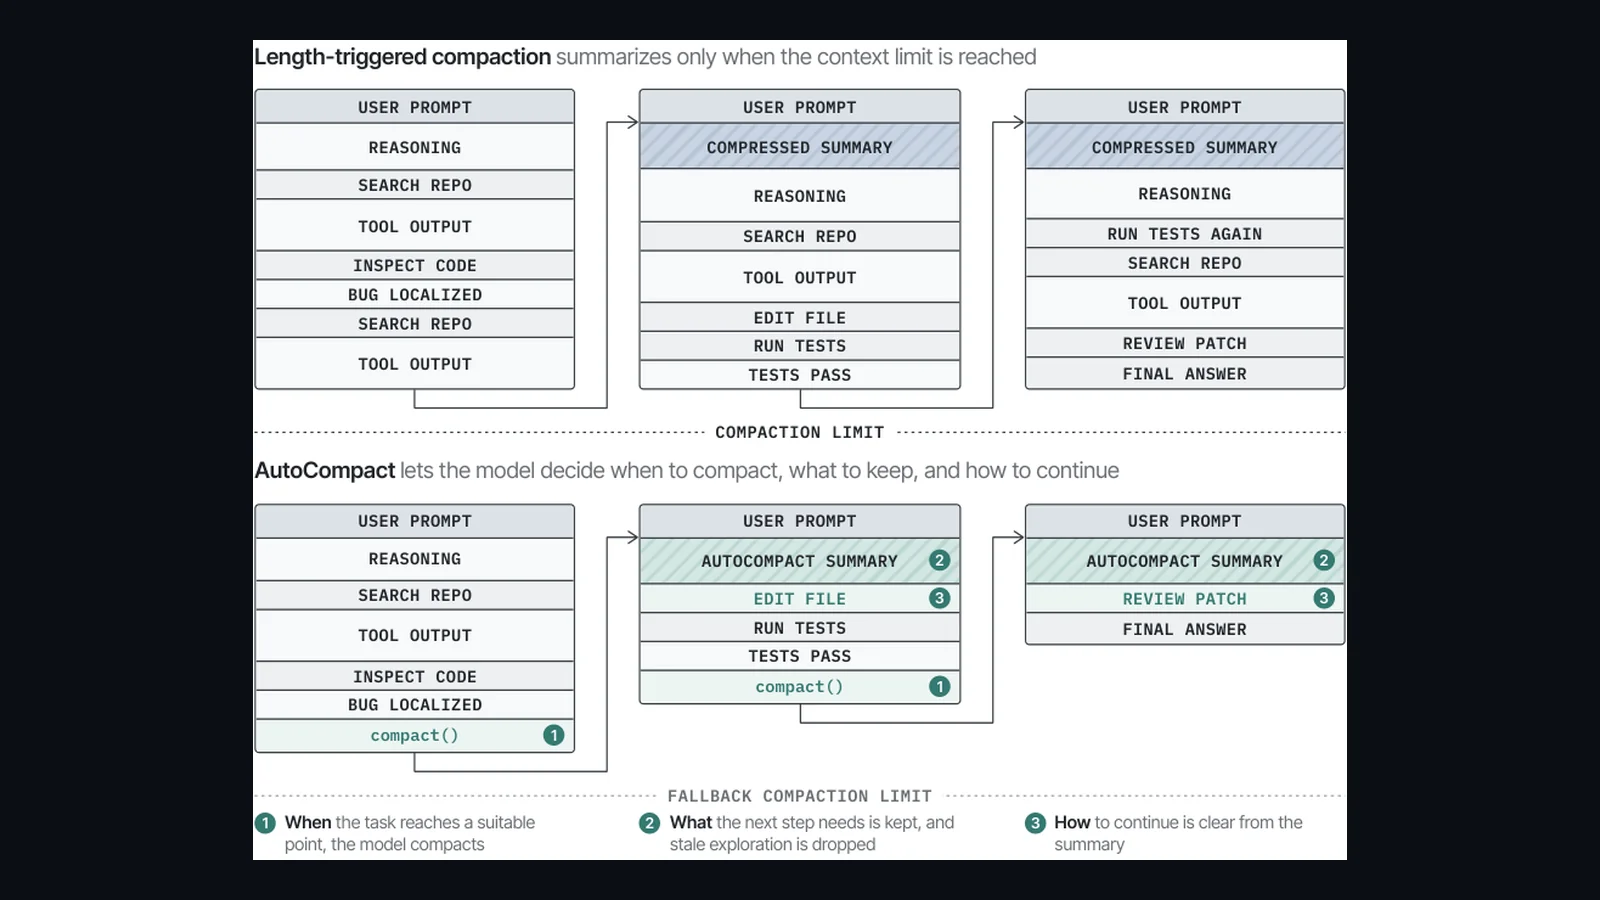
Pada eksekusi rekayasa perangkat lunak berskala repositori (SWE-bench), agen otonom menghadapi ribuan baris output alat, inspeksi kode berulang, dan jejak investigasi yang membengkak. Selama ini, seluruh sistem produksi—mulai dari Claude Code hingga scaffold agen berbasis Codex—mengandalkan strategi length-triggered compaction: merangkum konteks hanya saat jendela konteks (context window) hampir penuh atau melewati ambang batas keras.
Sebuah riset frontier dari Singapore Management University, Nanyang Technological University, dan Harvard University (arXiv:2610.02163) mengungkap kelemahan fatal pendekatan pasif tersebut: saat ambang batas tercapai, akumulasi hipotesis usang dan noise eksplorasi telah mengaburkan fokus penalaran model.
Melalui AutoCompact, agen dilatih untuk memiliki aksi mandiri compact() secara proaktif sebagai bagian dari kebijakannya (policy). Dilatih melalui data on-policy dengan supervisi judge online corrections pada 3 keputusan kritis (When to compact, What to keep, How to continue) dan dioptimalkan secara gabungan menggunakan Outcome-Based Reinforcement Learning (GRPO), AutoCompact mencetak peningkatan absolut +9.2% pada SWE-bench Verified dan +5.0% pada SWE-PolyBench Verified. Bahkan pada jendela masif 256K yang tidak pernah meluap, pembersihan proaktif terbukti mengungguli model yang mempertahankan riwayat penuh.
1. Paradoks Jendela Konteks Panjang: Mengapa Menjaga Semua Riwayat Justru Merugikan Agen?
Dengan ketersediaan model fondasi modern yang mendukung context window hingga 128K, 256K, bahkan 1M token, muncul asumsi umum dalam industri bahwa masalah konteks pada coding agents telah terpecahkan: biarkan saja seluruh eksekusi tersimpan tanpa kompresi. Namun, temuan empiris Zhang et al. (2026) membuktikan sebaliknya.
Dalam tugas rekayasa tingkat repositori, seorang agen koding harus melakukan triase bug, menjelajahi pohon direktori, menjalankan grep/find, membaca berkas definisi, menguji hipotesis penyebab, mengedit kode, dan menjalankan uji coba regresi (test suite). Seiring berjalannya tugas:
- Akumulasi Hipotesis Usang (Stale Hypotheses): Upaya perbaikan awal yang gagal dan berkas eksplorasi yang tidak relevan tetap berada dalam prompt, memicu model untuk berulang kali menguji ulang jalur buntu yang sama.
- Attention Dilution & Noise: Log terminal dan traceback ratusan baris menyita kapasitas komputasi self-attention, menyebabkan representasi kode target yang krusial terpinggirkan (lost in the middle).
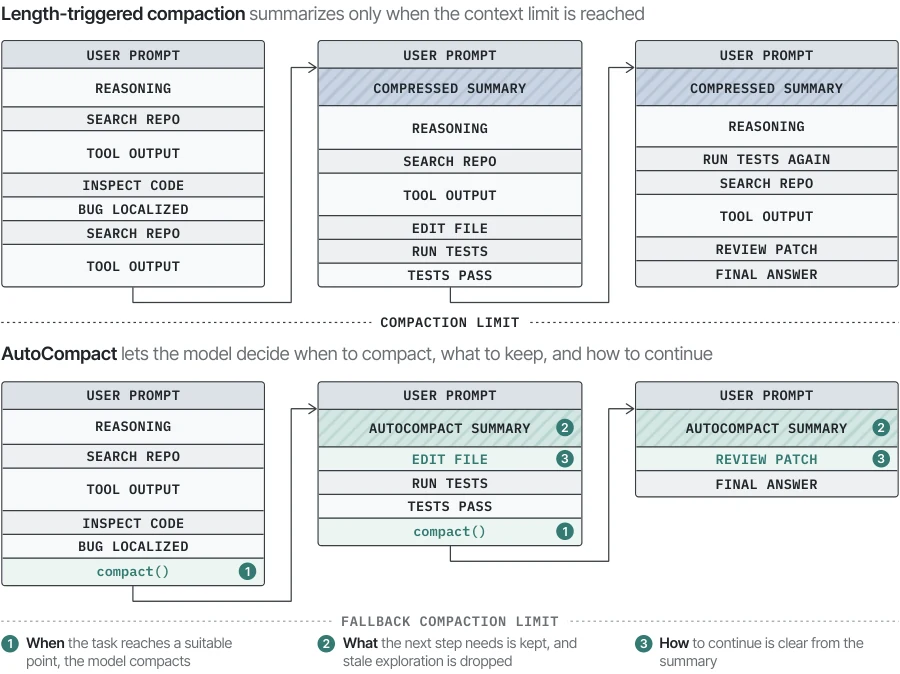
- Siklus Rangkuman Pasif yang Terlambat: Pemadatan berbasis panjang hanya bertindak sebagai "pemadam kebakaran" ketika buffer memori habis, bukan sebagai strategi penyusunan progres modular.
2. Tiga Pilar Keputusan Proactive Context Compaction
AutoCompact melengkapi agen dengan aksi compact() yang dapat dipanggil kapan saja sebelum batasan jendela memaksanya. Keputusan pemadatan dipecah menjadi tiga pilar deterministik:
Model belajar mengidentifikasi titik transisi fase alami dalam siklus koding—misalnya tepat setelah lokasi bug teridentifikasi (localization done) dan sebelum berkas dimodifikasi, atau tepat setelah edit selesai sebelum pengujian.
Menghasilkan # Auto Context Summary terstruktur yang merangkum kesimpulan esensial, berkas target, state workspace aktif, dan hipotesis terbuka, sembari membuang trace pencarian dan log usang.
Memastikan aksi langsung setelah ringkasan mengeksekusi langkah implementasi berikutnya yang telah dirancang, bukan kembali ke pencarian berulang atau menduplikasi investigasi awal.
3. Pipeline Dua Tahap: Online Judge-Guided SFT dan Outcome-Based RL
Meminta model dasar untuk memanggil compact() secara proaktif adalah perilaku yang sangat jarang muncul secara spontan. Kebanyakan model terlatih untuk terus merespons sampai dipaksa berhenti. Oleh karena itu, arsitektur pelatihan AutoCompact dirancang dalam dua fase yang sinergis:
Fase 1: Online Corrective Data Collection & Supervised Fine-Tuning (SFT)
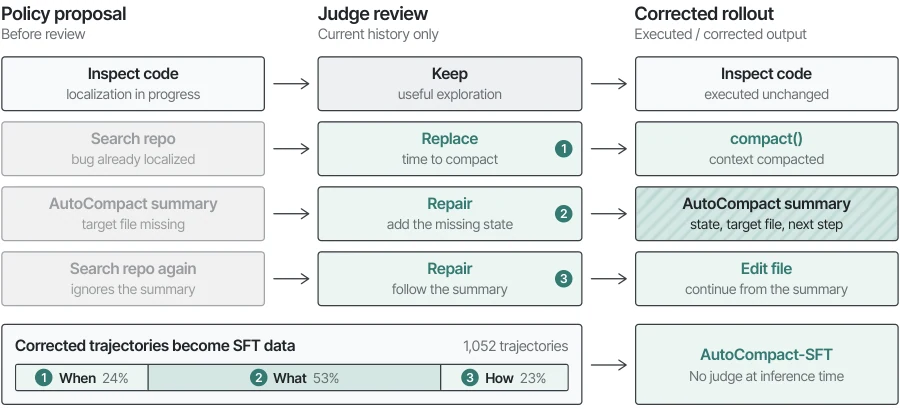
Model dasar (Qwen3-Coder-30B-A3B-Instruct) di-rollout pada 379 tugas SWE-rebench. Saat model mengajukan aksi, sebuah judge tingkat frontier (GPT-5.5-Codex) meninjau proposal tersebut:
- Trigger Correction (24%): Jika bug sudah terlokalisasi namun model masih ingin melakukan
search_repo, judge mengganti proposal dengancompact(). - Working-state Correction (53%): Jika ringkasan konteks melupakan berkas target atau variabel penting, judge menyisipkan state yang hilang.
- Continuation Correction (23%): Jika setelah ringkasan model malah mencari lagi hal yang sudah dicatat, judge mengarahkan aksi ke langkah modifikasi kode (
edit_file).
Kritikal: Koreksi ini diterapkan sebelum eksekusi lingkungan, berbeda dengan anotasi post-hoc yang tidak mengubah jalannya simulasi. Sebanyak 1.052 trajektori terkoreksi berhasil dihimpun untuk melatih AutoCompact-SFT.
Fase 2: Joint Reinforcement Learning (GRPO) Tanpa Reward Shaping Khusus
Dari checkpoint SFT, model dilatih lebih lanjut pada SWE-Gym menggunakan Group Relative Policy Optimization (GRPO). Yang sangat menarik dari desain arsitektural ini adalah ketiadaan auxiliary loss atau reward shaping buatan untuk pemadatan. Satu-satunya reward adalah binary task success (1 jika seluruh pengujian lolos, 0 jika gagal).
Tantangan teknisnya: setiap pemanggilan compact() menulis ulang konteks (context prefix is rewritten), memutus sifat kausalitas autoregresif murni. Peneliti mengatasi ini dengan Trajectory Segment Splitting: membagi trajektori menjadi segmen-segmen di setiap titik penulisan ulang prefix. Semua segmen dalam satu trajektori berbagi relative advantage yang sama dari GRPO, sehingga keputusan memadat, teks ringkasan, dan aksi lanjutan menerima sinyal pembelajaran yang utuh.
4. Evaluasi Empiris: Dominasi pada SWE-bench Verified & SWE-PolyBench
Evaluasi komprehensif dilakukan pada dua tolak ukur rekayasa perangkat lunak standar industri: SWE-bench Verified (500 tugas Python) dan SWE-PolyBench Verified (multi-bahasa):
| Arsitektur & Metode | Trigger Mekanisme | Optimasi | Context Window | SWE-bench Verified (%) | SWE-PolyBench Verified (%) |
|---|---|---|---|---|---|
| Base Full-History | — | — | 256K | 30.4% | 19.5% |
| Fixed Compaction | Length-triggered | — | 16K (threshold) | 28.8% | 18.6% |
| CompactionRL (Li et al., 2026) | Length-triggered | RL | 16K (threshold) | 32.7% | 19.8% |
| SelfCompact (Li et al., 2026) | Rubric-prompted | — | 256K | 31.7% | 20.6% |
| SWE-Compressor (Liu et al., 2026) | Learned SFT | Offline SFT | 256K | 31.0% | 20.1% |
| AutoCompact-SFT | Learned Proactive | Online Judge SFT | 256K | 32.2% | 21.7% |
| AutoCompact (Full Model) | Learned Proactive | SFT → Outcome RL | 256K | 39.6% (+9.2%) | 24.5% (+5.0%) |
Data di atas menunjukkan lompatan masif: AutoCompact menembus 39.6% pada SWE-bench Verified, melampaui seluruh baseline yang mempertahankan riwayat penuh maupun kompresi panjang konvensional.
5. Dimensi Self-Consistency: Mengapa SFT Saja Tidak Cukup?
Salah satu temuan paling mencerahkan dari studi ini terletak pada summary self-consistency. Pada model SFT biasa, ringkasan sering kali menderita inkonsistensi logis: model mencatat bahwa masih terdapat SyntaxError, namun pada baris berikutnya justru menyarankan langkah "Finish; submit patch". Akibatnya agen gagal total saat evaluasi.
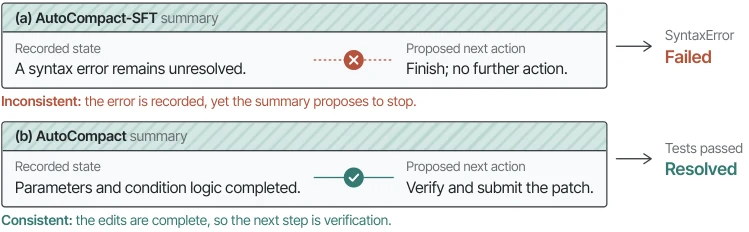
Setelah Outcome-Based RL diterapkan, tingkat penghilangan state penting (missing key state) turun drastis dari 3.1% menjadi 0.2%, dan kelalaian aksi lanjutan (missing next action) anjlok dari 8.2% ke 2.2%. RL mendisiplinkan model bahwa sebuah ringkasan hanya bernilai jika tindakan setelahnya berhasil menyelesaikan masalah di lingkungan nyata.
6. Implementasi Produksi: Arsitektur AutoCompact Controller
Berikut adalah modul TypeScript enterprise-ready yang mengimplementasikan arsitektur kontroler kontekstual AutoCompact dengan segment splitting dan gate validasi kelanjutan rencana:
// Production Implementation: AutoCompact REPL Policy & Proactive Context Controller
// Berdasarkan Arsitektur SMU, NTU & Harvard (arXiv:2610.02163 - Oktober 2026)
//
// Karakteristik Inti:
// 1. Proactive compact() Action: Model dapat memicu pemadatan sebelum batas konteks terlampaui.
// 2. 3-Phase Decision Gate: (1) When to compact, (2) What to keep, (3) How to continue.
// 3. Segmented Context Management: Memecah rekaman eksekusi menjadi segmen linier saat prefix ditulis ulang.
// 4. Fallback Forced Compaction: Penanganan graceful jika batas threshold jendela tercapai.

export interface AgentAction {
  type: 'bash' | 'inspect' | 'edit' | 'test' | 'compact' | 'submit';
  payload: string;
  metadata?: Record;
}

export interface WorkingStateSummary {
  phase: 'localization' | 'implementation' | 'verification';
  targetFiles: string[];
  resolvedHypotheses: string[];
  activeEdits: string[];
  unresolvedErrors: string[];
  plannedNextAction: string;
}

export interface TrajectorySegment {
  segmentId: string;
  initialPrefixTokens: number;
  steps: Array<{
    turn: number;
    action: AgentAction;
    observation: string;
    tokenCount: number;
  }>;
  advantageReward?: number; // Shared across all segments in the trajectory under GRPO
}

export class AutoCompactController {
  private currentContextTokens: number = 0;
  private readonly maxContextTokens: number;
  private readonly forcedCompactionThreshold: number;
  private segments: TrajectorySegment[] = [];
  private currentSegment: TrajectorySegment;
  private activeWorkingState: WorkingStateSummary | null = null;

  constructor(maxContextTokens: number = 262144, forcedCompactionThreshold: number = 16384) {
    this.maxContextTokens = maxContextTokens;
    this.forcedCompactionThreshold = forcedCompactionThreshold;
    this.currentSegment = {
      segmentId: `seg-${Date.now()}-0`,
      initialPrefixTokens: 0,
      steps: [],
    };
    this.segments.push(this.currentSegment);
  }

  /**
   * Menilai apakah agen perlu melakukan pemadatan konteks proaktif berdasarkan progres task
   */
  public evaluateProactiveTrigger(
    currentMilestoneReached: boolean,
    hasUnusedExplorationHistory: boolean
  ): boolean {
    // AutoCompact mempelajari kebijakan: jika milestone tercapai (misal: bug terisolasi)
    // dan riwayat eksplorasi mulai menumpuk, lakukan compact() tanpa menunggu window overflow
    if (currentMilestoneReached && hasUnusedExplorationHistory) {
      return true;
    }
    // Fallback length-triggered safety threshold
    if (this.currentContextTokens >= this.forcedCompactionThreshold) {
      return true;
    }
    return false;
  }

  /**
   * Menjalankan aksi compact(): Merangkum state aktif, membersihkan riwayat usang,
   * dan memulai segmen baru dengan prefix yang diperbarui
   */
  public executeCompaction(summary: WorkingStateSummary): string {
    this.activeWorkingState = summary;

    // Format # Auto Context Summary yang bersih dan deterministik
    const formattedSummary = [
      '# Auto Context Summary',
      `## Current Phase: ${summary.phase.toUpperCase()}`,
      `## Target Files: ${summary.targetFiles.join(', ')}`,
      `## Verified State: ${summary.activeEdits.join('; ') || 'None'}`,
      `## Remaining Issues: ${summary.unresolvedErrors.join('; ') || 'None'}`,
      `## Explicit Next Step: ${summary.plannedNextAction}`,
    ].join('\n');

    // Buat segmen baru karena prefix konteks ditulis ulang (context rewritten)
    // Sesuai Section 2.3: Segment splitting memungkinkan token model dilatih dengan GRPO
    const nextSegmentId = `seg-${Date.now()}-${this.segments.length}`;
    const newPrefixTokens = Math.ceil(formattedSummary.length / 4); // Estimasi token

    this.currentSegment = {
      segmentId: nextSegmentId,
      initialPrefixTokens: newPrefixTokens,
      steps: [],
    };
    this.segments.push(this.currentSegment);
    this.currentContextTokens = newPrefixTokens;

    return formattedSummary;
  }

  /**
   * Verifikasi self-consistency: Memastikan aksi berikutnya sejalan dengan plannedNextAction
   */
  public validateContinuation(nextAction: AgentAction): { isConsistent: boolean; reason: string } {
    if (!this.activeWorkingState) {
      return { isConsistent: true, reason: 'No active compacted summary.' };
    }

    // Mendeteksi anomali jika summary mencatat error belum selesai namun agen mencoba submit
    if (this.activeWorkingState.unresolvedErrors.length > 0 && nextAction.type === 'submit') {
      return {
        isConsistent: false,
        reason: 'Inkonsistensi: Masih terdapat error yang belum terselesaikan, namun agen mencoba submit patch.',
      };
    }

    return { isConsistent: true, reason: 'Aksi lanjutan konsisten dengan rencana summary.' };
  }
}
7. Implikasi Strategis untuk Masa Depan Autonomous Software Engineering
Riset AutoCompact membawa pelajaran arsitektural fundamental bagi para perancang sistem AI agen di era modern:
- Model-Harness Co-Design Adalah Kunci: Memisahkan kompresi memori menjadi modul eksternal yang terisolasi terbukti inferior dibanding menyediakan tool
compact()langsung ke dalam action space model dan melatihnya secara end-to-end. - Context Window Besar Bukan Pengganti Higienitas Penalaran: Menjejalkan 256.000 token riwayat mentah justru merusak atensi model pada hal-hal kritis. Pemadatan proaktif bertindak sebagai "refaktorisasi mental" yang mengembalikan fokus agen ke kondisi kerja terkini.
- Supervisi Tindakan Pasca-Ringkasan: Kunci keberhasilan bukan sekadar merangkum masa lalu, melainkan memastikan bahwa trajektori tindakan yang mengikuti ringkasan tersebut secara taat asas mengeksekusi rencana kerja yang baru.
Referensi & Sumber Terverifikasi
- [1]AutoCompact: Learning When to Compact Context in Long-Horizon Coding Agents(arXiv:2610.02163v1 [cs.CL, cs.AI, cs.SE] — Xuan Zhang, Longtao Zheng, Cunxiao Du, Bo An, Xin Dong (Singapore Management University, Nanyang Technological University, Harvard University))
- [2]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(International Conference on Learning Representations (ICLR) — Carlos E. Jimenez et al.)
- [3]SWE-Gym: Training Autonomous Software Engineering Agents with Environment Feedback(arXiv:2412.21139 — Jiayi Pan, Xingyao Wang et al.)
- [4]SWE-rebench: An Automated Pipeline for Task Collection and Decontaminated Evaluation(Advances in Neural Information Processing Systems (NeurIPS) — Badertdinov et al.)
- [5]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO)(arXiv:2402.03300 — Daya Guo, Qihao Zhu, et al.)
- [6]AutoCompact: Learning When to Compact Context in Long-Horizon Coding Agents(arXiv:2610.02163v1 [cs.CL, cs.AI, cs.SE] — Xuan Zhang, Longtao Zheng, Cunxiao Du, Bo An, Xin Dong (Singapore Management University, Nanyang Technological University, Harvard University))
- [7]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(International Conference on Learning Representations (ICLR) — Carlos E. Jimenez et al.)
- [8]SWE-Gym: Training Autonomous Software Engineering Agents with Environment Feedback(arXiv:2412.21139 — Jiayi Pan, Xingyao Wang et al.)
- [9]SWE-rebench: An Automated Pipeline for Task Collection and Decontaminated Evaluation(Advances in Neural Information Processing Systems (NeurIPS) — Badertdinov et al.)
- [10]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO)(arXiv:2402.03300 — Daya Guo, Qihao Zhu, et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.