ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.

ActKV: Terobosan Kompresi KV Cache Berbasis Aksi Pertama untuk Sistem Serving LLM Agents Otonom
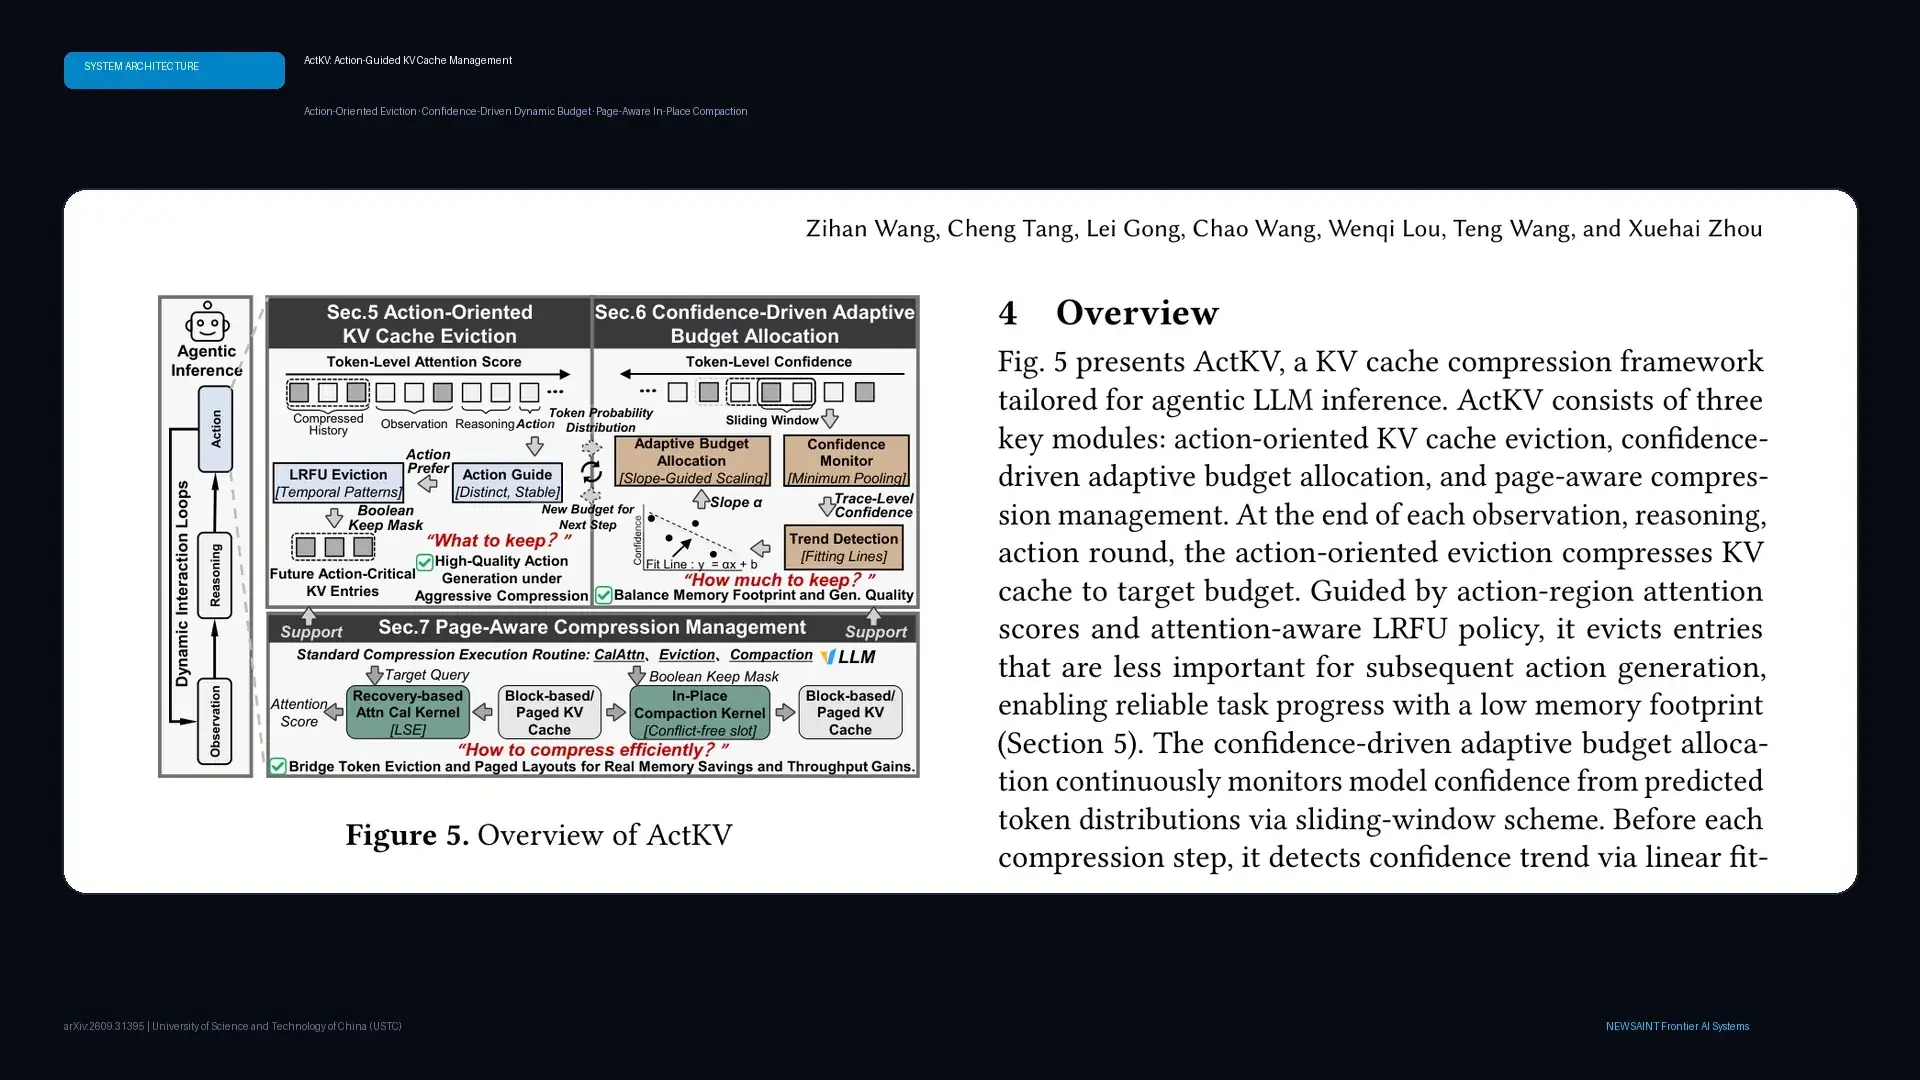
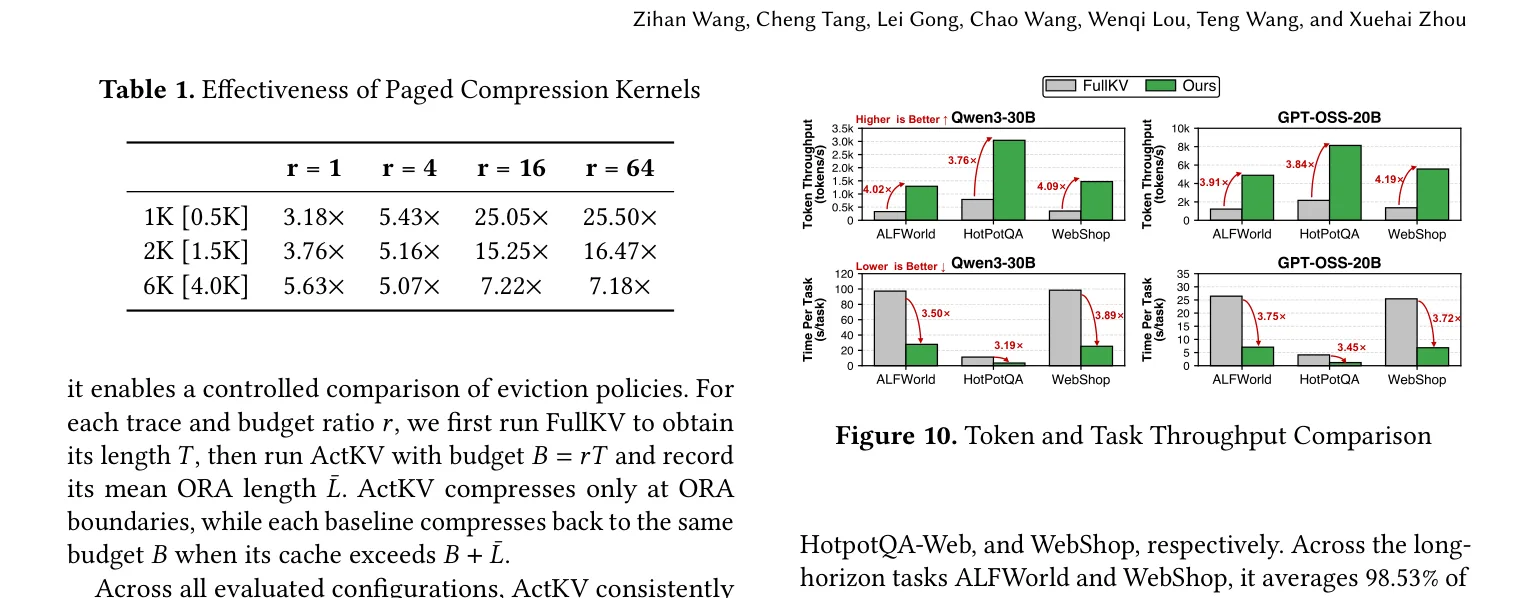
Dalam siklus inferensi agen otonom kontemporer (ReAct: Observation-Reasoning-Action) seperti OpenClaw, Claude Code, dan Codex, memori KV cache membengkak secara eksponensial seiring bertambahnya giliran investigasi. Di server produksi, lebih dari 99% token KV cache disita oleh teks observasi lingkungan dan rantai penalaran internal (scratchpad reasoning). Semua teknik kompresi KV cache konvensional—seperti StreamingLLM, SnapKV, dan R-KV—mengalami degradasi performa yang fatal saat diuji pada agen, karena metode-metode tersebut memperlakukan semua token secara setara (uniform token treatment) dan hanya mengukur bobot atensi masa depan terdekat (near-future reasoning). Akibatnya, entri KV yang krusial bagi eksekusi aksi di masa depan justru terbuang. Sebuah terobosan arsitektural dari University of Science and Technology of China (USTC) & Suzhou Institute for Advanced Research (arXiv:2609.31395) memperkenalkan ActKV: kerangka kerja kompresi KV cache pertama yang secara radikal memprioritaskan kualitas token aksi. Melalui tiga inovasi inti—Action-Oriented LRFU Eviction, Confidence-Driven Adaptive Budget, dan Page-Aware In-Place Compaction Kernel—ActKV berhasil mempertahankan 98.53% akurasi FullKV hanya dengan 25.98% memori puncak KV cache, sembari melejitkan token throughput sebesar 3.97x dan task throughput sebesar 3.58x.
1. Paradoks Asimetri Token: Mengapa Kompresi Teks Konvensional Gagal Total pada Agen Otonom?
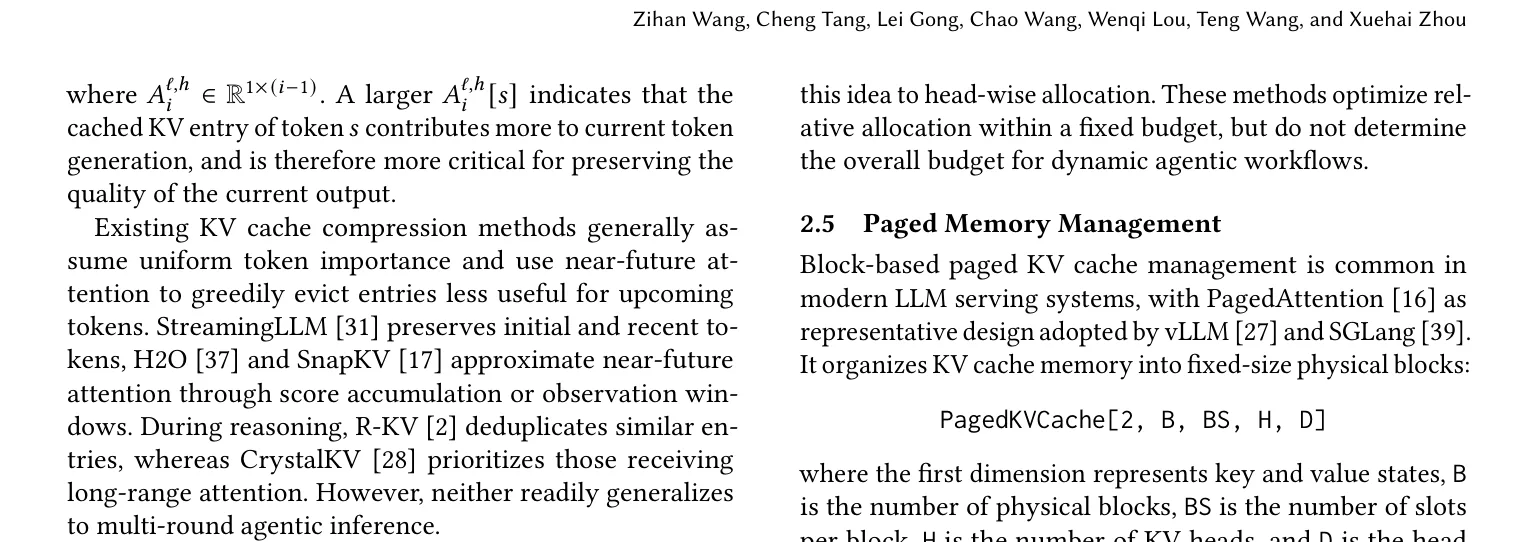
Pada tugas inferensi teks standar (seperti perangkuman dokumen atau percakapan obrolan), setiap token yang dihasilkan berkontribusi langsung pada kelengkapan kalimat yang dibaca manusia. Karena itu, algoritma kompresi KV cache klasik (seperti H2O, SnapKV, Scissorhands, dan StreamingLLM) berfokus pada pelestarian kualitas generasi token secara seragam. Mereka membuang entri KV yang memiliki bobot atensi rendah pada jendela beberapa token berikutnya.
Namun, pada sistem agen otonom, dinamika inferensi memiliki karakteristik struktural yang berbanding terbalik:
- Asimetri Fungsional (>99% vs <1%): Token observasi (output alat, berkas log, respons HTTP) dan token reasoning (monolog internal model) menyumbang lebih dari 99% volume memori, namun hanya berfungsi sebagai pemrosesan state sementara. Sebaliknya, token aksi (Action tokens)—seperti payload pemanggilan fungsi JSON, klik peramban, atau perintah terminal—menyumbang kurang dari 1% volume, tetapi merekalah satu-satunya entitas yang berinteraksi dengan lingkungan luar dan menentukan keberhasilan tugas.
- Kebutaan Jangka Pendek (Short-Sighted Eviction): Ketika algoritma kompresi konvensional mengevaluasi token selama fase reasoning, token tersebut cenderung memiliki atensi yang menyebar (diffuse) ke seluruh observasi masa lalu. Saat algoritma membuang KV cache yang dianggap tidak terpakai oleh penalaran jangka pendek, entri-entri yang sangat dibutuhkan untuk membentuk argumen aksi di giliran berikutnya ikut terhapus.
- Bencana Halusinasi & Loop Aksi: Ketika entri parameter aksi hilang dari KV cache, agen mulai mengulangi panggilan alat yang sama tanpa henti, memanggil fungsi dengan argumen salah, atau mengalami kegagalan sintaksis JSON secara berulang.
2. Tiga Pilar Arsitektur Sistem ActKV
Untuk menjembatani jurang pemisah antara efisiensi memori hardware GPU dan integritas fungsional aksi agen, tim peneliti merancang ActKV di atas tiga komponen sistem yang saling melengkapi:
Menggunakan kebijakan Attention-Aware Least Recently Frequently Used (LRFU). Setiap entri dievaluasi berdasarkan skor atensi regio aksi dengan faktor peluruhan eksponensial (λ = 0.95) dan masker hit top-90%, melindungi entri intermiten berkontribusi tinggi dari penggusuran prematur.
Memantau kepercayaan intrinsik model (log-probabilitas token teratas) melalui sliding window minimum pooling dan regresi linier. Jika tren kemiringan slope α < 0 (tanda model mengalami degradasi memori saat backtracking), budget KV otomatis diekspansi secara dinamis sebelum kompresi.
Menghilangkan alokasi memori buffer perantara melalui kernel Conflict-Free Slot Planning. Entri yang dipertahankan disalin langsung secara in-place ke blok-blok ekor (tail blocks), membebaskan halaman memori fisik ke pool vLLM/SGLang secara instan.
3. Formula Matematis: Mengapa LRFU Mengalahkan Pendekatan Statis?
Investigasi empiris peneliti terhadap trajektori eksekusi pada benchmark WebShop dan ALFWorld mengungkap bahwa entri KV yang diakses oleh token aksi terbagi menjadi tiga kategori:
- Cold-start Entries (1-5%): Entri baru yang baru pertama kali muncul pada putaran aktif.
- Continuous Entries (~60%): Entri yang diakses secara konstan pada setiap aksi (seperti instruksi sistem umum dan format skema JSON).
- Intermittent Entries (30-40%): Entri yang hanya diakses sesekali (misalnya batasan spesifik user seperti "gluten-free" atau ID elemen halaman), namun menyumbang lebih dari 48-52% total akumulasi bobot atensi ketika aksi membutuhkannya.
Jika sistem hanya menggunakan metrik recency murni (λ = 0), entri intermiten yang sedang tidak diakses pada 1 putaran akan langsung dibuang, melumpuhkan keputusan aksi pada putaran berikutnya. Sebaliknya, jika menggunakan frequency murni (λ = 1), entri continuous yang sudah tidak relevan akan menyandera budget memori selamanya. Oleh karena itu, ActKV merumuskan pembaruan skor penyimpanan (Keep Score / $KS$) sebagai:
Dengan λ ∈ [0, 1] dan masker hit $Top ext{-}P = 90%$, entri intermiten bernilai tinggi terlindungi dari keusangan sementara, sementara entri usang akan mengalami degradasi skor eksponensial hingga terdepak secara alamiah.
4. Evaluasi Empiris: Performa Spektakuler pada 4 Model Frontier
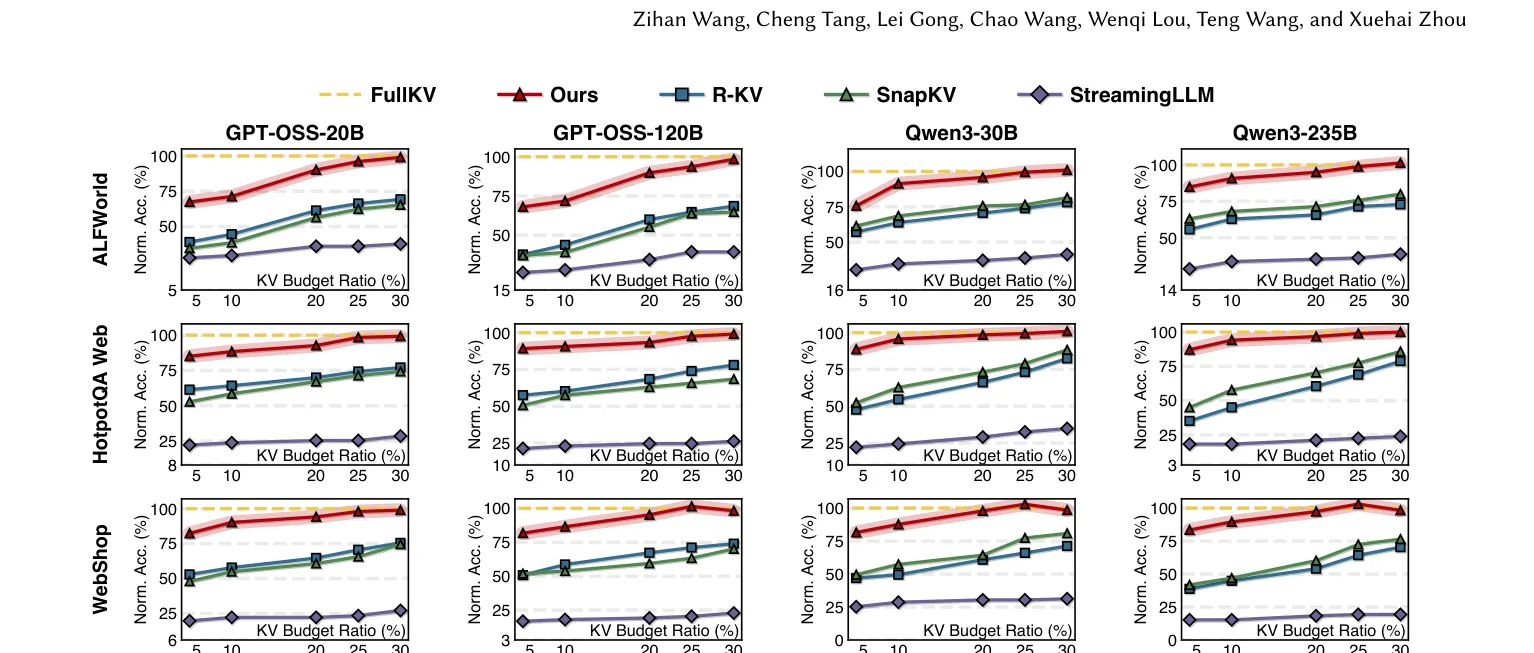
ActKV diuji secara komprehensif pada empat model bahasa dengan kapabilitas penalaran dan agen frontier: Qwen3-30B-A3B-Thinking-2507-BF16, Qwen3-235B-A22B-Thinking-2507-FP8, GPT-OSS-20B-BF16, dan GPT-OSS-120B-BF16 pada 3 tolak ukur standar: HotpotQA-Web (penalaran multi-hop dengan Wikipedia), WebShop (interaksi web e-commerce multi-atribut), dan ALFWorld (perencanaan aksi rumah tangga berwujud/embodied).
| Arsitektur & Metode | Alokasi Budget KV | Peak Memory Retained | Normalised Accuracy (%) | Token Throughput Speedup | Task Throughput Speedup |
|---|---|---|---|---|---|
| FullKV (Uncompressed Baseline) | 100% | 100.0% | 100.0% | 1.00x | 1.00x |
| StreamingLLM (Xiao et al., 2023) | Static Sink + Rolling | 33.6% | 31.2% - 58.4% | 1.82x | 1.45x |
| SnapKV (Li et al., 2024) | Static Observation Prefill | 33.6% | 42.5% - 69.1% | 2.14x | 1.88x |
| R-KV (2024) | Static Retrieval Window | 33.6% | 54.0% - 74.2% | 2.41x | 2.05x |
| ActKV (USTC, September 2026) | Adaptive Action-Guided | 25.98% (-74.02%) | 98.53% (Parity Penuh) | 3.97x | 3.58x |
5. Implementasi Arsitektur Sistem: ActKV Controller & In-Place Compaction
Berikut adalah implementasi referensi controller TypeScript untuk mengintegrasikan logika Action-Oriented Eviction, Confidence Budget Tracking, dan Conflict-Free Slot Planning ke dalam runtime serving agen modern:
// Production Implementation: ActKV Action-Oriented Cache & Dynamic Budget Controller
// Berdasarkan Arsitektur Sistem Operasi USTC (arXiv:2609.31395 - September 2026)
//
// Karakteristik Inti:
// 1. Action-Oriented LRFU Eviction: Menilai entri KV berdasarkan preferensi query token Action.
// 2. Intermittent Attention Protection: Decay factor lambda dan top-p hit mask mempertahankan entri berkontribusi tinggi.
// 3. Confidence-Driven Adaptive Budget: Memantau rata-rata log-probabilitas token teratas dan mendeteksi slope alpha < 0.
// 4. Page-Aware Conflict-Free In-Place Compaction: Menyatukan slot yang dipertahankan ke tail block dalam satu lintasan.

export interface KVCacheSlot {
  pageId: number;
  offset: number;
  logicalIndex: number;
}

export interface KeepScoreEntry {
  slotIndex: number;
  score: number;
  lastHitRound: number;
}

export class ActKVEvictionManager {
  private lambdaDecay: number;
  private topPThreshold: number;
  private keepScores: Map = new Map();

  constructor(lambdaDecay: number = 0.95, topPThreshold: number = 0.90) {
    this.lambdaDecay = lambdaDecay;
    this.topPThreshold = topPThreshold;
  }

  /**
   * Langkah 1 & 4: Memperbarui Keep Score setelah setiap putaran Observation-Reason-Action (ORA)
   * Berdasarkan attention score yang dihasilkan query regio Aksi (Q_act) terhadap Key (K)
   */
  public updateKeepScores(
    actionAttnScores: Float32Array, // Skor atensi regio Action terhadap semua KV entries
    totalEntries: number
  ): void {
    // 1. Urutkan skor atensi untuk menentukan ambang batas top-p (default 90%)
    const indexedScores: Array<{ idx: number; score: number }> = [];
    let sumScore = 0.0;
    for (let i = 0; i < actionAttnScores.length; i++) {
      indexedScores.push({ idx: i, score: actionAttnScores[i] });
      sumScore += actionAttnScores[i];
    }
    indexedScores.sort((a, b) => b.score - a.score);

    const hitSet = new Set();
    let cumulative = 0.0;
    const targetSum = sumScore * this.topPThreshold;
    for (const item of indexedScores) {
      hitSet.add(item.idx);
      cumulative += item.score;
      if (cumulative >= targetSum) break;
    }

    // 2. Terapkan pembaruan LRFU: KS_t(i) = lambda * KS_{t-1}(i) + AttnScore * [hit at t]
    for (let i = 0; i < totalEntries; i++) {
      const prevScore = this.keepScores.get(i) || 0.0;
      const isHit = hitSet.has(i);
      const incomingAttn = isHit && i < actionAttnScores.length ? actionAttnScores[i] : 0.0;

      const newScore = this.lambdaDecay * prevScore + incomingAttn;
      this.keepScores.set(i, newScore);
    }
  }

  /**
   * Langkah 5: Pilih Top-K entri KV yang akan dipertahankan sesuai kuota budget B
   */
  public selectRetainedEntries(budget: number): Set {
    const sorted = Array.from(this.keepScores.entries()).sort((a, b) => b[1] - a[1]);
    const retained = new Set();
    const count = Math.min(budget, sorted.length);
    for (let i = 0; i < count; i++) {
      retained.add(sorted[i][0]);
    }
    return retained;
  }
}

export class ConfidenceBudgetMonitor {
  private tokenConfidences: number[] = [];
  private windowSize: number;
  private stride: number;
  private bottomBPercentile: number;
  private scaleUpFactor: number;
  private maxBudget: number;

  constructor(
    windowSize: number = 32,
    stride: number = 8,
    bottomBPercentile: number = 0.20,
    scaleUpFactor: number = 1.25,
    maxBudget: number = 65536
  ) {
    this.windowSize = windowSize;
    this.stride = stride;
    this.bottomBPercentile = bottomBPercentile;
    this.scaleUpFactor = scaleUpFactor;
    this.maxBudget = maxBudget;
  }

  /**
   * Mengumpulkan token-level confidence dari negatif rata-rata log probabilitas top-k token
   */
  public recordTokenLogProbs(topKLogProbs: number[]): void {
    const avgLogProb = topKLogProbs.reduce((acc, val) => acc + val, 0) / topKLogProbs.length;
    // Negatif rata-rata log probabilitas (semakin tinggi semakin peaked/percaya diri)
    const conf = -avgLogProb;
    this.tokenConfidences.push(conf);
  }

  /**
   * Menghitung slope alpha dari trace-level confidence sequence menggunakan first-order linear regression
   */
  public evaluateBudgetAdjustment(currentBudget: number): number {
    if (this.tokenConfidences.length < this.windowSize) {
      return currentBudget;
    }

    // 1. Sliding window dengan minimum pooling
    const intermediateConf: number[] = [];
    for (let i = 0; i <= this.tokenConfidences.length - this.windowSize; i += this.stride) {
      let minVal = Infinity;
      for (let j = i; j < i + this.windowSize; j++) {
        if (this.tokenConfidences[j] < minVal) minVal = this.tokenConfidences[j];
      }
      intermediateConf.push(minVal);
    }

    if (intermediateConf.length === 0) return currentBudget;

    // 2. Ambil nilai-nilai di bawah persentil ke-b (menangkap fase pemulihan/keraguan model)
    const sorted = [...intermediateConf].sort((a, b) => a - b);
    const cutoffIndex = Math.max(1, Math.floor(sorted.length * this.bottomBPercentile));
    const thresholdVal = sorted[cutoffIndex - 1];
    const traceConf = intermediateConf.filter((v) => v <= thresholdVal);

    if (traceConf.length < 2) return currentBudget;

    // 3. Regresi linier sederhana untuk mencari slope (alpha)
    const n = traceConf.length;
    let sumX = 0, sumY = 0, sumXY = 0, sumXX = 0;
    for (let x = 0; x < n; x++) {
      const y = traceConf[x];
      sumX += x;
      sumY += y;
      sumXY += x * y;
      sumXX += x * x;
    }
    const slopeAlpha = (n * sumXY - sumX * sumY) / (n * sumXX - sumX * sumX);

    // 4. Jika alpha < 0 (tren kepercayaan menurun), lakukan ekspansi budget KV
    if (slopeAlpha < 0) {
      const newBudget = Math.min(Math.round(currentBudget * this.scaleUpFactor), this.maxBudget);
      return newBudget;
    }

    return currentBudget;
  }
}

export class PageAwareInPlaceCompactor {
  private blockSize: number;

  constructor(blockSize: number = 16) {
    this.blockSize = blockSize;
  }

  /**
   * Merencanakan pergerakan slot bebas konflik (conflict-free slot planning)
   * Mengonsolidasikan entri yang dipertahankan ke tail block dalam satu lintas komputasi
   */
  public planCompactionSlots(
    totalLogicalBlocks: number,
    budgetEntries: number,
    keepMask: boolean[]
  ): Array<{ srcLogical: number; dstLogical: number }> {
    const targetBlocks = Math.ceil(budgetEntries / this.blockSize);
    const startTailSlot = (totalLogicalBlocks - targetBlocks) * this.blockSize;
    const endTailSlot = startTailSlot + budgetEntries;

    const copyPlan: Array<{ srcLogical: number; dstLogical: number }> = [];
    const dstVacantSlots: number[] = [];

    // Cari slot yang dievakuasi di dalam zona tail (calon tujuan copy)
    for (let slot = startTailSlot; slot < endTailSlot; slot++) {
      if (slot < keepMask.length && !keepMask[slot]) {
        dstVacantSlots.push(slot);
      }
    }

    // Cari slot yang harus dipertahankan yang berada di luar zona tail (sumber copy)
    let vacantIndex = 0;
    for (let slot = 0; slot < startTailSlot; slot++) {
      if (keepMask[slot] && vacantIndex < dstVacantSlots.length) {
        copyPlan.push({
          srcLogical: slot,
          dstLogical: dstVacantSlots[vacantIndex++],
        });
      }
    }

    return copyPlan;
  }
}
6. Implikasi Rekayasa bagi Masa Depan Sistem Multi-Agent Skala Besar
Keberhasilan ActKV menandai pergeseran paradigma fundamental dalam desain inferensi AI frontier:
- Runtuhnya Mitos Context Window Raksasa: Memperluas context window hingga 1M token tidak menyelesaikan masalah ekonomi serving. Menjaga riwayat penuh observasi usang tidak hanya menghabiskan puluhan gigabyte VRAM per pengguna, namun juga mengencerkan atensi model terhadap parameter tugas.
- Infrastruktur Serving Sadar Agen (Agent-Aware Serving): Arsitektur inference engine (vLLM, SGLang, TensorRT-LLM) tidak lagi dapat menganggap agen otonom sekadar sebagai sesi chatting biasa. Integrasi primitif spesifik agen—yang mengenali fase aksi dan merekonstruksi skor atensi dari log-sum-exp (LSE)—menjadi syarat mutlak bagi deployment skala industri berbiaya rendah.
- Akselerasi Sistem Multi-Agent: Dalam arsitektur orkestrasi di mana puluhan sub-agen bekerja secara paralel (seperti pada benchmark SWE-bench atau pencarian intelijen otonom), efisiensi throughput 3.97x memungkinkan cluster GPU melayani 4 kali lipat jumlah agen dengan footprint perangkat keras yang persis sama.
Referensi & Sumber Terverifikasi
- [1]ActKV: Efficient LLM Agents through Action-Guided KV Cache Management(arXiv:2609.31395v1 [cs.OS, cs.AI] — Zihan Wang, Cheng Tang, Lei Gong, Chao Wang, Wenqi Lou, Teng Wang, Xuehai Zhou (University of Science and Technology of China & Suzhou Institute for Advanced Research, USTC))
- [2]Efficient Streaming Language Models with Attention Sinks (StreamingLLM)(International Conference on Learning Representations (ICLR) — Guangxuan Xiao, Yuandong Tian, Beidi Chen, Song Han, Mike Lewis)
- [3]SnapKV: LLM Knows What You are Looking for Before Generation(arXiv:2404.14469 — Yuhong Li, Yingbing Huang, Bowen You, Zhiding Yu, Sifei Liu, et al.)
- [4]ReAct: Synergizing Reasoning and Acting in Language Models(International Conference on Learning Representations (ICLR) — Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao)
- [5]vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention(ACM SOSP 2023 — Woosuk Kwon, Zhuohan Li, Siyuan Shen, Yanping Huang, Yida Wang, et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.
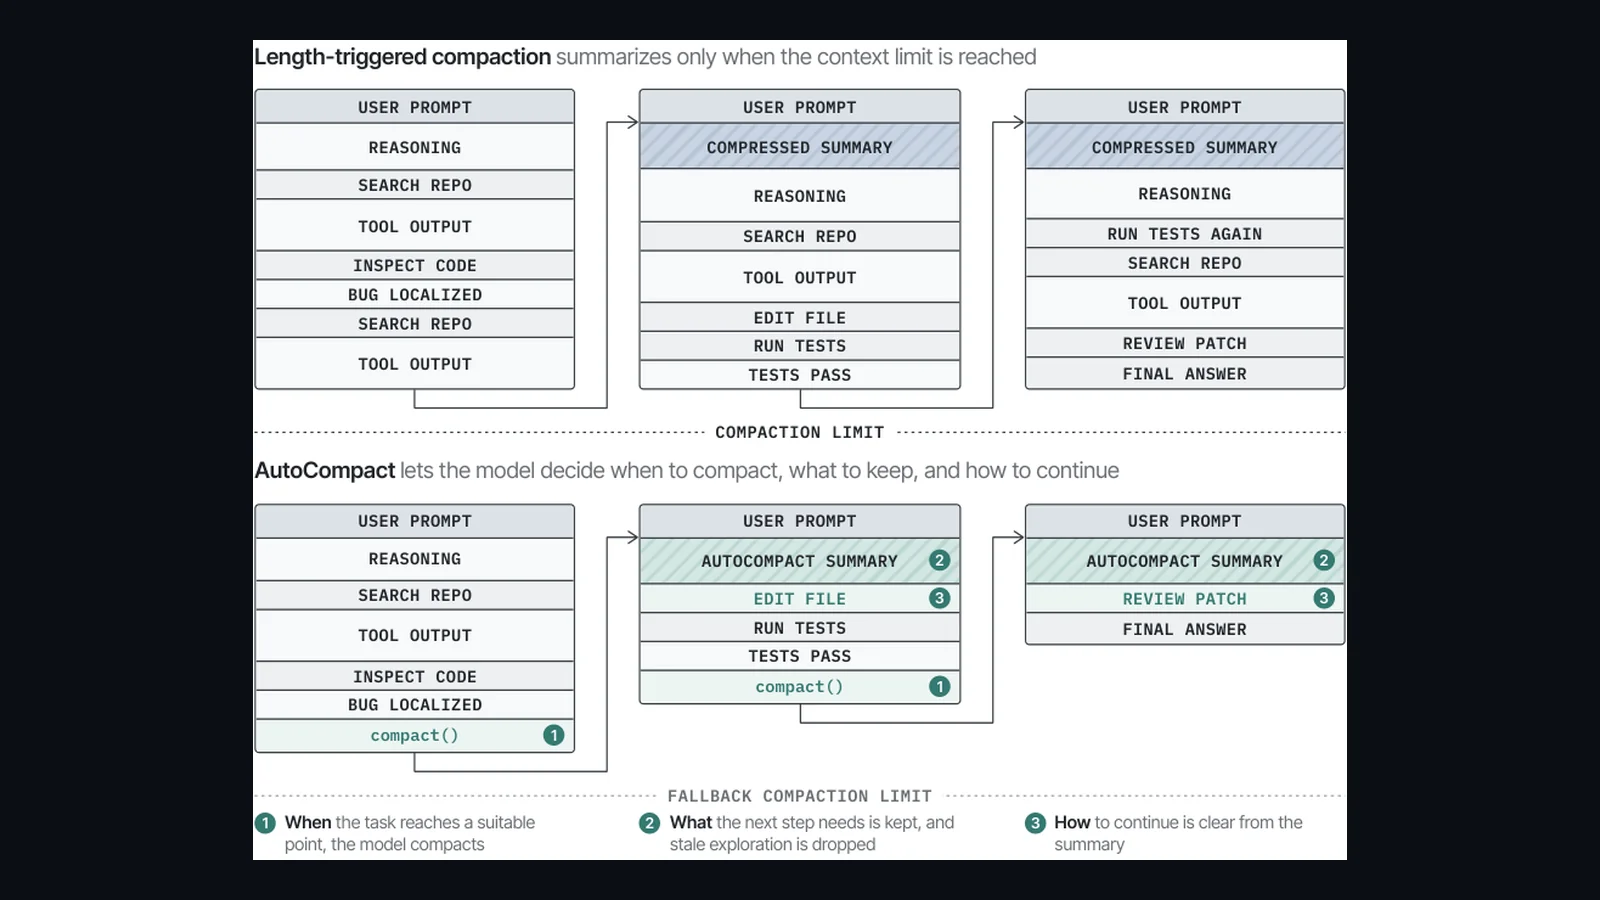
AutoCompact 2026: Arsitektur Proactive Context Compaction pada Long-Horizon Coding Agents, Eliminasi Context Bloat Tanpa Menunggu Window Overflow, dan Terobosan SFT + Outcome-Based RL
Analisis arsitektur sistemik riset frontier software engineering autonomous agents (arXiv:2610.02163, Xuan Zhang, Longtao Zheng, Cunxiao Du, Bo An, Xin Dong — SMU, NTU, Harvard): Mengapa strategi pemadatan konteks tradisional (length-triggered compaction) gagal total pada trajectory panjang repository-level karena baru merangkum setelah mencapai batas context window (16K/32K/128K). Memperkenalkan AutoCompact, framework yang mengintegrasikan aksi proactive compact() ke dalam policy model itu sendiri. Melalui 3 pilar penentu (When to compact, What to keep, How to continue), pengumpulan data on-policy berbasis online judge correction (Trigger 24%, Working-state 53%, Continuation 23%), serta joint training SFT dilanjutkan Outcome-Based RL (GRPO dengan binary task success), AutoCompact mendongkrak pass rate SWE-bench Verified sebesar +9.2% dan SWE-PolyBench Verified sebesar +5.0%, membuktikan bahwa konteks panjang 256K sekalipun membutuhkan pembersihan proaktif dari akumulasi hipotesis usang dan noise eksplorasi.