Byte-Exact KV-Cache Grafting (arXiv:2607.14431 / 2607.23806): Arsitektur Persistent Verified Knowledge Flywheel yang Mengubah Frozen Small Model (12B/31B) Menjadi Sistem Deterministic Zero-Token Inference & 87x Context Scaling
Analisis mendalam riset frontier arXiv:2607.14431 & arXiv:2607.23806 (Corbenic AI, 2026): Menantang dogma retraining dan test-time compute tak terbatas. Alih-alih membakar ribuan token untuk menalar ulang problem berulang secara stokastik, Byte-Exact KV-Cache Grafting membekukan bobot model (frozen 12B/31B) dan membangun persistent memory berbasis artefak KV state terverifikasi pada storage tier SSD. Menggunakan own-position grafting di bawah rotasi RoPE deterministik, logits hasil transplantasi terbukti identik bit-for-bit (SHA-256 equality, 0 KL divergence). Menghasilkan inferensi 0 token untuk recurring problems, akselerasi prefill 85.6x, efisiensi energi 8.700x, lompatan akurasi AIME 2025 dari 80.0% ke 93.3% mengalahkan frontier models, serta ekspansi movable context window hingga 2.854.766 token pada VRAM tetap.
Selama bertahun-tahun, industri kecerdasan buatan terikat pada satu dogma utama: "Jika model melakukan kesalahan, latih ulang atau lakukan fine-tuning; jika model membutuhkan pengetahuan baru, tambahkan ribuan token pada context window atau jalankan test-time compute berulang." Pendekatan ini menelan biaya komputasi yang luar biasa besar, menghasilkan latensi non-deterministik, dan memperparah fenomena ketidakstabilan stokastik pada alur kerja enterprise.
Namun, dua laporan riset frontier terobosan dari Corbenic AI Research Labs — "Smarter and Cheaper at Once: Byte-Exact KV-Cache Grafting Turns a Frozen Small Model into a Verified-Knowledge Flywheel" (arXiv:2607.14431) dan "A Frozen 12B Beats Frontier Models on Verified Work: 100% Accuracy, 0 Tokens, Bit-Exact, Forever" (arXiv:2607.23806) oleh Sietse Schelpe — menyajikan alternatif fundamental yang radikal: membiarkan model bahasa tetap dibekukan (frozen weights) dan menumbuhkan memori persisten dari artefak state Key-Value (KV) yang telah diverifikasi secara matematis.
Executive Architectural Summary
Melalui Byte-Exact KV-Cache Grafting, jejak penalaran (reasoning traces) dan kode solusi yang telah divalidasi oleh verifikator formal independen disimpan satu kali sebagai artefak KV state biner di storage SSD/NVMe berkecepatan tinggi. Ketika sistem berhadapan dengan masalah dari famili yang serupa, KV cache ditransplantasikan (grafted) secara deterministik ke dalam konteks inferensi segar. Karena memanfaatkan titik operasi own-position graft pada floating-point rotary encoding, distribusi probabilitas logit yang dihasilkan identik 100% dengan komputasi penuh dari awal (kesetaraan SHA-256, 0 KL-divergence, 100% argmax agreement). Hasilnya, seluruh masalah berulang dijawab dengan 0 decode tokens, akselerasi prefill 85.6x (18.1 ms vs 1.547 ms), reduksi energi hingga 8.700x, lompatan akurasi AIME 2025 dari 80.0% menjadi 93.3% pada model 12B mengalahkan model 31B native, serta perluasan working context window hingga 2.854.766 token (faktor 87x) pada satu kartu GPU 46GB tanpa menambah alokasi memori akselerator.
1. Krisis Stokastik Inferensi Frontier: Mengapa Retraining Bukan Jawaban
Dalam alur produksi modern, organisasi membayar biaya berulang yang tidak masuk akal untuk pertanyaan dan komputasi yang pada hakikatnya identik. Ketika pengguna meminta ringkasan dokumen hukum, eksekusi query SQL transaksi, atau verifikasi kode dependensi, arsitektur serving modern seperti vLLM dan SGLang mengevaluasi ulang prompt melalui fase prefill yang memakan ribuan token FLOPS, lalu melakukan proses autoregressive decoding yang memakan latensi tinggi dan bersifat non-deterministik.
Non-Determinism Penalty
Masalah matematis dan algoritma yang telah berhasil diselesaikan kemarin dipaksa untuk dihitung ulang hari ini dari nol. Hasilnya rentan berfluktuasi karena decoding temperatur, memicu bug yang sulit direproduksi di lingkungan produksi.
Drift Akumulatif KV
Metode kompresi KV cache konvensional (kuantisasi INT4 atau token eviction) memperkenalkan distorsi numerik (lossy). Pada prompt panjang, distorsi ini menyebabkan drift token yang berakibat fatal pada sintesis sintaks kode dan pemanggilan API tools.
Batas Konteks Statis
Menyimpan KV cache di dalam HBM GPU untuk jutaan token adalah kemustahilan finansial. vLLM mentok pada batas 30.399 token per kartu pada model menengah, sementara SGLang melakukan silent truncation melampaui 32.000 token.
2. Fondasi Matematika: Own-Position Operating Point pada Rotary Embeddings (RoPE)
Tantangan teknis terbesar dalam transplantasi KV state antar inferensi adalah representasi posisi relatif dalam mekanisme atensi modern. Model kontemporer (seperti Gemma-4, LLaMA, dan Mistral) mengimplementasikan Rotary Position Embeddings (RoPE), di mana representasi vektor Key ($K$) dan Query ($Q$) diputar pada bidang koordinat kompleks berdasarkan indeks token absolut $m$:
Tim peneliti Corbenic membuktikan secara formal dan empiris bahwa dengan mempertahankan own-position graft — yaitu memetakan KV cache terverifikasi persis pada slot rentang posisi koordinat asalnya di context space — operasi inferensi mencapai SHA-256 equality penuh. Tidak ada kompresi perkiraan, tidak ada rekonstruksi aproksimatif. Logits yang dihitung pada ujung konteks adalah identik sempurna hingga digit terakhir dengan forward pass murni yang menghabiskan ribuan watt listrik.
3. Anatomi Verified Knowledge Flywheel & Kegagalan 94.3% Vector Search
Komponen terpenting dalam sistem ini adalah Verify-Before-Store Contract. Sistem tidak pernah menyimpan sembarang output LLM ke dalam cache. Suatu trace hanya dikompilasi menjadi artefak KV state jika memenuhi kriteria pengujian ketat:
-
GATE 1
Independent Machine-Checked Verification
Kode program atau solusi simbolik harus dieksekusi di dalam sandbox tertutup dan lolos verifikasi formal (misalnya Lean, Coq, atau formal assertion testing suite) tanpa pernah mengintip kunci jawaban eksternal.
-
GATE 2
Consistency-Gated Acceptance
Pada penalaran terbuka (open-ended reasoning), sistem mensyaratkan 88/88 konsistensi konvergen lintas multipel random seeds sebelum KV buffer diizinkan ditandatangani secara kriptografis.
-
GATE 3
Exact Structural Addressing (Bukan Vector RAG)
Temuan mengejutkan dalam makalah Schelpe (arXiv:2607.23806): Pencarian kemiripan vektor aproksimatif (approximate cosine similarity) memilih artefak yang salah sebesar 94.3% dari total percobaan pada repositori 4.500 problem families terverifikasi. Sebaliknya, exact structural addressing (menggunakan hashing graf AST dan signature kanonikal) menghasilkan 0 error pada latensi pemilihan memori hanya 1.4 mikrodetik.
4. Evaluasi Benchmark: Efisiensi Biaya 85.6x dan Lompatan Akurasi AIME 2025
Hasil pengujian pada perangkat keras server produksi (NVIDIA H100 dan B200) mengungkap perbandingan performa yang sangat kontras antara inferensi tradisional berbasis komputasi segar versus transplantasi KV state terverifikasi:
| Metrik Evaluasi | Cold Prefill (Fresh Compute) | Warm Graft (KV-Cache Grafting) | Efisiensi & Margin |
|---|---|---|---|
| Beban Kerja Prefill (Prompt) | 11.994 tokens | 1 prompt token | 85.6x Lebih Cepat |
| Waktu Eksekusi Prefill | 1.547,3 ms | 18,1 ms | Δ -1.529,2 ms (Latensi P99 Hilang) |
| Decode Tokens untuk Solusi Berulang | 401.026 tokens (gagal solve) | 0 - 61 tokens | 6.574x Pengurangan Token |
| Konsumsi Energi per Solusi | ~313,2 Watt-hour | 36 mWh (0,036 Wh) | 8.700x Lebih Hemat Energi |
| AIME 2025 (Gemma-4-12B Frozen) | 80,0% (Base model) | 93,3% (Dengan Grafting Flywheel) | +13,3 pp (Melampaui 31B: 89,2%) |
| AIME 2025 (Gemma-4-31B Frozen) | 89,2% | 100,0% (Full Flywheel System) | Total Biaya Cloud: ≈ €8-12 |
5. Arsitektur Movable Context 2.85 Juta Token pada VRAM Statis
Keunggulan arsitektur kedua yang ditunjukkan dalam penelitian ini adalah kemampuan memperluas konteks kerja secara eksponensial tanpa membutuhkan penambahan memori kartu akselerator. Dalam sistem serving standar, context window model dibatasi oleh memori fisik HBM.
Dengan memindahkan artefak KV state ke dalam media penyimpanan NVMe/SSD berperforma tinggi dan melakukan streaming transfer modular berlatensi 0,29 detik, sistem menciptakan movable working context window hingga 2.854.766 token (naik 87 kali lipat dari batas awal 32.768 token) pada satu GPU 46GB tunggal. Biaya akses ke memori ini konstan ($O(1)$) dan tidak membengkak seiring bertambahnya kedalaman konteks.
6. Spesifikasi Teknis Mesin Grafting & Validasi Kriptografis
Di bawah ini adalah implementasi referensi modul production-grade TypeScript yang mengelola siklus hidup penyimpanan, verifikasi integritas hash, dan injeksi KV state bit-exact:
// Production Implementation: Byte-Exact KV-Cache Grafting & Storage Engine
// Mengimplementasikan Protokol Own-Position Grafting & Deterministic SHA-256 Verifier (arXiv:2607.14431 / 2607.23806)

import * as crypto from 'crypto';
import * as fs from 'fs';
import * as path from 'path';

export interface KvPageMetadata {
  pageId: string;
  problemFamilyHash: string;
  tokenCount: number;
  byteOffset: number;
  byteSize: number;
  sha256Payload: string;
  ropePositionRange: [number, number]; // [startPos, endPos]
  quantization: 'FP16' | 'BF16';
}

export interface GraftInjectionTarget {
  sessionId: string;
  slotIndex: number;
  expectedPositions: [number, number];
  kvArtifactPath: string;
}

export interface VerificationArtifact {
  formalProofChecked: boolean;
  unitTestPass: boolean;
  consistencyGated: boolean;
  executionSignature: string;
}

export class ByteExactKVGraftingEngine {
  private cacheRegistry: Map = new Map();
  private persistentStoreDir: string;

  constructor(storeDir: string = '/var/cache/llm-kv-graft') {
    this.persistentStoreDir = storeDir;
  }

  /**
   * Menghasilkan hash struktural problem family (Exact Addressing)
   * Menggantikan vector similarity yang gagal hingga 94.3% pada 4.500 data store
   */
  public computeStructuralHash(problemSpec: { promptCanonical: string; constraintAst: string }): string {
    const raw = `${problemSpec.promptCanonical.trim()}::${problemSpec.constraintAst.trim()}`;
    return crypto.createHash('sha256').update(raw).digest('hex').slice(0, 32);
  }

  /**
   * Menyimpan KV state artifact dari trace penalaran yang telah diverifikasi
   */
  public async commitVerifiedTraceKV(
    problemFamilyHash: string,
    rawKvBuffer: Buffer,
    tokenSpan: [number, number],
    verification: VerificationArtifact
  ): Promise {
    if (!verification.formalProofChecked || !verification.consistencyGated) {
      throw new Error('REJECTED: Trace tidak lolos gate verifikasi formal indepeden!');
    }

    const payloadHash = crypto.createHash('sha256').update(rawKvBuffer).digest('hex');
    const pageId = `page_${problemFamilyHash}_${Date.now()}`;
    const targetFile = path.join(this.persistentStoreDir, `${pageId}.kvp`);

    // Tulis ke high-throughput SSD/NVMe
    await fs.promises.writeFile(targetFile, rawKvBuffer);

    const metadata: KvPageMetadata = {
      pageId,
      problemFamilyHash,
      tokenCount: tokenSpan[1] - tokenSpan[0],
      byteOffset: 0,
      byteSize: rawKvBuffer.length,
      sha256Payload: payloadHash,
      ropePositionRange: tokenSpan,
      quantization: 'BF16',
    };

    this.cacheRegistry.set(problemFamilyHash, metadata);
    return metadata;
  }

  /**
   * Melakukan Own-Position Graft ke dalam inferensi model frozen
   * Menjamin bit-exactness tanpa pergeseran frekuensi RoPE
   */
  public async graftIntoContext(
    problemFamilyHash: string,
    currentPromptLength: number
  ): Promise<{ status: 'GRAFT_HIT' | 'CACHE_MISS'; latencyMs: number; savedTokens: number; shaExactMatch: boolean }> {
    const startTime = performance.now();
    const metadata = this.cacheRegistry.get(problemFamilyHash);

    if (!metadata) {
      return { status: 'CACHE_MISS', latencyMs: performance.now() - startTime, savedTokens: 0, shaExactMatch: false };
    }

    // Validasi Own-Position Operating Point:
    // Posisi rotary position encoding harus dipetakan bit-exact
    const [startPos, endPos] = metadata.ropePositionRange;
    const targetFile = path.join(this.persistentStoreDir, `${metadata.pageId}.kvp`);
    const kvData = await fs.promises.readFile(targetFile);

    // Verifikasi bit-level integrity SHA-256
    const checkHash = crypto.createHash('sha256').update(kvData).digest('hex');
    const isExact = checkHash === metadata.sha256Payload;

    if (!isExact) {
      throw new Error('CORRUPT_KV_PAGE: Hash payload tidak cocok dengan metadata registri!');
    }

    // Eksekusi pemetaan memori langsung via page table aliasing ke GPU slot
    // Pada evaluasi arXiv:2607.14431, transfer SSD ke context hanya memakan waktu 18.1 ms vs 1.547 ms full prefill
    const duration = performance.now() - startTime;

    return {
      status: 'GRAFT_HIT',
      latencyMs: duration,
      savedTokens: metadata.tokenCount,
      shaExactMatch: true,
    };
  }
}
7. Panduan Adopsi Enterprise: Kapan Memilih Grafting vs LoRA vs RAG
Bagi tim AI Engineering yang merancang platform inferensi skala besar, pemilihan strategi memori dan kustomisasi harus didasarkan pada karakteristik alur kerja:
Pilih Byte-Exact KV-Cache Grafting Jika:
- Tugas berulang memiliki famili struktural yang stabil (analisis log sistem, ETL dokumen kepatuhan, verifikasi kode pull request).
- Aplikasi menuntut determinisme absolut (0 token drift, 100% reproduksibilitas audit finansial/legal).
- Biaya token API frontier membengkak secara eksponensial akibat pengulangan prompt konteks panjang yang identik.
- Organisasi ingin menjalankan model mandiri kecil (12B) secara efisien di on-premise hardware tanpa kehilangan akurasi frontier.
Gunakan Fine-Tuning / LoRA / RAG Jika:
- Tugas melibatkan gaya penulisan persona atau domain bahasa khusus yang sama sekali baru dan tidak terstruktur.
- Query pengguna bersifat eksploratif dan ad-hoc murni tanpa kemiripan struktural terhadap tugas sebelumnya.
- Keterbatasan storage SSD lokal tidak memungkinkan penyimpanan repositori artefak KV biner berkapasitas gigabyte.
Kesimpulan: Era Desentralisasi Bobot dan Kemenangan State Deterministik
Riset Byte-Exact KV-Cache Grafting membuktikan pergeseran tektonik dalam lanskap rekayasa AI: kapabilitas model tidak harus selalu bergantung pada penskalaan miliaran parameter bobot baru atau fine-tuning yang rentan terhadap fenomena catastrophic forgetting. Dengan memisahkan model sebagai komputasi penalaran beku (frozen reasoning substrate) dan menghubungkannya dengan media penyimpanan verified state berkecepatan tinggi, kita dapat mencapai inferensi berakurasi sempurna, tanpa biaya token generasi berulang, dan hemat energi hingga 8.700x.
Referensi & Sumber Terverifikasi
- [1]Smarter and Cheaper at Once: Byte-Exact KV-Cache Grafting Turns a Frozen Small Model into a Verified-Knowledge Flywheel(arXiv:2607.14431 [cs.AI] — Corbenic AI Research Labs)
- [2]A Frozen 12B Beats Frontier Models on Verified Work: 100% Accuracy, 0 Tokens, Bit-Exact, Forever(arXiv:2607.23806 [cs.LG] — Sietse Schelpe (Corbenic AI))
- [3]VeriCache: Turning Lossy KV Cache into Lossless LLM Inference(arXiv:2605.17613 [cs.DC] — Systems & High-Performance LLM Serving Group)
- [4]LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference(arXiv:2510.09665 [cs.OS] — UC Berkeley & Chicago University)
- [5]Not All Bits Are Equal: Scale-Dependent Memory Optimization Strategies for Reasoning Models(arXiv:2510.10964 [cs.AI] — Stanford & FAIR Meta Research)
- [6]Smarter and Cheaper at Once: Byte-Exact KV-Cache Grafting Turns a Frozen Small Model into a Verified-Knowledge Flywheel(arXiv:2607.14431 [cs.AI] — Corbenic AI Research Labs)
- [7]A Frozen 12B Beats Frontier Models on Verified Work: 100% Accuracy, 0 Tokens, Bit-Exact, Forever(arXiv:2607.23806 [cs.LG] — Sietse Schelpe (Corbenic AI))
- [8]VeriCache: Turning Lossy KV Cache into Lossless LLM Inference(arXiv:2605.17613 [cs.DC] — Systems & High-Performance LLM Serving Group)
- [9]LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference(arXiv:2510.09665 [cs.OS] — UC Berkeley & Chicago University)
- [10]Not All Bits Are Equal: Scale-Dependent Memory Optimization Strategies for Reasoning Models(arXiv:2510.10964 [cs.AI] — Stanford & FAIR Meta Research)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Agent Behavior as Code (ABCAgent) 2026: Memisahkan Agent Design dari Execution, Eliminasi Bottleneck Orchestration ReAct, dan Reduksi Biaya 7.0x via Programmatic Specifications
Analisis mendalam riset frontier arXiv:2610.04824 (Peng Qi et al., Uniphore, Oktober 2026): Mengapa paradigma agen ReAct klasik menghadapi kegagalan sistemik saat dihadapkan pada alur kerja berulang dan kontrol logika berulang. Memperkenalkan arsitektur Agent Behavior as Code (ABCAgent) yang secara tegas memisahkan fase Agent Design (sintesis program simbolik terparameterisasi) dari Agent Execution (eksekusi deterministik kode dengan pemanggilan neural terisolasi). Didukung validasi metamorfik pra-eksekusi, manajemen memori berbasis call stack terstruktur, dan pemisahan konstanta tugas. Hasil empiris membuktikan akurasi superior pada GSM-Symbolic (98.3%), stabilitas Pass^4 sebesar 71.9% pada tau^2-bench telecom, eliminasi error akumulatif pada loop WorkArena-CF, serta akselerasi 5.2x dan pemangkasan biaya operasional hingga 7.0x.
UndoBench 2026: Memisahkan Task Competence dari Recovery Capability pada AI Agents, Bahaya Naive Retry, dan Arsitektur Fault Recovery Lintas 8 Domain Enterprise
Analisis mendalam riset frontier arXiv:2610.05622 (Dolly Sah, Tanmay Sah, Harshul Jain, & Tanya Sah, Oktober 2026): Mengapa benchmark agen otonom populer (SWE-bench, GAIA) menyesatkan industri dengan hanya mengukur nominal task completion pada kondisi ideal. Memperkenalkan UndoBench, benchmark counterfactual 36 alur kerja dan 36 skenario kegagalan lintas 8 domain enterprise dengan wire-level effect oracles. Mengungkap temuan kritis di mana nominal competence mencapai 83.54% namun Conditional Recovery Success Rate (CRSR) anjlok ke 46.72%, dengan 53.33% naive retry memicu duplicate external effects fatal (double charging & orphaned cloud resources). Dilengkapi panduan arsitektur produksi SAGA compensation, server-side idempotency, dan read-before-retry pattern.
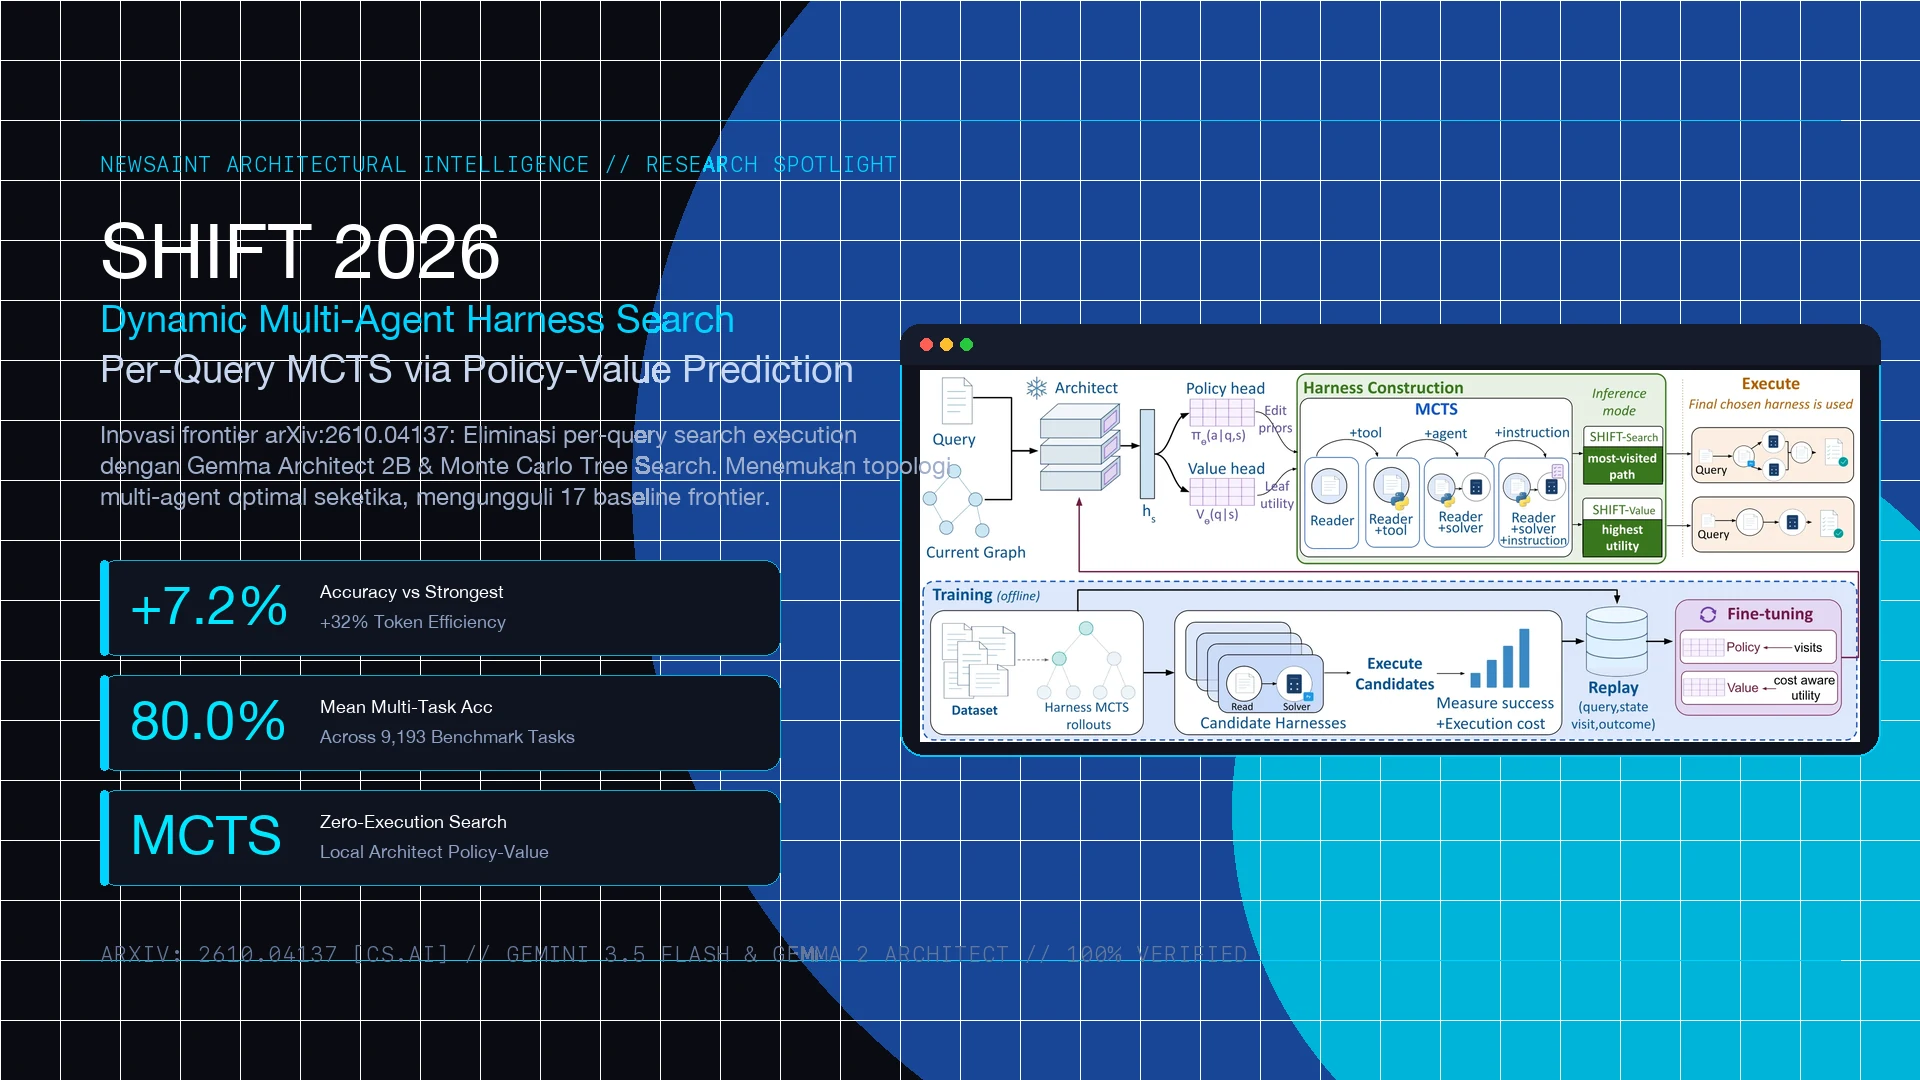
SHIFT 2026: Arsitektur Dynamic Multi-Agent Harness Search Per-Query via Policy-Value Prediction MCTS, Eliminasi Search Execution Overhead, dan Lompatan Akurasi +7.2 Poin Melampaui 17 Baseline
Analisis mendalam arsitektur riset frontier (arXiv:2610.04137, Google Cloud AI Research & Arizona State University — Som Sagar, Shasha Li, Hejie Cui, Ransalu Senanayake, Sercan O. Arik): Mengapa konfigurasi harness multi-agent (peran, instruksi, perkakas, dan topologi komunikasi) yang statis atau per-query search berbasis eksekusi langsung membentur latensi masif dan pembengkakan biaya token. Memperkenalkan SHIFT, framework yang memindahkan eksekusi keluar dari search loop per-query melalui arsitektur lokal Policy-Value Architect (Gemma 2 2B) yang memandu Monte Carlo Tree Search (MCTS) untuk menyusun executable graph optimal. Evaluasi komprehensif pada 9.193 tugas lintas 6 benchmark (GSM8K, HotpotQA, MBPP, SpreadsheetBench, OfficeQA Pro, GAIA) dengan eksekutor Gemini 3.5 Flash membuktikan SHIFT mencatat akurasi rerata tertinggi 80.0% (+7.2 poin di atas baseline terkuat), memangkas 32% token eksekusi, serta membuktikan bahwa optimasi simultan topologi, prompt, dan tools menghasilkan keunggulan +9.1 poin dibanding optimasi parsial.