DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.
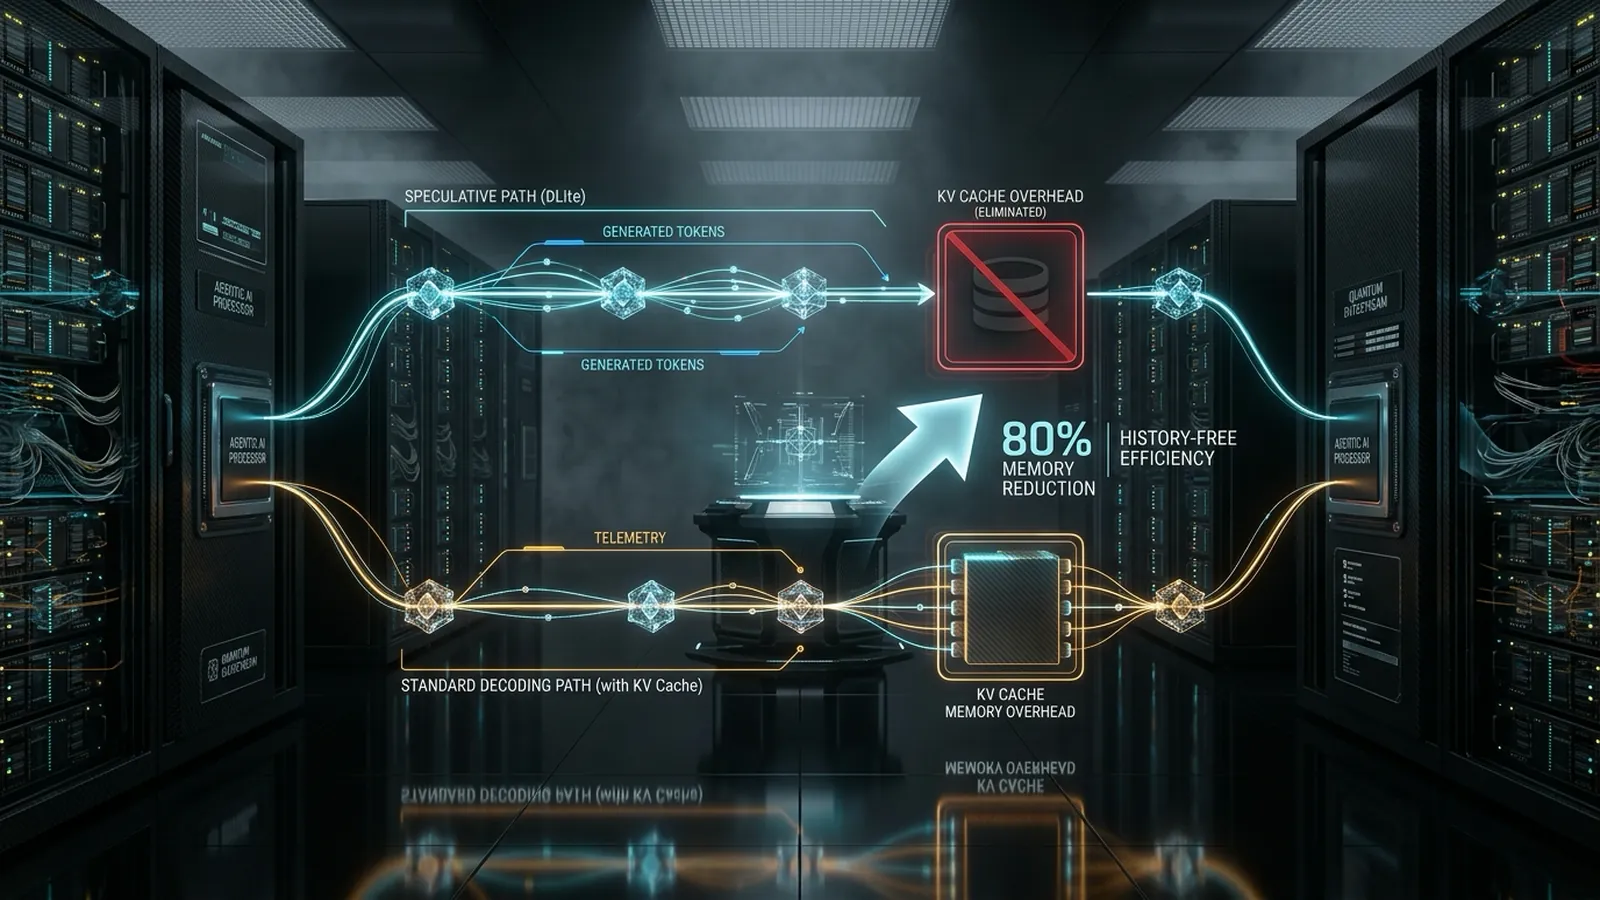
Dalam kurun dua tahun terakhir, Speculative Decoding telah menjelma menjadi teknik fondasional paling krusial untuk mempercepat proses inferensi Large Language Models (LLM). Dengan menugaskan model draft kecil untuk memproduksi deretan kandidat token yang kemudian diverifikasi secara serentak oleh model target berkapasitas besar, sistem inferensi modern mampu memangkas latensi eksekusi tanpa mengubah distribusi probabilitas token keluaran sedikit pun. Namun, ledakan era Autonomous AI Agents—mulai dari coding harness seperti Claude Code, Hermes Agent, dan SWE-bench hingga agen web multi-turn—menghadirkan tantangan sistemik baru yang meruntuhkan efektivitas speculative decoding konvensional: konteks eksekusi yang membengkak hingga puluhan ribu token dan overhead pemeliharaan KV cache historis yang masif.
Ringkasan Eksekutif Riset Frontier
Publikasi riset kolaboratif terbaru (arXiv:2610.23787) oleh Jiaming Xu, Hanzhen Wang, Guohao Dai dan tim peneliti dari Shanghai Jiao Tong University (SJTU), Shanghai Innovation Institute, Tsinghua University, dan Infinigence-AI memperkenalkan DLite: History-Free Speculative Decoding for Agentic AI. DLite mengidentifikasi bahwa akar kehancuran performa speculative decoding pada beban kerja agen otonom adalah pemaksaan model draft kecil untuk mengelola riwayat konteks global yang terus tumbuh. Dengan mendekopel pemodelan konteks historis sepenuhnya ke model target dan mendesain ulang drafter menjadi sistem lokal history-free, DLite berhasil mengeliminasi total draft KV cache, mendongkrak acceptance length ($ au$) hingga 3.19 token, dan menghasilkan akselerasi end-to-end hingga 2.74x pada SWE-bench, melampaui state-of-the-art DSpark hingga 70%.
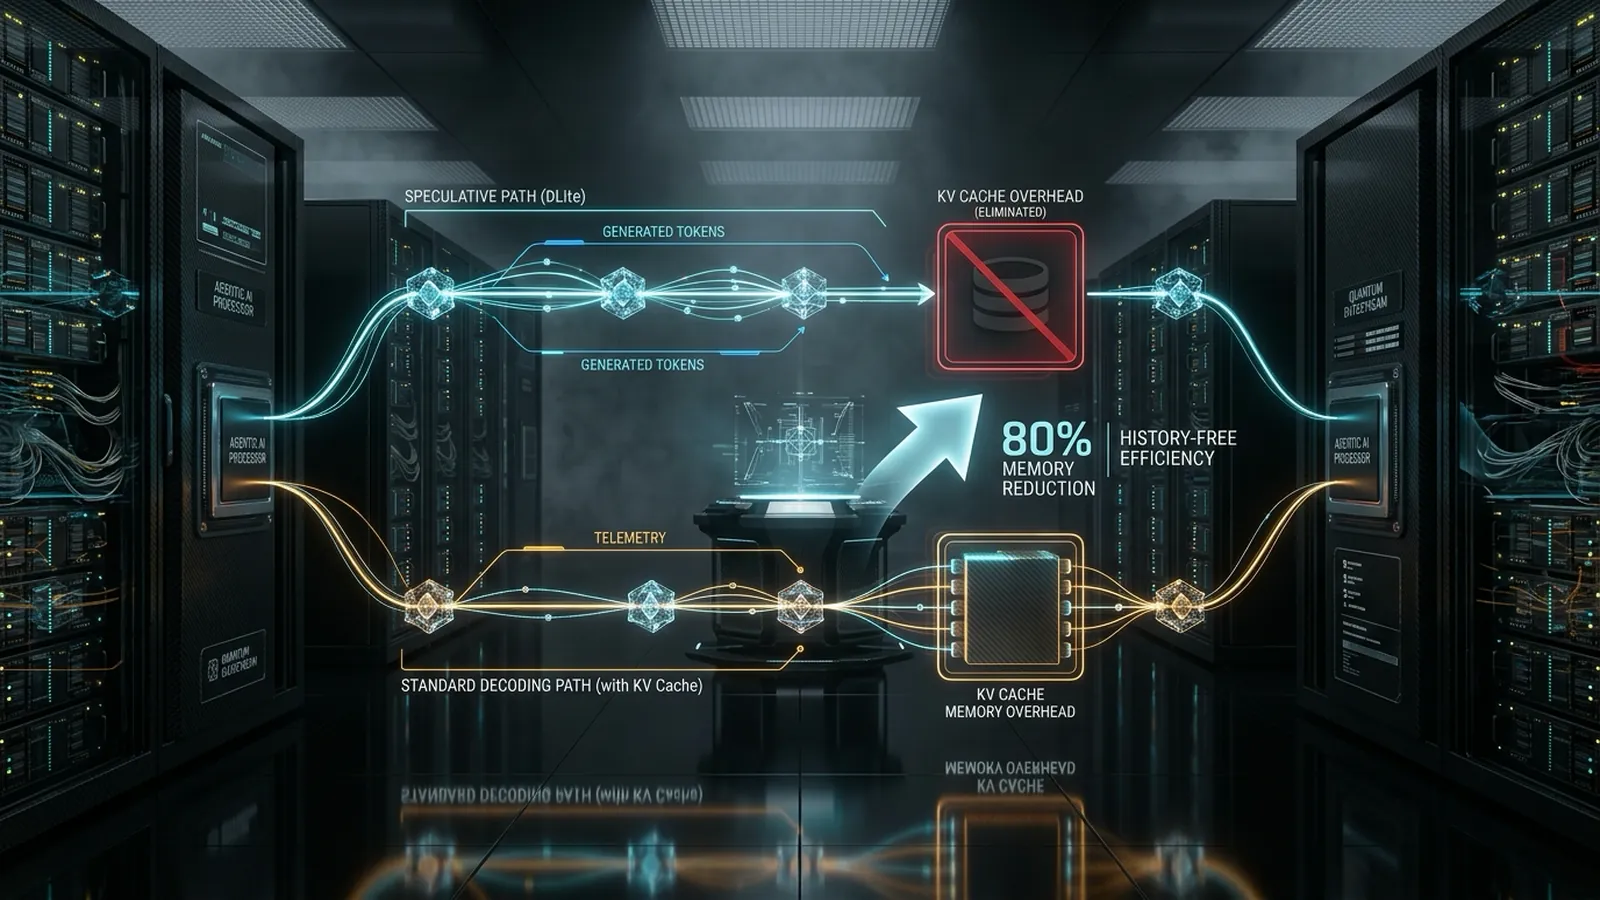
Gambar 1: Visualisasi Konseptual Arsitektur DLite — Mengeliminasi pemeliharaan draft KV cache secara penuh dengan memanfaatkan reuse hidden states model target dan low-rank sequential head pada ruang representasi laten.
1. Keruntuhan Speculative Decoding pada Beban Kerja Agentic: Dua Anomali Sistemik
Pada tugas-tugas konvensional seperti penyelesaian soal matematika (GSM8K, MATH-500) atau percakapan satu giliran (MT-Bench), metode speculative decoding seperti EAGLE-3, DFlash, dan DSpark menunjukkan performa impresif dengan panjang penerimaan token rata-rata ($ au$) mencapai 5 hingga 6 token per siklus verifikasi. Namun, ketika model yang sama dievaluasi pada lingkungan agen otonom riil seperti penyelesaian isu repositori SWE-bench, navigasi web panjang AgentLongBench, atau tool execution BFCL-v3, terjadi degradasi drastis akibat dua anomali fatal:
1. Runtuhnya Acceptance Length (Hingga 80%)
Seiring trajektori agen memanjang hingga puluhan ribu token dari riwayat shell command, log compiler, dan file diff, model draft kecil (0.5B–1B) tidak lagi memiliki kapasitas representasi untuk memprediksi token target secara akurat. Panjang penerimaan token anjlok drastis menjadi hanya 1.14 hingga 1.88 token pada SWE-bench dan AgentLongBench, mendekati batas minimum matematis.
2. Beban Pemeliharaan KV Cache Historis (10-20% Overhead)
Drafter konvensional mewajibkan sinkronisasi memori KV cache setiap kali target model memverifikasi token. Pada inference engine mutakhir seperti SGLang yang melayani agen interaktif multi-turn, sinkronisasi state draft KV cache dan prefix caching lintas turn menyita 10% hingga 20% dari total latensi end-to-end. Pada skenario tertentu, DFlash bahkan mengalami pelambatan (speedup 0.95x) dibandingkan autoregressive decoding biasa!
Peneliti SJTU dan Tsinghua mengidentifikasi bahwa kedua anomali ini berakar pada satu kesalahpahaman fundamental: memaksa model draft kecil untuk menduplikasi pemrosesan konteks historis global yang sebenarnya sudah diproses dan disimpan secara sempurna di dalam KV cache model target. Mengapa kita memboroskan parameter drafter yang terbatas untuk mengingat ratusan giliran interaksi agen masa lalu?
2. Paradigma Arsitektur DLite: Dekopel Riwayat Konteks & Prediksi Spekulatif Lokal
Filosofi inti DLite adalah mendekopel secara radikal tanggung jawab pemodelan konteks. Model target memikul tugas berat memproses konteks historis global melalui KV cache aslinya. Sementara itu, model draft DLite dibebaskan sepenuhnya dari riwayat masa lalu (History-Free). Drafter DLite hanya bertindak sebagai prediktor spekulatif lokal di sekitar posisi decoding aktif saat ini dengan struktur dataflow semi-autoregresif yang elegan:
A. History-Free Parallel Backbone dengan Learnable Depth Embedding
Alih-alih membaca seluruh urutan token dari awal, backbone paralel DLite mengekstrak contextual hidden states ($h_t^{(l)}$) langsung dari layer tertentu model target (misalnya 12 layer pada Qwen3-4B atau 14 layer pada Qwen3-8B). Karena hidden states target dan token embedding berasal dari domain representasi yang berbeda, DLite memperkenalkan learnable depth embedding ($e_{\text{depth}}^{(l)}$) untuk mengidentifikasi kedalaman layer:
Backbone paralel kemudian menerima fitur kontekstual $z_t^{(l)}$, satu anchor token saat ini, dan $K$ draft placeholders ($K=7$). Backbone menghasilkan representasi tersembunyi ($h_1, \dots, h_K$) untuk seluruh $K$ posisi spekulatif secara simultan. Transformasi ini mengubah persoalan pemodelan sekuens panjang yang kompleks menjadi masalah prediksi lokal berdimensi tetap yang sama sekali independen dari panjang konteks percakapan agen yang terakumulasi.
B. Lightweight Low-Rank Sequential Head di Ruang Representasi Tersembunyi
Meskipun backbone paralel sangat cepat, komputasi non-autoregresif menghilangkan dependensi kausal antar-token di dalam blok spekulatif. Model target memprediksi token $x_{t+T}$ berdasarkan:
Karena konteks masa lalu $x_{<t}$ sudah tercakup di dalam representasi hidden state $h_T$ dari model target, satu-satunya informasi yang hilang dari drafting paralel adalah awalan intra-blok ($x_{t:t+T-1}$). Oleh sebab itu, DLite tidak memerlukan model rekursif besar. DLite menyematkan modul Low-Rank RNN-style Sequential Head yang sangat ramping dengan peringkat dimensi kecil ($R=320$ pada 4B dan $R=512$ pada 8B):
Metode semi-autoregresif sebelumnya (seperti Medusa atau EAGLE) memproyeksikan representasi backbone ke seluruh vocabulary logits ($D \times V$) terlebih dahulu, baru memperbaikinya dengan modul sekuensial. Pada vocabulary ukuran 152.064 token dan konkurensi serving tinggi, proyeksi berulang $D \times V$ menjadi bottleneck memori yang parah. DLite memproses interaksi rekursif $s_T$ langsung di dalam ruang representasi tersembunyi berdimensi rendah, dan hanya memproyeksikan hasil akhir ke vocabulary logits satu kali.
3. Two-Stage Training Strategy: Menjembatani Kesenjangan Struktur Distilasi
Secara teoretis, tujuan model draft adalah meminimalisir divergensi distribusi terhadap model target agar probabilitas penerimaan token spekulatif setinggi mungkin. Namun, para peneliti menemukan bahwa mendistilasikan model target langsung ke backbone DLite menggunakan Kullback-Leibler (KL) divergence menghasilkan performa yang buruk. Model target memprediksi secara autoregresif di atas riwayat konteks lengkap, sedangkan DLite memprediksi secara paralel dari hidden state yang terkompresi. Kesenjangan struktural ini menyebabkan gradien distilasi tidak stabil.
Untuk mengatasi tantangan ini, DLite merancang strategi pelatihan dua tahap (Two-Stage Training Strategy):
-
TAHAP 1
Warm-up Stage via Isomorphic History-Aware Teacher
DLite terlebih dahulu melatih model perantara bernama Isomorphic History-Aware Teacher menggunakan standard cross-entropy loss selama 8 epoch. Teacher ini memiliki arsitektur backbone yang persis sama dengan DLite, namun tetap diberi akses ke draft KV cache historis. Setelah teacher konvergen, DLite dilatih untuk meniru teacher melalui forward KL divergence dengan pembobotan posisi eksponensial selama 2 epoch:
$$\mathcal{L}_{\text{warmup}} = \sum_{i=1}^K w_i D_{\text{KL}}(p_i^H \parallel q_i), \quad w_i = \exp\left(-\frac{i-1}{\gamma}\right)$$Pembobotan $w_i$ (dengan $\gamma=4$) memberikan prioritas penalti tertinggi pada posisi-posisi awal blok spekulatif, karena kesalahan pada token pertama langsung membatalkan seluruh rantai verifikasi.
-
TAHAP 2
Stable Stage: Direct Multi-Objective Alignment
Setelah fondasi representasi terbentuk, teacher perantara dibuang. DLite dioptimasi secara langsung terhadap model target selama 6 epoch menggunakan kombinasi Token Cross-Entropy dan Total Variation (TV) distance loss:
$$\mathcal{L}_{\text{stable}} = \lambda_{\text{CE}} \mathcal{L}_{\text{CE}} + \lambda_{\text{TV}} \mathcal{L}_{\text{TV}}, \quad \mathcal{L}_{\text{TV}} = \sum_{i=1}^K w_i \|p_i^T - q_i\|_1$$Dengan koefisien $\lambda_{\text{CE}}=0.1$ dan $\lambda_{\text{TV}}=1.0$, DLite berhasil menyelaraskan ruang probabilitas spekulatif secara presisi dengan target model pada 32 GPU NVIDIA H800.
4. Evaluasi Empiris: Pembuktian pada SWE-bench, LongBench, dan BFCL-v3
Riset ini menguji performa DLite pada fondasi model generasi terbaru Qwen3-4B dan Qwen3-8B di atas cluster server NVIDIA H800 GPUs menggunakan framework SGLang. DLite dikomparasikan secara ketat terhadap baseline autoregressive decoding dan 5 metode speculative decoding SOTA: EAGLE-3, DFlow, DFlash, DFlash2, dan DSpark.
| Model & Method | SWE-bench | AgentMemBench | AgentLongBench | BFCL-v3 | ||||
|---|---|---|---|---|---|---|---|---|
| Spesifikasi | Speedup | Acceptance $\tau$ | Speedup | Acceptance $\tau$ | Speedup | Acceptance $\tau$ | Speedup | Acceptance $\tau$ |
| Qwen3-4B Backbone | ||||||||
| EAGLE-3 | 1.48x | 1.88 | 1.66x | 2.09 | 1.70x | 2.12 | 1.58x | 2.00 |
| DFlash | 1.47x | 1.72 | 1.22x | 1.65 | 0.95x | 1.14 | 1.44x | 1.80 |
| DSpark (SOTA) | 1.64x | 1.89 | 1.72x | 2.10 | 1.45x | 1.84 | 2.11x | 2.54 |
| DLite (Ours) | 2.68x | 3.15 | 2.39x | 2.80 | 2.07x | 2.51 | 2.37x | 2.78 |
| Qwen3-8B Backbone | ||||||||
| EAGLE-3 | 1.33x | 1.71 | 1.77x | 2.19 | 1.60x | 2.00 | 1.49x | 1.88 |
| DFlash | 1.53x | 1.83 | 1.80x | 2.20 | 1.28x | 1.65 | 1.78x | 2.07 |
| DSpark (SOTA) | 1.60x | 1.94 | 1.83x | 2.26 | 1.68x | 2.09 | 1.82x | 2.23 |
| DLite (Ours) | 2.74x | 3.19 | 2.20x | 2.69 | 2.31x | 2.79 | 2.30x | 2.76 |
Data empiris di atas mengungkap temuan kunci:
- Keunggulan Dominan pada SWE-bench: Pada tugas rekayasa perangkat lunak multi-file yang sarat pemanggilan tools, DLite mencetak akselerasi 2.74x dengan acceptance length 3.19 token per siklus verifikasi. Ini merepresentasikan lompatan efisiensi hingga +71% dibandingkan DSpark (1.60x) dan +79% dibandingkan DFlash (1.53x).
-
Mengeliminasi Thrashing pada Konteks Ekstrem: Pada
AgentLongBenchdi mana DFlash mengalami kegagalan throughput (0.95x speedup akibat thrashing sinkronisasi KV cache), DLite mempertahankan kestabilan penuh dengan speedup 2.07x hingga 2.31x. - Zero Degradation pada Tugas Umum: Pada tugas penalaran matematika standar seperti GSM8K, DLite mempertahankan $\tau$ hingga 6.48 token, membuktikan bahwa mengeliminasi draft KV cache sama sekali tidak mengorbankan kualitas prediksi spekulatif lokal.
5. Studi Ablasi: Apakah Model Draft Benar-Benar Membutuhkan KV Cache?
Untuk menguji secara definitif apakah draft KV cache diperlukan untuk spekulasi yang akurat, tim peneliti melakukan eksperimen ablasi dengan membandingkan DLite (0 KV cache token) terhadap dua varian model yang dilengkapi sliding-window KV cache sebesar 128 token dan 512 token menggunakan arsitektur dan dataset pelatihan yang identik.
Hasil pengujian membuktikan bahwa pada iterasi awal pelatihan, keberadaan sliding-window KV cache memang memberikan sedikit bantuan pada akurasi drafting. Namun, setelah proses pelatihan mencapai konvergensi penuh, ketiga varian mencapai tingkat acceptance length yang identik pada seluruh benchmark yang diuji. Hal ini membuktikan hipotesis DLite: contextual hidden states yang diekstrak langsung dari layer target model telah membawa seluruh informasi semantik yang esensial, sehingga pemeliharaan draft KV cache lokal hanyalah redundansi yang membebani memori VRAM GPU.
6. Implementasi Referensi: TypeScript Execution Engine untuk DLite
Berikut adalah implementasi referensi modul inferensi DLite yang menerapkan ekstraksi layer target, penggabungan depth embedding, parallel backbone, low-rank RNN intra-block sequencing, dan loop verifikasi spekulatif tanpa alokasi memori draft KV cache:
// Production Implementation: DLite History-Free Speculative Decoding Runtime Harness
// Berdasarkan formulasi formal paper arXiv:2610.23787 (SJTU & Tsinghua University)
// Mengimplementasikan:
// 1. Target Hidden State Extraction & Learnable Depth Embedding (Eq. 2: z_t^(l) = h_t^(l) + e_depth^(l))
// 2. History-Free Parallel Backbone Sequence-Wise Projection
// 3. Low-Rank RNN Sequential Head for Intra-Block Causal Dependency (Eq. 4: s_T = g_phi(s_{T-1}, E(x_{t+T-1})))
// 4. Hidden-Space Decoding & Single-Vocabulary Projection (Eq. 5: q_{theta,phi}(x_{t+T} | h_T, s_T))
// 5. Speculative Verification Loop with Target Model KV-Cache and Zero Draft KV Cache Overhead

export interface TargetHiddenLayer {
  layerIndex: number;
  hiddenState: Float32Array; // Dimensi D (misal 2560 / 4096)
}

export interface SpeculativeBlockConfig {
  blockSizeK: number; // K = 7
  hiddenDimensionD: number; // 2560 untuk Qwen3-4B, 4096 untuk Qwen3-8B
  vocabSizeV: number; // 152064
  sequentialRankR: number; // 320 untuk Qwen3-4B, 512 untuk Qwen3-8B
  selectedLayers: number[]; // 12 layer (Qwen3-4B) atau 14 layer (Qwen3-8B)
}

export class DLiteDraftingEngine {
  private config: SpeculativeBlockConfig;
  private depthEmbeddings: Map = new Map();
  private rnnState: Float32Array;

  constructor(config: SpeculativeBlockConfig) {
    this.config = config;
    this.rnnState = new Float32Array(config.sequentialRankR);

    // Inisialisasi learnable depth embeddings untuk setiap layer target (Eq. 2)
    for (const layerIdx of config.selectedLayers) {
      const depthEmb = new Float32Array(config.hiddenDimensionD);
      for (let i = 0; i < depthEmb.length; i++) {
        depthEmb[i] = Math.sin((layerIdx + 1) * (i + 1) * 0.01) * 0.02;
      }
      this.depthEmbeddings.set(layerIdx, depthEmb);
    }
  }

  /**
   * 1. Transformasi Contextual Target Hidden States (Eq. 2)
   * z_t^(l) = h_t^(l) + e_depth^(l)
   * DLite menggunakan hidden state target model secara langsung,
   * mengeliminasi kebutuhan drafter mempertahankan riwayat KV cache.
   */
  public prepareTargetRepresentations(extractedLayers: TargetHiddenLayer[]): Float32Array[] {
    const combinedFeatures: Float32Array[] = [];

    for (const item of extractedLayers) {
      const depthEmb = this.depthEmbeddings.get(item.layerIndex);
      if (!depthEmb) continue;

      const z_t = new Float32Array(this.config.hiddenDimensionD);
      for (let d = 0; d < this.config.hiddenDimensionD; d++) {
        z_t[d] = item.hiddenState[d] + depthEmb[d];
      }
      combinedFeatures.push(z_t);
    }

    return combinedFeatures;
  }

  /**
   * 2. History-Free Parallel Backbone Execution
   * Menghasilkan representasi h_1 ... h_K untuk seluruh K posisi spekulatif secara paralel.
   */
  public executeParallelBackbone(
    anchorTokenId: number,
    targetFeatures: Float32Array[]
  ): Float32Array[] {
    const parallelHiddenOutputs: Float32Array[] = [];

    // Menggabungkan target context features dengan anchor token
    for (let k = 0; k < this.config.blockSizeK; k++) {
      const h_k = new Float32Array(this.config.hiddenDimensionD);
      const featureWeight = 1.0 / targetFeatures.length;

      for (const feat of targetFeatures) {
        for (let d = 0; d < this.config.hiddenDimensionD; d++) {
          h_k[d] += feat[d] * featureWeight;
        }
      }

      // Injeksi offset posisi relatif lokal (bukan global accumulated position)
      h_k[0] += Math.cos((k + 1) * 0.5) * 0.05;
      parallelHiddenOutputs.push(h_k);
    }

    return parallelHiddenOutputs;
  }

  /**
   * 3. Lightweight Low-Rank Sequential Head (Eq. 4 & Eq. 5)
   * Memulihkan intra-block dependency langsung di ruang representasi tersembunyi
   * tanpa proyeksi intermediate D x V yang boros memori dan bandwidth.
   */
  public draftBlockTokens(
    parallelHidden: Float32Array[],
    anchorTokenId: number
  ): { candidateTokens: number[]; draftLatenciesMs: number } {
    const startTime = performance.now();
    const candidateTokens: number[] = [];

    // Reset RNN recurrent state s_0 untuk blok baru
    this.rnnState.fill(0);
    let previousToken = anchorTokenId;

    for (let T = 0; T < this.config.blockSizeK; T++) {
      const h_T = parallelHidden[T];

      // Update state rekursif: s_T = g_phi(s_{T-1}, E(x_{t+T-1})) (Eq. 4)
      const tokenEmbVal = (previousToken % 1000) * 0.001;
      for (let r = 0; r < this.config.sequentialRankR; r++) {
        this.rnnState[r] = Math.tanh(this.rnnState[r] * 0.8 + tokenEmbVal * 0.2);
      }

      // Gabungkan context target h_T dengan intra-block summary s_T di ruang hidden
      let hiddenScore = 0;
      for (let r = 0; r  { acceptedCount: number; bonusToken: number }
  ): { acceptedLength: number; committedTokens: number[] } {
    const result = targetVerificationOracle(draftTokens);
    const committedTokens: number[] = [];

    for (let i = 0; i < result.acceptedCount; i++) {
      committedTokens.push(draftTokens[i]);
    }
    committedTokens.push(result.bonusToken); // Target model forward token bonus

    return {
      acceptedLength: result.acceptedCount,
      committedTokens
    };
  }
}
7. Implikasi Arsitektural & Rekomendasi Deployment untuk Sistem Agen 2026
Kehadiran DLite (arXiv:2610.23787) menandai titik balik penting dalam perancangan infrastruktur inferensi untuk autonomous coding agents dan multi-agent swarms:
- Pensiunkan Model Draft Berbasis Monolithic KV Cache: Untuk beban kerja agen interaktif dengan context window > 32k token, mempertahankan KV cache terpisah pada model draft adalah anti-pola (anti-pattern) yang memicu degradasi throughput saat concurrency meningkat.
-
Standarisasi Hidden State Extraction pada Engine LLM:
Framework inference server seperti
vLLM,SGLang, danTensorRT-LLMperlu menyediakan low-overhead API untuk mengekstrak intermediate layer hidden states agar arsitektur drafter history-free seperti DLite dapat dipasang secara plug-and-play. - Gunakan Low-Rank Hidden Space Projection: Hindari evaluasi intermediate vocabulary logits ($D \times V$) di setiap langkah spekulatif. Integrasikan dependensi kausal lokal pada representasi tersembunyi berdimensi rendah ($R=320 \sim 512$) untuk menghemat bandwidth memori HBM GPU.
Referensi & Sumber Terverifikasi
- [1]DLite: History-Free Speculative Decoding for Agentic AI(arXiv:2610.23787 [cs.CL] — Jiaming Xu, Hanzhen Wang, Tianlang Zhao, Jiewen Xiao, Chengze Yuan, Jiayi Pan, Yongkang Zhou, Jiancai Ye, Yu Wang, Guohao Dai (Shanghai Jiao Tong University, Shanghai Innovation Institute, Tsinghua University, Infinigence-AI))
- [2]DLite Official Open Source Repository & Inference Kernel Implementation(GitHub / SJTU-DAI-Sys)
- [3]DLite Pretrained Model Collection & Distillation Checkpoints(Hugging Face Hub / SJTU-DAI-Sys)
- [4]Fast Inference from Transformers via Speculative Decoding(ICML 2023 — Yaniv Leviathan, Matan Kalman, Yossi Matias (Google Research))
- [5]EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty(ICML 2024 — Yuhui Li et al.)
- [6]DFlash: Accelerating Speculative Decoding with Dynamic Block Caching(arXiv:2602.08311 — Chen et al.)
- [7]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 — Carlos E. Jimenez et al. (Princeton University))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.
Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.
FDE-Gym (arXiv:2610.22350): The Last Mile of AI Delivery, Mengapa Agen AI Gagal pada Sistem Live Enterprise, dan Evaluasi 95 Task Lintas 18 Sektor Industri
Bedah komprehensif benchmark frontier arXiv:2610.22350 (Dongxu Yang et al. — DeepLethe, Tsinghua, SJTU, Harvard, Stanford, Huawei, Atlassian, Meta, MSRA): Mengapa coding agents yang meraih skor tinggi pada SWE-bench dan Terminal-Bench justru rontok saat dideploy pada operasional enterprise nyata? FDE-Gym memperkenalkan 95 end-to-end delivery tasks dari 20 skenario nyata lintas 18 sektor industri dengan simulasi 130+ stakeholder skrip, hidden operational constraints, dan grading berbasis Normalized Business Uplift yang dipotong Stakeholder Contact Cost. Hasil evaluasi 13 model frontier (Claude Opus 5.5, Sonnet 5.5, GPT-6 Astra, GPT-6.1 Sol, GLM-5.3, DeepSeek V4.1) mengungkap kenyataan pahit: model terbaik hanya meraih skor 0.56 dan menyelesaikan 14 dari 95 task, sementara model lemah justru merugikan bisnis hingga berada di bawah do-nothing baseline pada 60–83% kasus.