Skeleton Coding (arXiv:2610.38214): Program Structure sebagai Spesifikasi AI Coding Agents — Mengapa Behavioral Testing Gagal, Reduksi 48.4% Test Error, dan Efisiensi Biaya 26x Lipat
Analisis arsitektural riset frontier AWS Agentic AI (arXiv:2610.38214, Aditya Golatkar, Alessandro Achille, Renos Zabounidis, Vlad Sobal, Stefano Soatto): Mengapa paradigma specification-driven development berbasis pengujian perilaku semata (behavioral testing / vibe coding) mengalami kegagalan eksponensial pada coding agent, bagaimana Skeleton Coding menggabungkan struktur kode tingkat tinggi (type stubs, local contracts, global invariants) dengan behavioral specs untuk memangkas error rate hingga 48.4%, menjembatani gap model kecil 52.4% dengan penghematan biaya token 15–26x, mereduksi code erosion 24.7%, dan implementasi runtime verifier siap produksi.
Mengapa Behavioral Testing Saja Tidak Pernah Cukup: Bagaimana Struktur Kode Memangkas Kompleksitas Kendali AI Coding Agents
Selama bertahun-tahun, paradigma rekayasa perangkat lunak mengagungkan prinsip separation of concerns: developer menentukan "apa" yang harus dicapai (melalui unit test, user stories, atau input-output examples), sementara agen AI bebas menentukan "bagaimana" mengimplementasikannya. Praktik ini melahirkan tren vibe coding dan specification-driven development tanpa intervensi arsitektur.
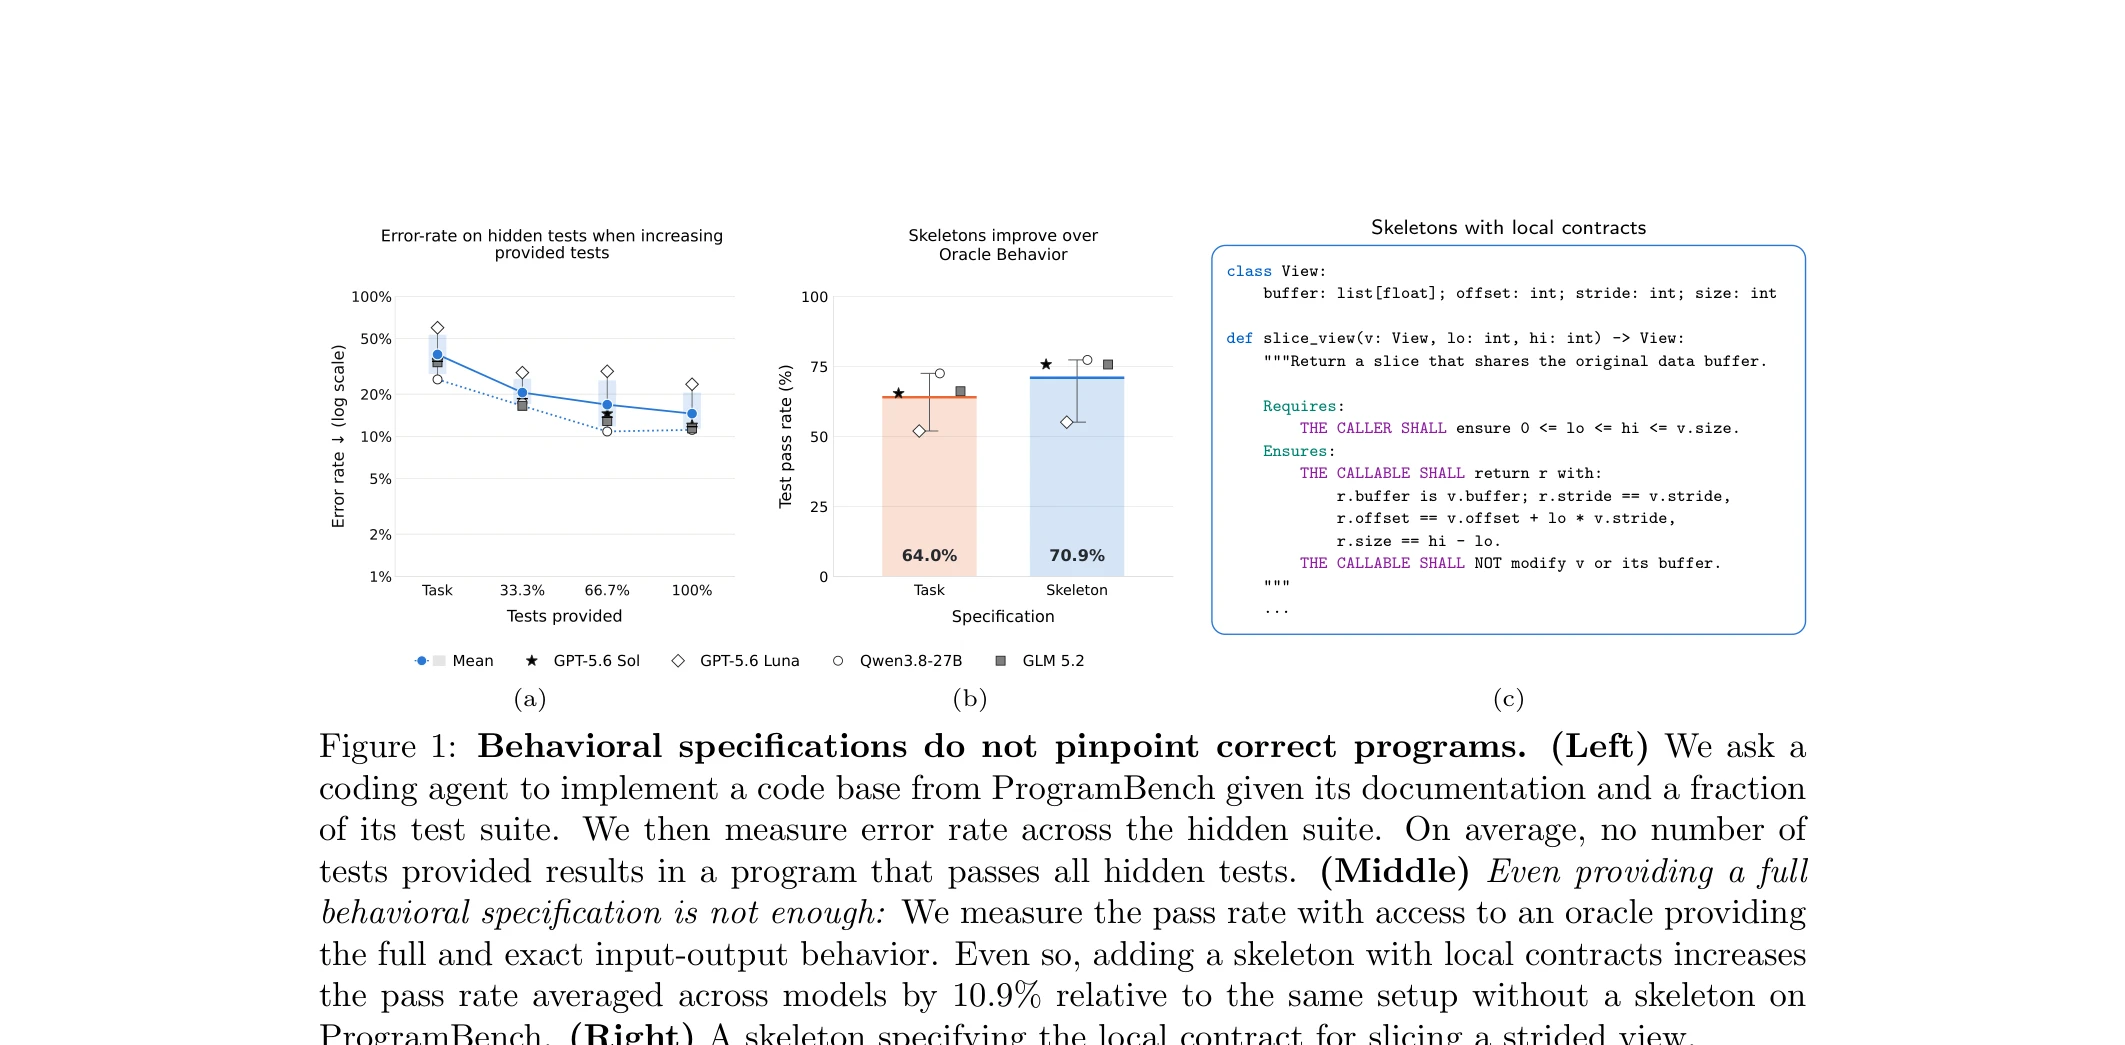
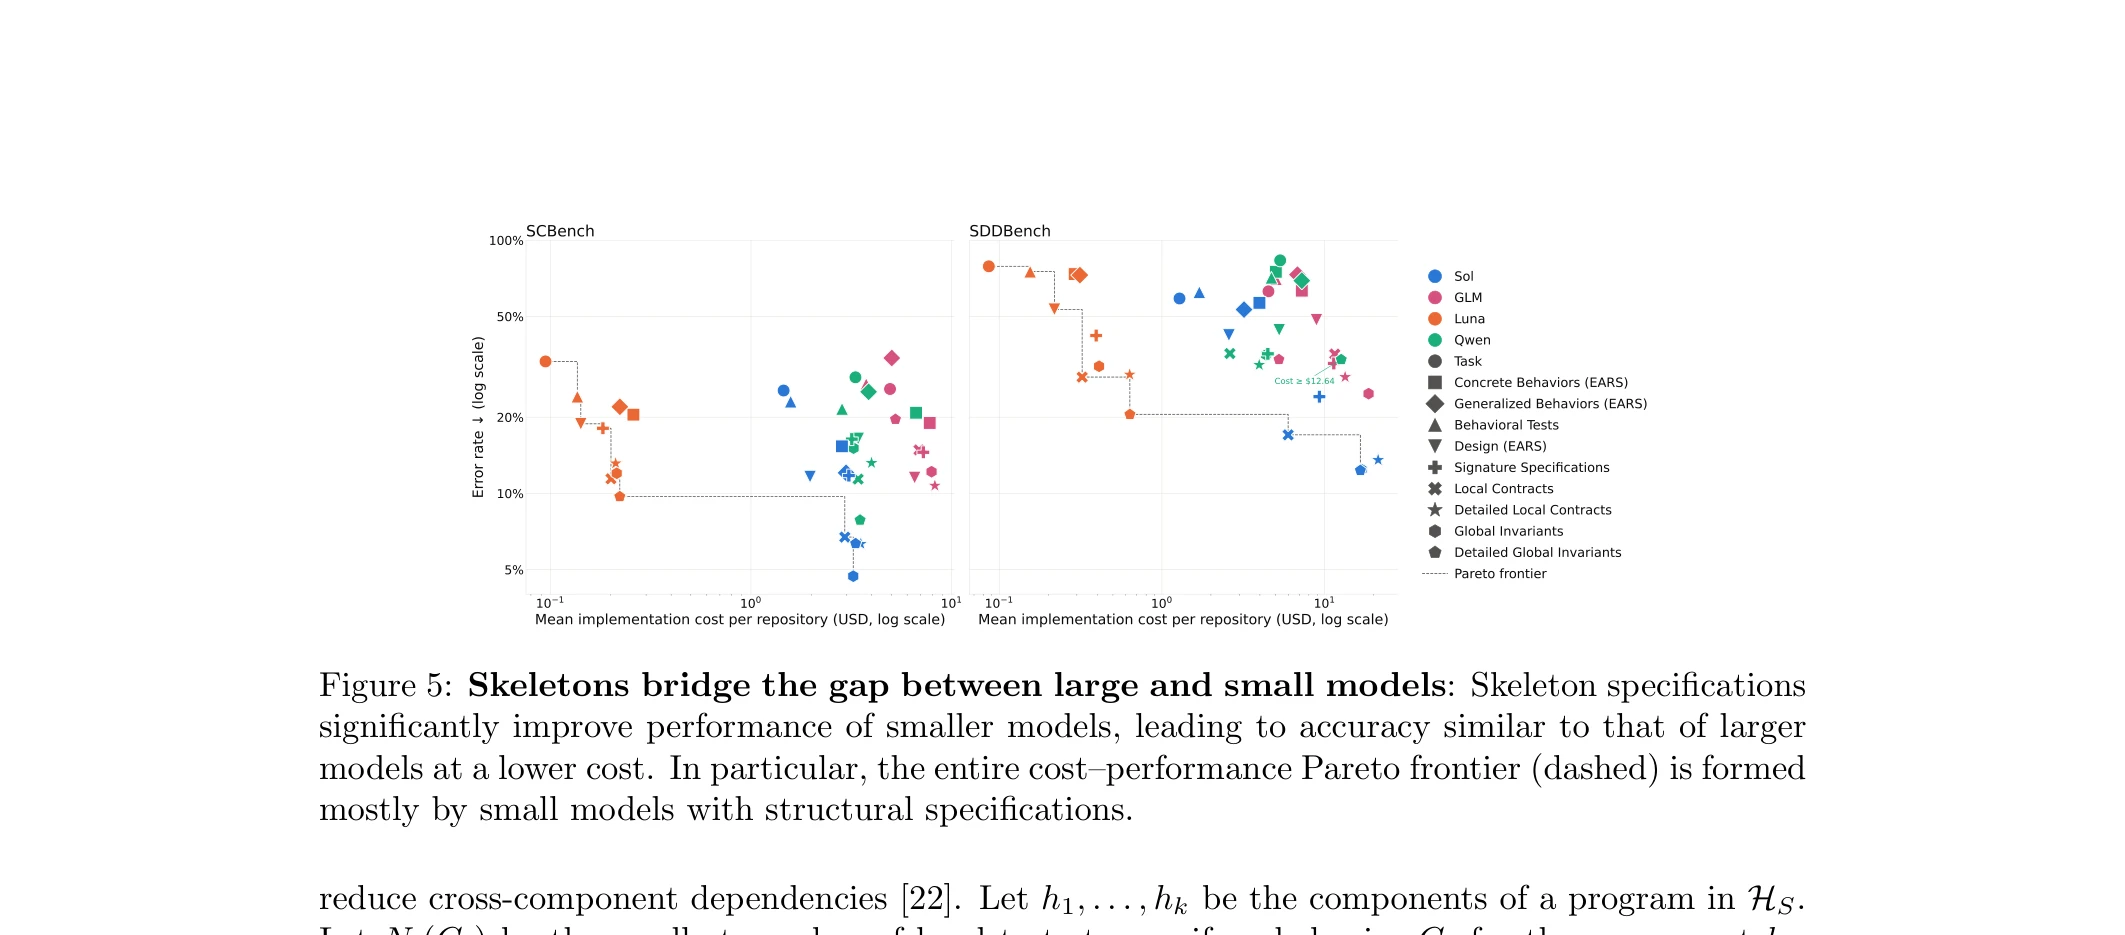
Makalah terbaru dari tim AWS Agentic AI (Aditya Golatkar, Alessandro Achille, Renos Zabounidis, Vlad Sobal, Stefano Soatto et al., arXiv:2610.38214) membuktikan secara matematis dan empiris bahwa paradigma tersebut memiliki cacat fundamental. Berapa banyak test case yang dibutuhkan untuk memvalidasi suatu program bukanlah properti dari fungsi yang diuji, melainkan konsekuensi dari struktur internal yang dipilih agen. Ketika agen dibiarkan memilih struktur secara mandiri, ruang hipotesis membengkak hingga memerlukan pengujian berorde eksponensial ($O(2^n)$). Melalui Skeleton Coding—di mana developer menyertakan skema struktur kode (tipe data, signature fungsi, local contracts, dan invarian global)—test error berhasil ditekan hingga 48.4%, efisiensi biaya token melonjak 15–26x, dan code erosion berkurang drastis 24.7%.
1. Masalah Pengendalian: Mengapa Jumlah Test Case Bergantung pada Struktur
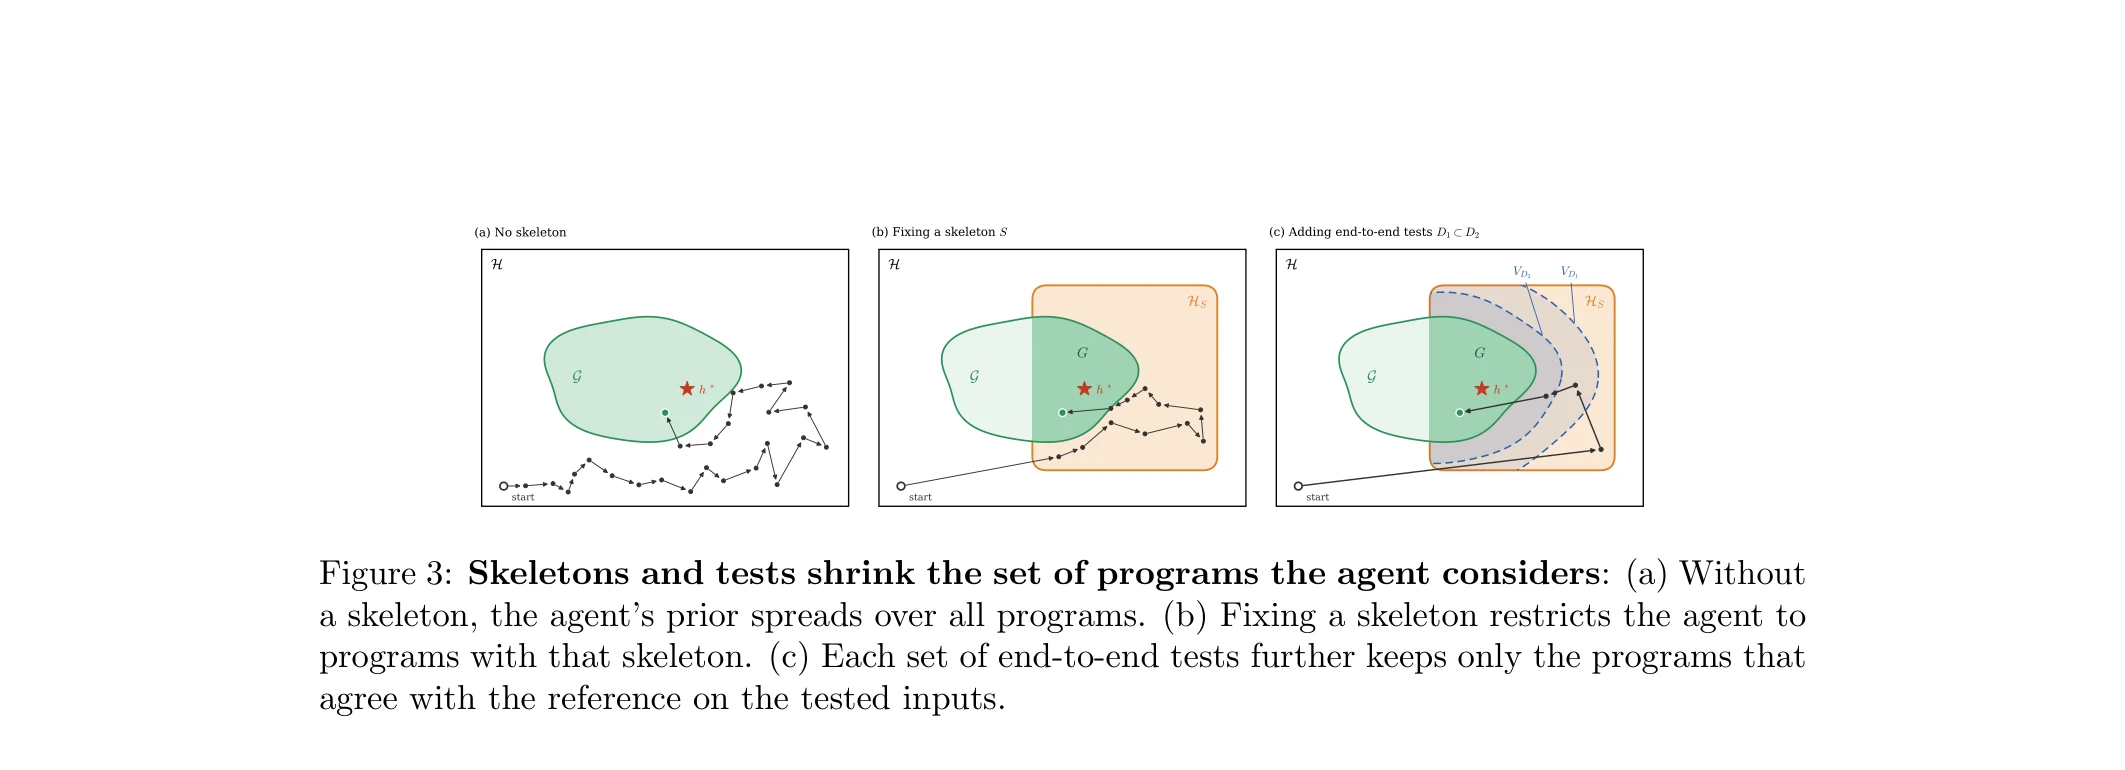
Misalkan $\mathcal{H}$ adalah himpunan seluruh kemungkinan kode program yang dapat di-generasi oleh model bahasa, dan $\mathcal{G} \subseteq \mathcal{H}$ adalah himpunan program yang dianggap benar dan memuaskan niat developer. Developer ingin memberikan spesifikasi $D$ sedemikian rupa sehingga distribusi probabilitas posterior model $p_0(\mathcal{G} \mid D) \ge 1 - \delta$ untuk nilai toleransi kesalahan $\delta$ yang sangat kecil.
Ketika developer hanya menyediakan tes perilaku ujung-ke-ujung (end-to-end behavioral tests), model mula-mula harus memilih struktur internal atau arsitektur $S$. Probabilitas keberhasilan sistem secara keseluruhan adalah rata-rata terbobot dari seluruh pilihan struktur yang mungkin:
Inilah akar malapetaka pada agen coding otonom: tes perilaku tidak hanya menyaring program di dalam struktur tertentu, tetapi juga mengubah probabilitas pemilihan struktur itu sendiri. Jika agen memilih struktur yang lemah ($S_A$), setiap pengujian yang diberikan developer hanya mampu mengeliminasi satu program keliru ($1/(2^d - d)$). Sebaliknya, pada struktur yang kokoh ($S_B$), setiap pengujian membelah dua ruang pencarian secara optimal ($1/2^d$).
2. Separasi Eksponensial: Teorema 2.2 dan Teorema 2.4
AWS Agentic AI membuktikan dua teorema kunci yang menjelaskan mengapa pengujian unit lokal berbasis kontrak jauh lebih superior dibandingkan tes integrasi black-box:
Untuk mengidentifikasi program identik nol dengan $n$ komponen internal, tes perilaku end-to-end membutuhkan setidaknya:
Sebaliknya, dengan membuka observabilitas status internal melalui signature dan interface skeleton, cukup $4n$ tes lokal untuk memverifikasi program secara sempurna tanpa pencarian brute-force.
Total usaha verifikasi developer terpecah menjadi penjumlahan komponen lokal dan tes kompatibilitas:
Bila modul dirancang dengan modularitas tinggi (zero cross-component leak), nilai $J_S = 0$, mengubah beban pengujian dari masalah perkalian kombinatorial menjadi penjumlahan linear sederhana $\sum N_i$.
3. Evaluasi Empiris: SCBench, SDDBench, dan ProgramBench
Penelitian ini menguji 4 keluarga model frontier (GPT-5.6 Sol, GPT-5.6 Luna, Qwen3.8-27B, dan GLM 5.2) yang dijalankan melalui runtime orkestrasi open-source ai-functions pada 3 benchmark rekayasa perangkat lunak berskala repositori:
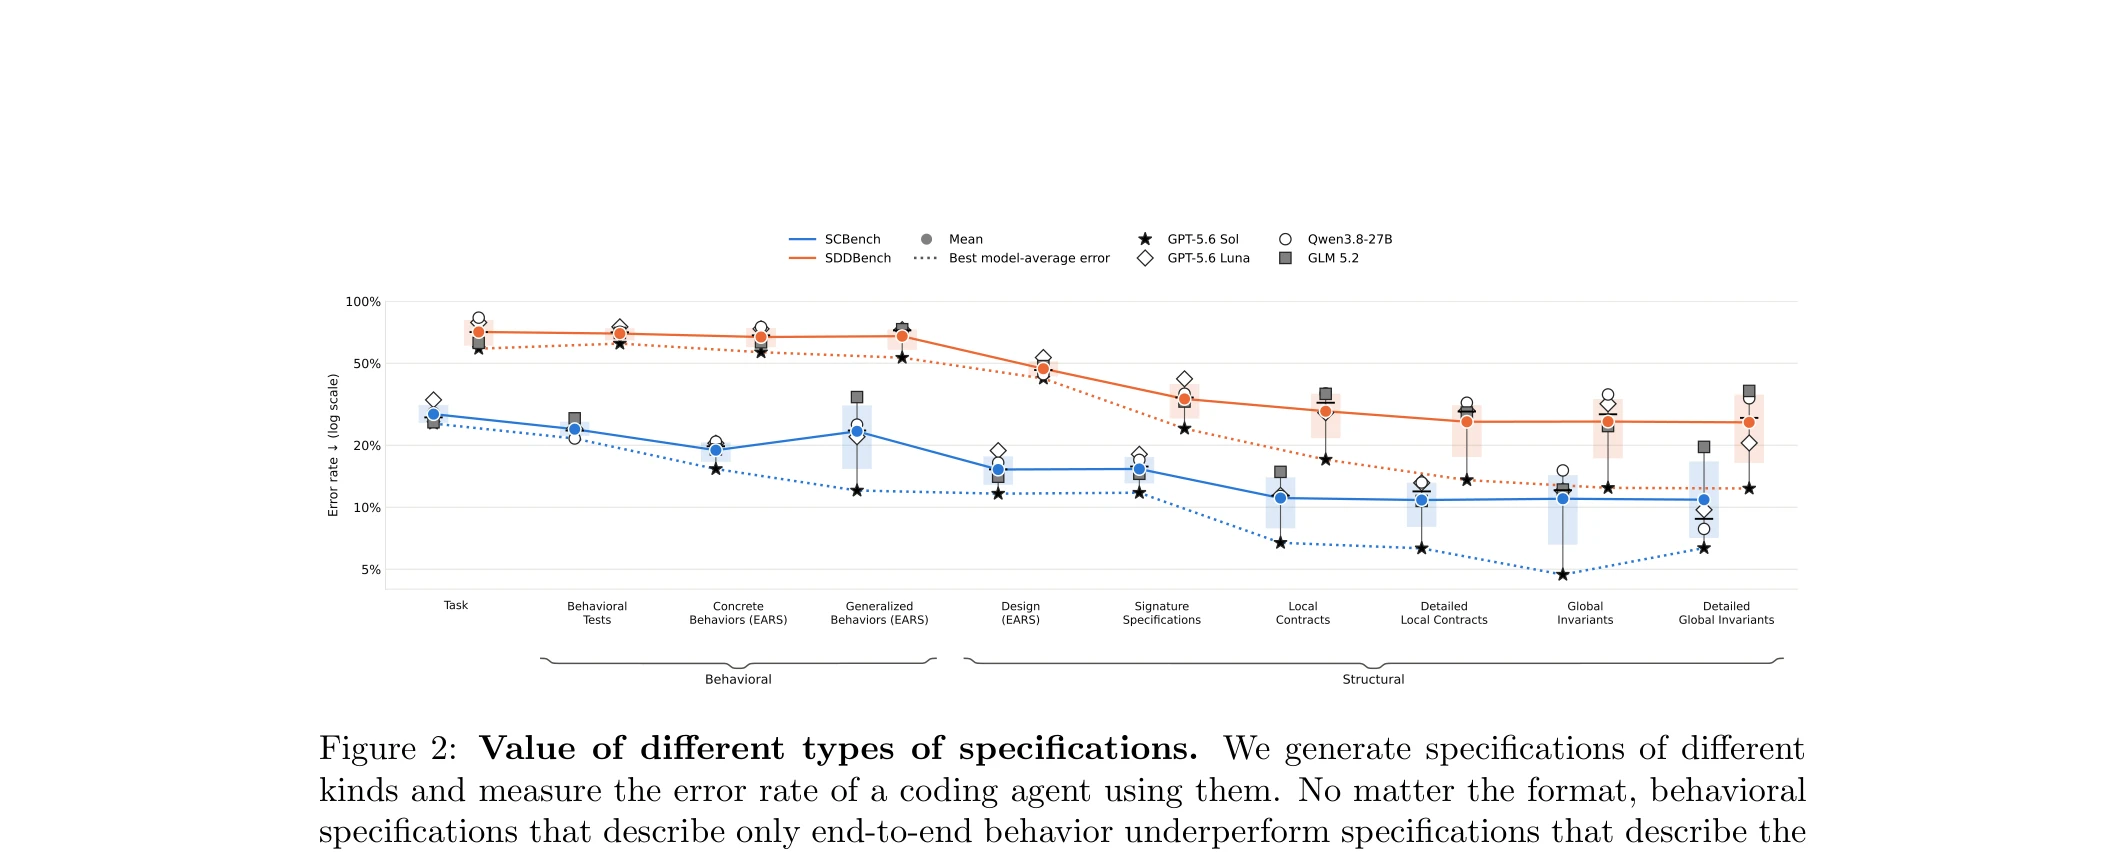
| Tipe Spesifikasi | Pass Rate SDDBench | Pass Rate SCBench | Mean Test Error ↓ | Code Erosion ↓ |
|---|---|---|---|---|
| Task Only (Vibe Coding Baseline) | 29.0% | 72.0% | 58.2% | 0.58 |
| Concrete Behaviors (EARS) | 35.4% | 76.1% | 51.4% | 0.62 |
| Public Behavioral Tests Suite | 38.4% | 79.2% | 48.8% | 0.67 (Erosion Naik!) |
| Function Stubs (Signature Specs) | 62.8% | 84.5% | 31.2% | 0.49 |
| Local Contracts (Pre/Post Conditions) | 70.1% | 87.6% | 26.8% | 0.45 |
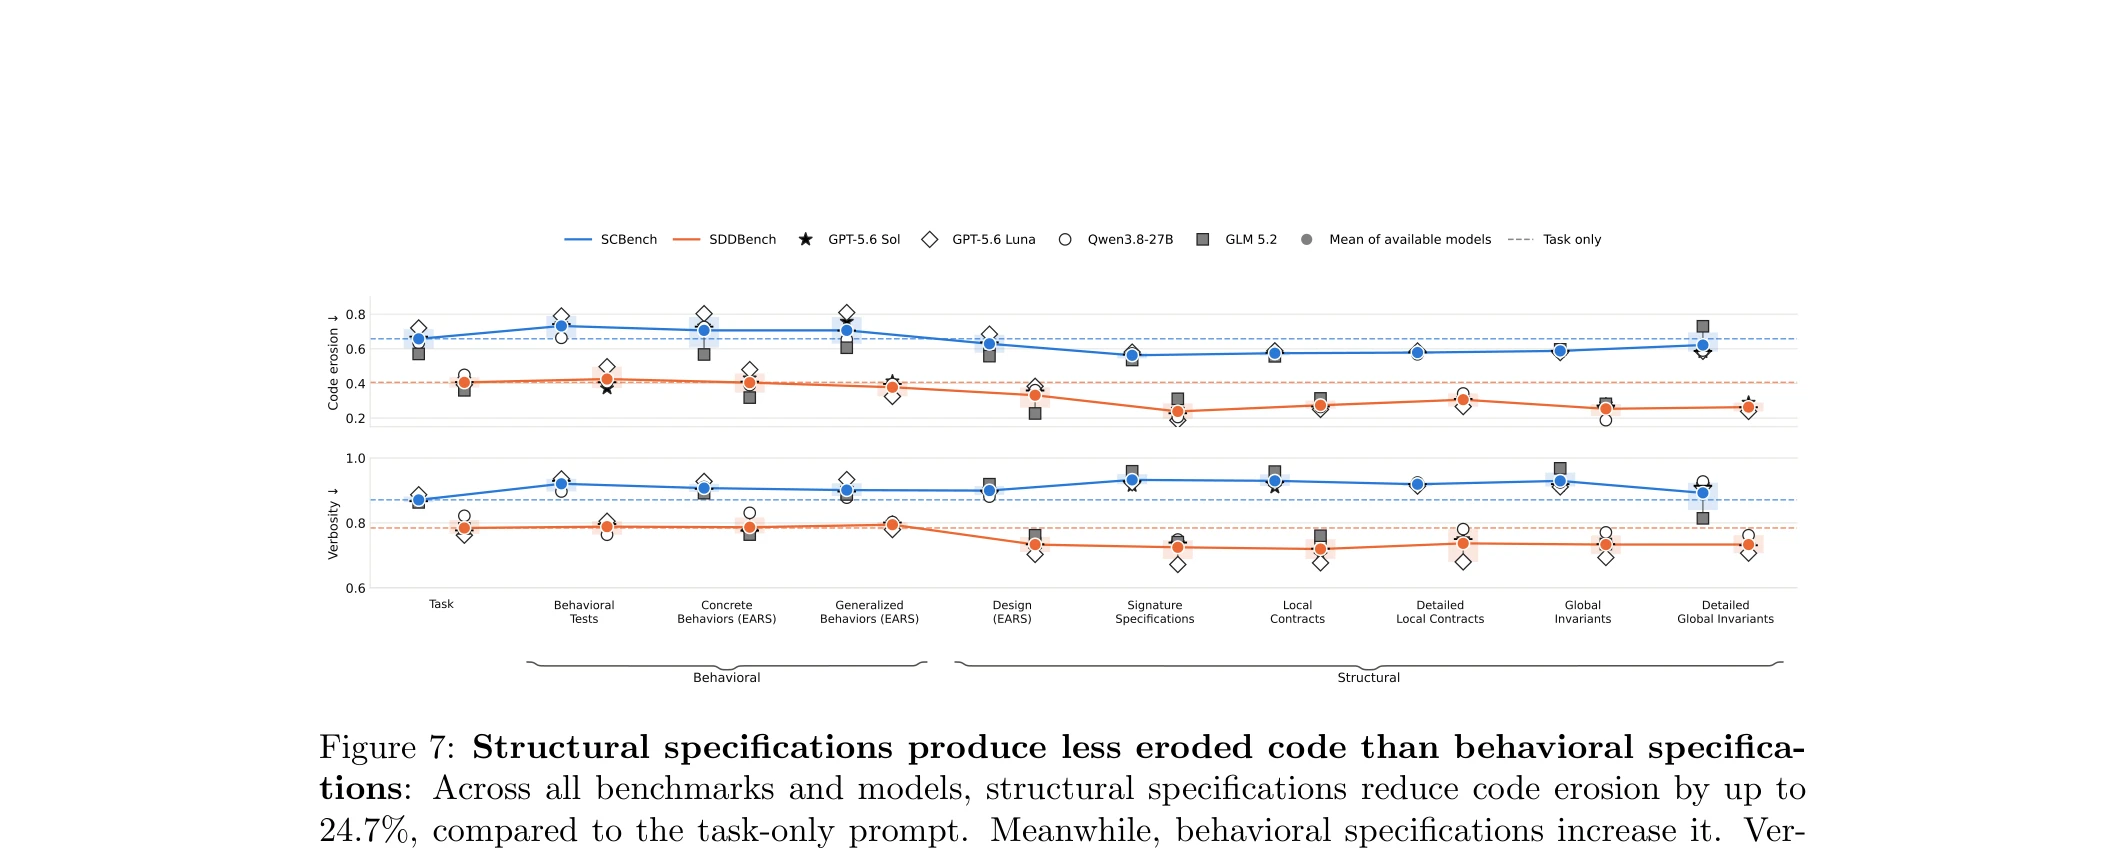
| Global Invariants + Local Contracts | 74.2% (+45.2 pp) | 89.0% (+17.0 pp) | 25.1% (-48.4% Error) | 0.43 (-24.7% Erosion) |
4. Mengapa Behavioral Testing Meningkatkan Code Slop dan Code Erosion
Salah satu temuan paling mengejutkan dalam makalah ini menyangkut kualitas kode internal. Dalam rekayasa tradisional, kita berasumsi bahwa semakin banyak unit test yang dibuat, semakin rapi dan berkualitas kode yang dihasilkan.
Pada agen AI, yang terjadi justru kebalikannya:
Ketika agen hanya diberikan kegagalan test suite tanpa batasan struktur, agen cenderung melakukan accidental monkey-patching: menambahkan blok if/else percabangan liar di lapisan paling luar, membuat variabel global temporer, atau menduplikasi logika guna memuaskan test runner. Metrik Code Erosion (proporsi bobot kompleksitas siklomatis > 10) meningkat dari 0.58 menjadi 0.67 saat behavioral tests ditambahkan!
Sebaliknya, Skeleton Coding mengunci signature dan memecah modularitas sejak awal, memaksa agen menulis fungsi-fungsi ringkas yang fokus pada satu kontrak. Hasilnya: Code Erosion terpangkas 24.7% dan model terbebas dari jebakan AI code slop.
5. Implementasi Arsitektur: Skeleton & Local Contract Harness Engine
Berikut adalah implementasi referensi controller TypeScript untuk harness coding agent otonom. Harness ini memverifikasi kesesuaian AST terhadap kelas hipotesis $\mathcal{H}_S$ sebelum mengevaluasi prakondisi dan pascakondisi lokal:
// Production Implementation: Skeleton Coding & Contract Verification Engine
// Berdasarkan Prinsip Rekayasa arXiv:2610.38214 (AWS Agentic AI)
// Memisahkan Verifikasi Struktur (Hypothesis Shrinking) dari Sintesis Fungsi (Local Contracts)

export interface LocalContract {
  requires: string[]; // Prakondisi input (caller obligations)
  ensures: string[];  // Pasca-kondisi output (callable guarantees)
  pure?: boolean;     // Menjamin ketiadaan mutasi pada state eksternal
}

export interface FunctionStub {
  name: string;
  signature: string;
  parameters: Record<string, string>;
  returnType: string;
  docstring: string;
  contract?: LocalContract;
  cyclomaticLimit?: number;
}

export interface SkeletonModule {
  modulePath: string;
  dataTypes: Record<string, string>; // Typed interfaces / structs
  dependencies: string[];            // Imported module boundaries
  functions: FunctionStub[];
  globalInvariants: string[];        // Invarian lintas fungsi pada INVARIANTS.md
}

export interface VerificationResult {
  passed: boolean;
  stage: 'STRUCTURAL_AST' | 'LOCAL_CONTRACT' | 'GLOBAL_INVARIANT';
  component: string;
  error?: string;
  cyclomaticComplexity: number;
}

export class SkeletonCodingHarness {
  private readonly modules: Map<string, SkeletonModule> = new Map();

  public registerSkeleton(module: SkeletonModule): void {
    this.modules.set(module.modulePath, module);
  }

  /**
   * Menilai apakah implementasi agen mematuhi Skeleton Structure H_S
   * Mencegah agen melakukan over-engineering atau mengubah layout tipe data internal
   */
  public verifyStructuralAdherence(
    modulePath: string,
    generatedAst: {
      exportedTypes: string[];
      exportedFunctions: string[];
      externalImports: string[];
    }
  ): { valid: boolean; violations: string[] } {
    const skeleton = this.modules.get(modulePath);
    if (!skeleton) throw new Error(`Module ${modulePath} not registered in skeleton!`);

    const violations: string[] = [];

    // 1. Verifikasi Batas Dependensi (Mencegah arsitektur bocor)
    for (const imp of generatedAst.externalImports) {
      if (!skeleton.dependencies.includes(imp)) {
        violations.push(`Illegal dependency import: '${imp}' violates module boundary of ${modulePath}`);
      }
    }

    // 2. Verifikasi Deklarasi Fungsi (Mencegah fungsi publik siluman)
    const expectedFuncs = new Set(skeleton.functions.map(f => f.name));
    for (const fn of generatedAst.exportedFunctions) {
      if (!expectedFuncs.has(fn)) {
        violations.push(`Undeclared public function '${fn}' alters architecture hypothesis class H_S`);
      }
    }

    return {
      valid: violations.length === 0,
      violations,
    };
  }

  /**
   * Mengevaluasi Local Contracts (Pre & Post Conditions)
   * Mengisolasi kegagalan pada level subrutin (Theorem 2.4: O(sum N_i) vs O(2^n))
   */
  public async evaluateLocalContract(
    modulePath: string,
    funcName: string,
    inputState: any,
    executionFn: () => Promise<any>
  ): Promise<VerificationResult> {
    const skeleton = this.modules.get(modulePath);
    const stub = skeleton?.functions.find(f => f.name === funcName);

    if (!stub || !stub.contract) {
      return { passed: true, stage: 'LOCAL_CONTRACT', component: funcName, cyclomaticComplexity: 1 };
    }

    // 1. Verifikasi Prakondisi (Requires)
    for (const req of stub.contract.requires) {
      const isReqValid = this.assertCondition(req, inputState);
      if (!isReqValid) {
        return {
          passed: false,
          stage: 'LOCAL_CONTRACT',
          component: funcName,
          error: `Precondition violation: ${req}`,
          cyclomaticComplexity: 1,
        };
      }
    }

    // Snapshot state jika fungsi bertanda pure
    const stateSnapshot = stub.contract.pure ? JSON.stringify(inputState) : null;

    // 2. Eksekusi Fungsi yang Dihasilkan Agen
    let result: any;
    try {
      result = await executionFn();
    } catch (err) {
      return {
        passed: false,
        stage: 'LOCAL_CONTRACT',
        component: funcName,
        error: `Execution threw runtime error: ${(err as Error).message}`,
        cyclomaticComplexity: 1,
      };
    }

    // 3. Verifikasi Purity
    if (stateSnapshot && JSON.stringify(inputState) !== stateSnapshot) {
      return {
        passed: false,
        stage: 'LOCAL_CONTRACT',
        component: funcName,
        error: 'Purity violation: Function mutated input argument state in-place',
        cyclomaticComplexity: 1,
      };
    }

    // 4. Verifikasi Pasca-kondisi (Ensures)
    for (const ens of stub.contract.ensures) {
      const isEnsValid = this.assertCondition(ens, { input: inputState, result });
      if (!isEnsValid) {
        return {
          passed: false,
          stage: 'LOCAL_CONTRACT',
          component: funcName,
          error: `Postcondition violation: ${ens}`,
          cyclomaticComplexity: 1,
        };
      }
    }

    return {
      passed: true,
      stage: 'LOCAL_CONTRACT',
      component: funcName,
      cyclomaticComplexity: 1,
    };
  }

  private assertCondition(conditionExpr: string, context: any): boolean {
    // Evaluasi deklaratif predikat lokal kontrak
    try {
      const fn = new Function('ctx', `with(ctx) { return Boolean(${conditionExpr}); }`);
      return Boolean(fn(context));
    } catch {
      return true; // Fallback jika ekspresi berbasis bahasa alami EARS
    }
  }
}
6. Panduan Implementasi untuk Tim Engineering
Jika tim Anda memanfaatkan coding agents (seperti Hermes, Claude Code, Codex, atau Antigravity) dalam pipeline CI/CD atau pengembangan aplikasi harian, adopsi 3 kaidah utama ini:
Tulis Stubs Tipe Sebelum Menulis Prompt
Jangan pernah meminta agen membangun modul dari instruksi teks mentah. Definisikan file .d.ts, .pyi, atau interface Rust terlebih dahulu. Mengunci ruang hipotesis $\mathcal{H}_S$ sejak awal menghemat ribuan token penalaran liar.
Gunakan Model Ringkas yang Dipandu Skeleton
Daripada membakar biaya komputasi besar pada model 100B+ untuk tugas coding greenfield tanpa struktur, pasangkan model 8B–27B yang gesit dengan skeleton dan local contracts. Akurasi Anda setara model raksasa dengan biaya 15–26x lebih ekonomis.
Isolasi Siklus Perbaikan via Kontrak Lokal
Saat terjadi kegagalan tes, jangan kirim seluruh riwayat eksekusi ke agen dalam loop terbuka. Terapkan verifikasi mekanis pada kontrak fungsi individual agar perbaikan terjadi secara lokal tanpa memicu erosi pada modul lain yang sudah stabil.
Referensi & Sumber Terverifikasi
- [1]Skeleton Coding: Program Structure as a Specification for Agents(arXiv:2610.38214 [cs.SE, cs.AI, cs.LG] — Aditya Golatkar, Alessandro Achille, Renos Zabounidis, Vlad Sobal, Yangruibo Ding, Baishakhi Ray, Jonathan Buck, Guy Van den Broeck, Maryam Fazel, Pietro Perona, Wei Xia, Stefano Soatto (AWS Agentic AI))
- [2]SlopCodeBench (SCBench): Quantifying Code Erosion and Accidental Complexity in Agentic Repositories(arXiv:2609.11204 — Amazon Web Services & UCLA)
- [3]ProgramBench: A Benchmark for Program Synthesis with Oracle Behavioral Executables(arXiv:2608.08912 — Microsoft Research & Caltech)
- [4]AI Functions Framework: Open-Source Execution Harness for Specification-Driven Coding Agents(Strands Labs / GitHub — strands-labs/ai-functions)
- [5]From Vibe to Spec: An Empirical Study to Demystify Specifications in Code Generation(Proceedings of the 41st IEEE/ACM International Conference on Automated Software Engineering (ASE 2026))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
EnvSched (arXiv:2610.37609): Environment-Aware Scheduling untuk Rollout-Efficient Agent Reinforcement Learning — Dual-Relation Graph, Prediksi Reward Variance, dan Rekor 48.81 Skor Qwen3-8B pada 40 Langkah GRPO
Analisis arsitektural riset frontier PKU, Tsinghua, XJTU, Samsung Research, CASIA, dan CUHK (arXiv:2610.37609, Sihan Yang, Weichen Bai, Ruichuan An, Yifan Zhang, Wentao Zhang): Mengapa penjadwalan data RL berbasis prompt individual (DPS, LEEPS) gagal saat scaling ke ribuan environment simulasi, bagaimana EnvSched memodelkan pasangan Environment-Task via Dual-Relation Graph (Within-Environment vs Cross-Environment), memprediksi reward variance historis untuk alokasi batch eksplorasi-eksploitasi, melipatgandakan efisiensi komputasi GPU 3x lipat, dan implementasi scheduler siap produksi.
Heads of Security (arXiv:2610.37657): Learned Attention Gates untuk Robustness Prompt Injection — Pemisahan Instruksi-Data via 46K Parameter, Reduksi ASR RL-Hammer 97% ke 10%, dan Preservasi Utilitas Tool Calling
Analisis arsitektural riset frontier Imperial College London, Tübingen AI Center, ELLIS Institute, Max Planck, dan Fraunhofer HHI (arXiv:2610.37657, Igor Shilov, Xiaoxue Yang, Alexander Panfilov, Jonas Geiping, Yves-Alexandre de Montjoye): Mengapa metode finetuning (SecAlign++) dan arsitektural masif (ASIDE) gagal menjaga utilitas few-shot dan merusak kapabilitas tool use agen, bagaimana Heads of Security (HoS) merekayasa pemisahan instruksi-data hanya dengan 46.080 scalar gate logits per-head (0.00006% parameter model), menahan serangan adaptive RL-Hammer hingga ASR tersisa 1-10% (vs 82-97%), memaksa serangan white-box Claudini membutuhkan 3x lipat komputasi FLOPs, dan implementasi arsitektur inference gating siap produksi.
GEPA-Curator (arXiv:2610.37651): Mengeliminasi Halusinasi Refleksi pada Self-Improving AI Agents via Adaptive Task Curation, Contrastive Prior Success, dan Meta-Harness Optimization
Analisis arsitektural riset frontier UC Berkeley, Furiosa AI, dan KAIST (arXiv:2610.37651, Zack Yu, Nicholas Lee, Matei Zaharia, Amir Gholami): Mengapa optimasi prompt reflektif (GEPA, ACE) rentan mengalami misatribusi kegagalan akibat keterbatasan harness dan kelemahan lingkungan eksternal, bagaimana GEPA-Curator menyaring tugas bising via Adaptive Task Curation dan menyajikan trajektori sukses kontrastif (Prior Success Retrieval), menghasilkan lonjakan akurasi hingga +21.2% di AppWorld dan WebArena, serta implementasi outer-loop harness siap produksi.