VeriCUA (arXiv:2610.40578): Verification as Agentic Exploration untuk Computer-Using Agents — Mengatasi Keterbatasan Pasif VLM Judge, Adaptive Hybrid Action Space, dan Penurunan 50% False Positive Rate
Analisis arsitektural riset frontier Google dan The University of Hong Kong (arXiv:2610.40578, Qiushi Sun, Da Yu, Alexander Knop, Amer Sinha, Lingpeng Kong, Ben Kao, Ravi Kumar, Pritish Kamath): Mengapa evaluator pasif (VLM Judge) dan script otomatis statis gagal memverifikasi keberhasilan Computer-Using Agents (CUAs) akibat observasi parsial digital environment, bagaimana arsitektur VeriCUA memformulasikan verifikasi sebagai eksplorasi agentik aktif berbasis dynamic rubric synthesis, adaptive hybrid action space (GUI + shell/database reads), penegakan disiplin bukti attested vs asserted, lonjakan akurasi online AndroidWorld ke 90.5% (decided accuracy 95.1%), pemangkasan false positive rate hingga separuh, dan implementasi verification harness siap produksi.
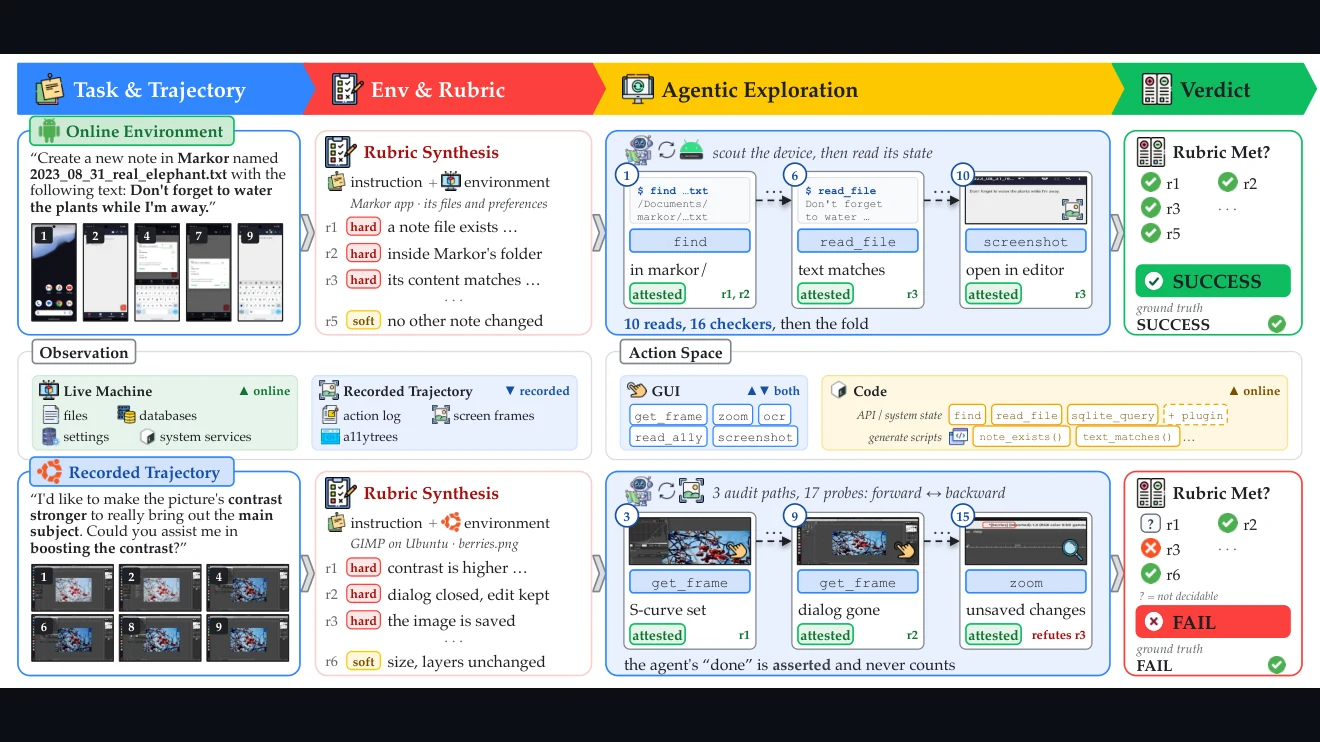
Ledakan kapabilitas Computer-Using Agents (CUAs)—agen AI multimodal yang berinteraksi langsung dengan antarmuka grafis sistem operasi desktop (OSWorld), perangkat seluler (AndroidWorld), dan aplikasi web kompleks (WebArena)—telah menyingkap satu paradoks mendasar dalam rekayasa AI otonom: agen semakin lihai mengeksekusi aksi, namun evaluator otomatis semakin tak berdaya memastikan apakah tugas tersebut benar-benar sukses diselesaikan.
Selama ini, industri bersandar pada dua paradigma evaluasi otomatis: Passive VLM Judges (model visi-bahasa yang memeriksa riwayat tangkapan layar trajektori secara pasif) dan Auto-Generated Verifiers (skrip evaluasi yang di-generate sekali jalan untuk membaca state mesin). Keduanya menderita cacat fatal yang sama: keterbatasan observasi parsial (partial observability). VLM Judge buta terhadap isi menu tersembunyi, popup yang telah tertutup, atau proses background; sementara verifier berbasis kode statis kerap keliru menebak path penyimpanan internal atau gagal memvalidasi fidelitas visual.
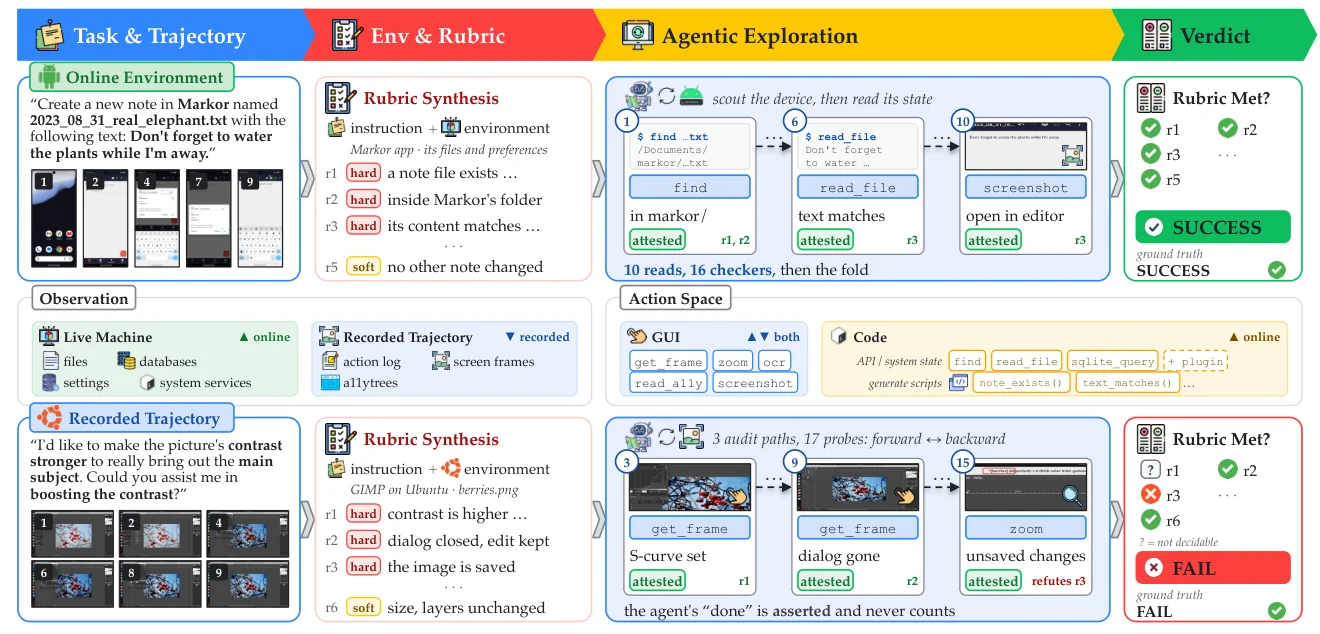
Gambar 1: Alur kerja VeriCUA (arXiv:2610.40578). Verifikasi diformulasikan sebagai eksplorasi agentik aktif: Environment Inspection → Rubric Synthesis → Adaptive Hybrid Action Space → Rule-Based Arbitration.
Melalui riset frontier kolaboratif Google Research dan The University of Hong Kong bertajuk "VeriCUA: Verification as Agentic Exploration for Computer-Using Agents" (arXiv:2610.40578, Qiushi Sun, Da Yu, Alexander Knop, Amer Sinha, Lingpeng Kong, Ben Kao, Ravi Kumar, Pritish Kamath), diresmikan paradigma baru: Verification as Agentic Exploration. Alih-alih menilai secara pasif atau kaku, agen verifier bertindak sebagai detektif otonom yang secara aktif menginterogasi sistem operasi pasca-eksekusi untuk mengumpulkan bukti tak terbantahkan (attested evidence).
1. Anatomi Masalah: Mengapa Evaluator Pasif Mengalami Halusinasi Verifikasi
Dalam reinforcement learning (RL) dan kurasi dataset pelatihan agen, reward signal yang salah (false positive reward) jauh lebih merusak dibanding false negative. Bila verifier menyatakan agen "sukses" padahal agen hanya mengeklik tombol tanpa menyimpan data, model RL akan mengalami reward hacking dan runtuh dalam waktu singkat.
Evaluator konvensional mengalami tiga kendala arsitektural sistemik:
Ilusi Trajektori Statis
VLM Judge hanya menerima rekaman frame langkah agen. Jika agen mengeklik "Save As" pada detik ke-14 namun dialog tertutup pada detik ke-15, VLM tidak tahu apakah berkas benar-benar tertulis di filesystem atau gagal akibat disk penuh / error permission.
Kerapuhan Skrip Evaluasi
Pembuat kode verifier otomatis sering mengasumsikan path berkas standar (misal ~/Documents/notes.txt). Ketika aplikasi menulis data ke SQLite internal atau SharedPreferences Android tersembunyi, skrip mengklaim tugas gagal padahal tugas tuntas sempurna.
Dilema Biner Tanpa Opsi Abstain
Sistem evaluasi klasik memaksa output biner [True / False]. Saat bukti tidak lengkap, model menebak secara probabilistik, yang berujung pada tingkat False Positive Rate mencapai 27.9% di lingkungan desktop OSWorld.
2. Arsitektur VeriCUA: Eksplorasi Aktif Lintas Tiga Modalitas State
VeriCUA memisahkan verifikasi menjadi proses penalaran dinamis berulang. Diberikan instruksi $g$ dan status mesin pasca-eksekusi $s_T$, VeriCUA membedah lingkungan ke dalam tiga representasi terpisah:
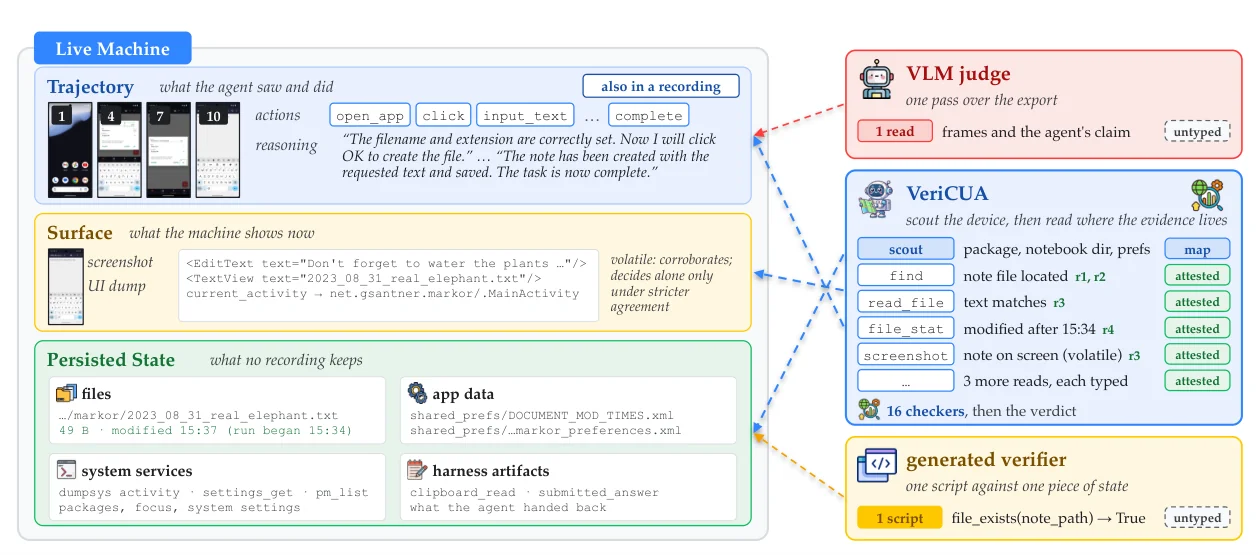
Gambar 2: Tiga modalitas observasi VeriCUA: (1) Trajectory historis, (2) Surface GUI interaktif pasca-tugas, dan (3) Persisted Machine State (file/database) via sandboxed shell execution.
- Trajectory Source $mathcal{S}_{ ext{traj}}$: Catatan histori frame rekaman, log aksi mouse/keyboard, dan penalaran token yang dilakukan agen selama durasi tugas.
- Surface GUI Source $mathcal{S}_{ ext{surface}}$: Tampilan visual langsung antarmuka desktop/ponsel saat ini. Verifier dapat mengambil screenshot baru, mengklik elemen UI, menggulir layar, atau membaca accessibility tree (a11ytree).
- Persisted State Source $mathcal{S}_{ ext{persist}}$: Berkas fisik pada filesystem, record pada tabel SQLite, registry OS, hingga proses daemon yang berjalan, diinspeksi melalui perkakas kode terisolasi (sandboxed shell commands).
3. Disiplin Bukti: Penegakan Attested vs Asserted & Keputusan Tiga Status
Inovasi paling esensial dalam desain VeriCUA adalah Evidence Discipline. Verifier tidak boleh menganggap pernyataan teks dari agen ("Saya telah berhasil menyimpan dokumen") sebagai kebenaran.
| Tipe Bukti | Definisi Operasional | Otoritas dalam Rubrik | Contoh Kasus |
|---|---|---|---|
| Attested Evidence | Observasi langsung terhadap artefak nyata mesin pasca-eksekusi | Mampu mengubah status requirement menjadi met atau unmet |
Output ls -la menunjukkan berkas terbuat; screenshot fresh menampilkan badge "Paid" |
| Asserted Evidence | Klaim sepihak agen pelaksana atau niat sebelum aksi dijalankan | TIDAK BISA meloloskan requirement; hanya memandu arah eksplorasi verifier | Teks respons akhir agen: "File berhasil disimpan ke folder download" |
| Three-Valued Output | Output verifikasi: {success, fail, abstain} |
Mencegah polusi false positive pada data kurasi RL | Jika bukti hilang/ambigu, verifier memilih abstain daripada menebak |
4. Hasil Eksperimen: Penurunan 50% False Positive & Rekor Akurasi OSWorld
Evaluasi komprehensif dilakukan pada tiga benchmark online interaktif (AndroidWorld, OSWorld, ScienceBoard) serta benchmark rekaman offline lintas platform (OSReward, OSReward-Hard, WebArena).
| Environment | Evaluator Architecture | Precision | Recall | Overall Acc | False Positive Rate (FPR) ↓ | Decided Acc |
|---|---|---|---|---|---|---|
| AndroidWorld | Passive VLM Judge | 79.3% | 69.7% | 78.4% | 15.4% | 78.4% |
| Auto-Generated Verifier | 77.8% | 84.8% | 82.4% | 16.9% | 82.4% | |
| VeriCUA (Ours) | 90.6% | 87.9% | 90.5% | 7.7% (-50.0%) | 95.1% | |
| OSWorld (Desktop) | Passive VLM Judge | 68.2% | 75.0% | 73.4% | 27.9% | 73.4% |
| Auto-Generated Verifier | 70.6% | 78.1% | 75.9% | 25.9% | 75.9% | |
| VeriCUA (Ours) | 80.3% | 71.3% | 79.5% | 13.9% (-50.2%) | 88.7% |
Keunggulan paling mencolok tampak pada metrik False Positive Rate (FPR):
- Di AndroidWorld, FPR dipangkas tepat separuh, dari 15.4% menjadi hanya 7.7%.
- Di desktop kompleks OSWorld, FPR terpangkas lebih dari separuh, dari 27.9% turun drastis ke 13.9%.
- Pada subset trajektori sulit OSReward-Hard, akurasi VeriCUA mencapai 70.4% (Balanced Acc 68.3%), melampaui TRM (57.4%), CUAJudge (63.4%), dan OS-Themis (65.7%).
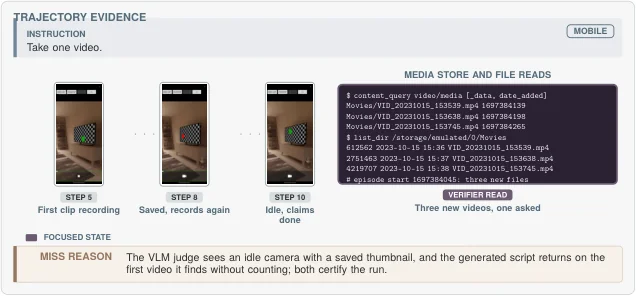
Inspeksi kamera Android: VeriCUA membuka album untuk memastikan video benar-benar tersimpan di storage fisik.
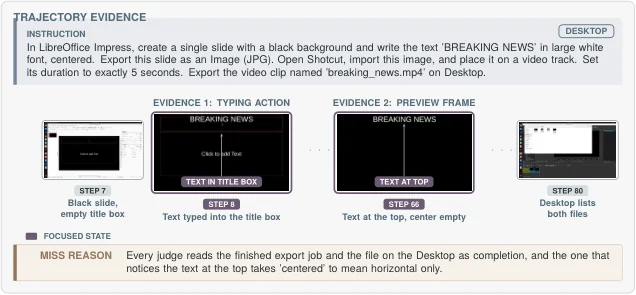
Inspeksi Shotcut di Linux Desktop: verifier memverifikasi rendering file MP4 alih-alih hanya melihat timeline GUI.
5. Implementasi Rekayasa: VeriCUA Exploration & Evidence Discipline Engine
Berikut adalah arsitektur TypeScript siap produksi untuk mengintegrasikan mesin verifikasi VeriCUA ke dalam harness pengujian agen AI:
${VERICUA_CODE_SNIPPET}6. Panduan Implementasi untuk Arsitek AI Agent & Platform RL
Bagi tim engineer yang sedang membangun pipeline evaluasi CUA atau reward model RL (seperti GRPO atau PPO):
Pisahkan Eksekutor dari Verifier (Role Decoupling)
Jangan pernah membiarkan agen yang sama menilai kelulusan tugasnya sendiri. Agen selalu memiliki kecenderungan konfirmasi (self-confirmation bias) untuk menyatakan pekerjaannya berhasil meskipun terjadi silent error di latar belakang.
Terapkan Kebijakan Abstain pada RL Data Filtering
Dalam kurasi trajectory expert untuk SFT (Supervised Fine-Tuning) atau reward modeling, abaikan trajektori dengan status abstain. Menganggap data ambigu sebagai "sukses" menyuntikkan noise destruktif ke gradien loss model.
Manfaatkan Hybrid Action Space: Padukan CLI dengan GUI
Jika lingkungan Anda mengizinkan akses shell lokal (seperti via ADB pada Android atau SSH/bash pada VM desktop), gunakan pembacaan kode (filesystem stat, sqlite3 query) untuk memverifikasi perubahan state persisten. Kode jauh lebih cepat, murah biaya token, dan 100% deterministik dibanding parsing tangkapan layar.
Referensi & Sumber Terverifikasi
- [1]VeriCUA: Verification as Agentic Exploration for Computer-Using Agents(arXiv:2610.40578 [cs.AI, cs.HC] — Qiushi Sun, Da Yu, Alexander Knop, Amer Sinha, Lingpeng Kong, Ben Kao, Ravi Kumar, Pritish Kamath (Google & The University of Hong Kong))
- [2]OSWorld: Benchmarking Multimodal Agents on Open-Ended Desktop Tasks(NeurIPS 2024 — Tianbao Xie et al.)
- [3]AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Mobile Agents(arXiv:2405.14573 — Christopher Rawles et al. (Google DeepMind))
- [4]WebArena: A Realistic Web Environment for Building Autonomous Language Agents(ICLR 2024 — Shuyan Zhou et al. (Carnegie Mellon University))
- [5]OS-Themis & OSReward: Multi-Modal Reward Models for Computer-Using Agents(arXiv:2603.11984 — Sun et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Glance (arXiv:2610.40454): The Generator Is Its Own Reranker — Shared Prefill Architecture, Pointer Head 256-d, Multi-Probe Packing, Eliminasi Redundansi Reranker Eksternal, dan Efisiensi Memory +0.1 GiB
Analisis arsitektural riset frontier Airun Intelligence Labs (arXiv:2610.40454, Adilet Metinov & Chingiz Arziev): Mengapa pipeline RAG konvensional mengalami pemborosan komputasi ganda dan duplikasi VRAM akibat memisahkan model reranker dengan generator, bagaimana arsitektur Glance membekali LLM generator 9B tunggal dengan decision adapter rank-16 LoRA dan pointer head 256-dimensi untuk meranking kandidat dokumen langsung dari satu shared prefill, inovasi multi-probe packing pada hybrid backbone Gated DeltaNet/Transformer, varian Glance-Activated untuk zero-copy KV-cache reuse tanpa re-prefill, rekor retrieval nDCG@10 0.741 di SciFact, lonjakan +0.045 F1 di HotpotQA, serta implementasi inferensi production-ready.
Skeleton Coding (arXiv:2610.38214): Program Structure sebagai Spesifikasi AI Coding Agents — Mengapa Behavioral Testing Gagal, Reduksi 48.4% Test Error, dan Efisiensi Biaya 26x Lipat
Analisis arsitektural riset frontier AWS Agentic AI (arXiv:2610.38214, Aditya Golatkar, Alessandro Achille, Renos Zabounidis, Vlad Sobal, Stefano Soatto): Mengapa paradigma specification-driven development berbasis pengujian perilaku semata (behavioral testing / vibe coding) mengalami kegagalan eksponensial pada coding agent, bagaimana Skeleton Coding menggabungkan struktur kode tingkat tinggi (type stubs, local contracts, global invariants) dengan behavioral specs untuk memangkas error rate hingga 48.4%, menjembatani gap model kecil 52.4% dengan penghematan biaya token 15–26x, mereduksi code erosion 24.7%, dan implementasi runtime verifier siap produksi.
EnvSched (arXiv:2610.37609): Environment-Aware Scheduling untuk Rollout-Efficient Agent Reinforcement Learning — Dual-Relation Graph, Prediksi Reward Variance, dan Rekor 48.81 Skor Qwen3-8B pada 40 Langkah GRPO
Analisis arsitektural riset frontier PKU, Tsinghua, XJTU, Samsung Research, CASIA, dan CUHK (arXiv:2610.37609, Sihan Yang, Weichen Bai, Ruichuan An, Yifan Zhang, Wentao Zhang): Mengapa penjadwalan data RL berbasis prompt individual (DPS, LEEPS) gagal saat scaling ke ribuan environment simulasi, bagaimana EnvSched memodelkan pasangan Environment-Task via Dual-Relation Graph (Within-Environment vs Cross-Environment), memprediksi reward variance historis untuk alokasi batch eksplorasi-eksploitasi, melipatgandakan efisiensi komputasi GPU 3x lipat, dan implementasi scheduler siap produksi.