DRACO 2026: Arsitektur Outcome-Blind Credit Assignment, Dynamic Per-Trajectory Rubrics, dan Closed-Form Step Advantage Reallocation pada Long-Horizon AI Agents
Analisis arsitektur sistemik riset frontier terbaru (IBM Research, arXiv:2609.04094, September 2026): Mengatasi kebuntuan RLVR pada skenario tanpa verifier programmatic (outcome-blind) dengan arsitektur DRACO. Menggabungkan Dynamic Per-Trajectory Rubrics dengan discriminative dropout dan closed-form step credit redistribution dalam GRPO—mengangkat Task Goal Completion AppWorld sebesar +15.9 poin (mencapai 85.3% TGC) melampaui pelatihan berbasis ground-truth verifier sparse, serta transfer zero-shot ke Tau-Bench.
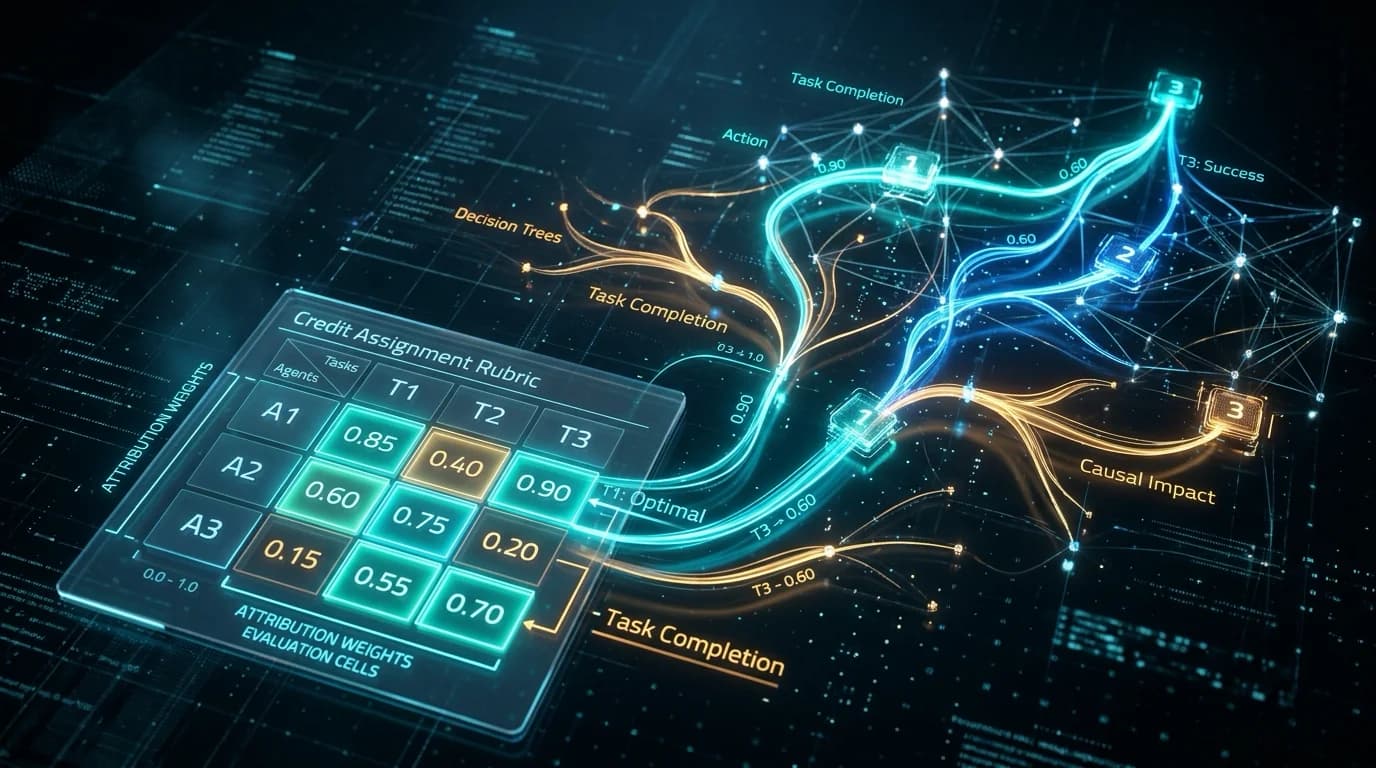
Dalam lanskap frontier Reinforcement Learning untuk autonomous tool-using agents, pendekatan RLVR (Reinforcement Learning from Verifiable Rewards) telah menjadi pilar utama di balik lompatan model penalaran matematika dan penulisan kode terisolasi. Namun, ketika model diterjunkan ke lingkungan dunia nyata—seperti riset komprehensif, orkestrasi perbankan multi-aplikasi, atau otomasi tugas enterprise yang berlangsung puluhan langkah—asumsi keberadaan sebuah program unit-test oracle otomatis runtuh. Sebagian besar ranah agen beroperasi dalam rezim outcome-blind, di mana sinyal kebenaran mutlak (ground-truth reward) mustahil diperoleh saat waktu pelatihan.
Executive Architectural Summary
Studi frontier terbaru dari tim IBM Research (arXiv:2609.04094, 3 September 2026) memperkenalkan DRACO (Distributing Rubric-based Advantage for Credit Optimization). DRACO merevolusi optimasi agen long-horizon dengan dua pilar utama: Dynamic Per-Trajectory Rubrics dengan discriminative dropout yang mengeliminasi saturasi evaluasi statis, dan Closed-Form Step Advantage Reallocation yang memetakan sinyal keuntungan grup (GRPO) ke tingkat langkah individual berdasarkan sitasi rubrik secara analitis tanpa modul neural tambahan. Pada benchmark AppWorld, DRACO meraih lonjakan +15.9 poin TGC atas baseline model dasar (mencapai 85.3% TGC) dan +5.3 poin di atas GRPO yang dilatih dengan verifier ground-truth sparse.
1. Dilema Alokasi Kredit & Kegagalan Uniform Advantage pada GRPO
Pada algoritma Group Relative Policy Optimization (GRPO; DeepSeek-AI, 2024), sebuah model kebijakan (policy model) menghasilkan sekelompok lintasan (rollout group) $\{y_1, y_2, \dots, y_G\}$ untuk sebuah instruksi tugas $x$. Setiap lintasan dievaluasi menghasilkan skalar reward tunggal $R(y_i)$, yang kemudian distandarisasi di tingkat grup menjadi skalar keuntungan (advantage):
Dalam implementasi GRPO standar, skalar $A(y_i)$ ini dikalikan secara seragam (uniform advantage) ke setiap token yang dipancarkan oleh lintasan tersebut:
Pemberian kredit seragam ini menyimpan kelemahan fatal pada agen long-horizon yang menempuh puluhan langkah interaksi alat (tool-calling steps):
- False Credit pada Trajektori Menang (Winners): Sebuah lintasan yang berhasil sering kali memuat langkah-langkah redundan, loop API yang tidak perlu, atau panggilan alat acak yang kebetulan berhasil karena keberuntungan. Dengan bobot seragam $A(y) > 0$, langkah-langkah buruk ini ikut diperkuat (reinforced).
- Unfair Blame pada Trajektori Kalah (Losers): Sebaliknya, pada lintasan yang gagal, agen mungkin mengeksekusi 18 langkah dekomposisi dan eksekusi SQL yang sempurna, namun gagal di langkah ke-19 karena kesalahan kecil pada parsing format tanggal. Dengan $A(y) < 0$, GRPO standar menekan seluruh 19 langkah secara identik, merusak penalaran valid yang telah dipelajari model.
- Saturasi Rubrik Statis: Jika menggunakan rubrik statis yang telah ditentukan sebelumnya, kriteria penilaian akan cepat mengalami saturasi (mencapai batas atas ~80% dalam 20 step pertama), sehingga gradien kehilangan daya beda (loss of variance).
2. Arsitektur Dynamic Per-Trajectory Rubrics & Discriminative Dropout
Untuk memecahkan masalah evaluasi kaku pada domain tanpa verifier, DRACO mengadopsi mekanisme sintesis rubrik dinamis tiga tahap yang digerakkan oleh model evaluator (frozen judge):
Instruksi Awal
Judge mengekstraksi kriteria fungsional dasar murni dari instruksi tugas $x$, mendefinisikan batas kontrak input-output.
Eksplorasi Lintas Jalur
Judge memeriksa setiap lintasan yang dihasilkan model kebijakan, memperluas rubrik dengan sub-goal spesifik dan mode kegagalan nyata yang muncul.
Unifikasi Tanpa Redundansi
Kriteria disatukan dengan protokol Mutually Exclusive and Collectively Exhaustive (MECE) agar satu kesalahan tidak dihitung dua kali.
Inovasi krusial DRACO terletak pada Discriminative Dropout: sebuah kriteria hanya dipertahankan apabila terdapat minimal satu anggota rollout group yang gagal memenuhi kriteria tersebut. Kriteria yang dilalui dengan sempurna oleh semua rollout langsung dipangkas, memastikan bahwa fungsi reward hanya mengukur batas variansi aktif yang menantang kebijakan model saat ini.
Reward lintasan dihitung secara outcome-blind berdasarkan fraksi kelulusan kriteria yang berlaku (applicable):
3. Closed-Form Step Advantage Reallocation: Formulasi & Teorema Konservasi
Ketika judge mengevaluasi lintasan terhadap kriteria rubrik yang lolos discriminative dropout, judge wajib mencantumkan sitasi langkah (step citations)—yaitu nomor blok kode/langkah alat $t$ yang bertanggung jawab atas status pass atau fail kriteria tersebut.
DRACO tidak melatih modul neural baru untuk mendistribusikan advantage (yang rawan reward hacking dan overhead latensi), melainkan menerapkan aturan analitis tertutup (closed-form redistribution):
Langkah 1: Mengukur Kualitas Langkah ($q_t$)
Jika $p_t$ dan $f_t$ adalah jumlah kriteria lulus dan gagal yang menyitir langkah $t$, maka kualitas langkah didefinisikan sebagai:
Untuk langkah yang tidak disitir oleh kriteria manapun, langkah tersebut mewarisi nilai rata-rata kualitas $\bar{q}$ dari seluruh langkah yang disitir.
Langkah 2: Menghitung Bobot Pelestari Tanda ($w_t$)
Arah dorongan gradien keseluruhan lintasan ditentukan oleh tanda $A(y)$. Untuk memastikan langkah yang gagal pada trajektori menang tidak diperkuat, dan sebaliknya langkah yang bagus pada trajektori kalah tidak ditekan, DRACO merumuskan bobot:
Langkah 3: Menghitung Advantage Langkah ($A_t$) & Total-Push Conservation
Setiap token di dalam langkah $t$ menerima advantage teralokasi $A_t$ yang sama, dengan menormalisasi panjang token $n_t$ agar setiap langkah dinilai berdasarkan kualitas keputusannya, bukan jumlah kata atau panjang outputnya (length independence):
Mengalikan $A_t$ dengan jumlah token langkah $n_t$ dan menjumlahkannya di seluruh langkah membuktikan sifat konservasi DRACO: $$\sum_t n_t A_t = \sum_t n_t \left( \frac{N \cdot w_t}{\sum_j n_j w_j} A(y) \right) = \frac{N \cdot A(y)}{\sum_j n_j w_j} \sum_t n_t w_t = N \cdot A(y)$$ Aturan alokasi DRACO tidak pernah menambah atau mengurangi magnitudo gradien total sebuah lintasan; ia murni memindahkan bobot pengaruh ke langkah-langkah yang berhak menerimanya secara analitis.
4. Hasil Evaluasi Empiris: AppWorld, Tau-Bench, dan Frontier Models
Eksperimen dilakukan dengan melatih adapter LoRA pada model dasar Qwen3.6-27B dan Qwen2.5-32B-Instruct menggunakan 8 GPU NVIDIA H100 pada dataset AppWorld (90 tugas pelatihan). Evaluasi dilakukan pada set uji AppWorld (test-normal dan test-challenge) serta transfer zero-shot ke Tau-Bench Banking:
| Model & Konfigurasi Pelatihan | AppWorld TGC (%) | AppWorld SGC (%) | Tau-Bench SR (%) | Biaya Eval ($/Run) |
|---|---|---|---|---|
| Qwen3.6-27B (Untrained Base) | 69.4% | 41.1% | 15.8% | $10.77 |
| GRPO + Sparse Outcome Reward (Unit-Tests) | 80.0% | 59.3% | 17.6% | $9.45 |
| DRACO w/o Dynamic & Credit (Static Rubric) | 81.1% | 59.9% | 19.4% | $9.12 |
| DRACO w/o Credit (Dynamic Only) | 82.1% | 64.9% | 19.7% | $8.85 |
| DRACO (Dynamic Rubrics + Step Credit) | 85.3% (+15.9) | 70.6% (+29.5) | 20.4% (+5.3) | $8.27 |
| DRACO (Self-Judge Qwen3.6-27B w/ k=3) | 81.1% | 62.7% | 21.1% | $8.50 |
| Claude Sonnet 4.6 (Zero-Shot Reference) | 89.9% | 85.7% | 24.5% | $18.81 |
| Claude Opus 4.7 (Zero-Shot Reference) | 93.5% | 91.1% | 28.0% | $32.71 |
Temuan penting dari data empiris di atas meliputi:
- Mengalahkan Pelatihan Berbasis Verifier: DRACO meraih 85.3% TGC, unggul +5.3 poin dibandingkan model yang dilatih menggunakan reward ground-truth verifier langsung (80.0%). Hal ini membuktikan bahwa sinyal atribusi proses multi-kriteria memberikan gradien yang jauh lebih padat dan informatif daripada sinyal biner terminal (lulus/gagal).
- Ledakan Scenario Goal Completion (SGC): Pada metrik SGC di mana semua tugas dalam satu skenario terintegrasi wajib selesai tanpa galat, DRACO melonjak dari 41.1% ke 70.6% (+29.5 poin).
- Efisiensi Biaya Signifikan: Model Qwen3.6-27B yang dilatih dengan DRACO mendekati performa model frontier komersial (Claude Sonnet 4.6) dengan biaya evaluasi hanya $8.27 per pengujian penuh, dibandingkan $18.81 pada Claude Sonnet 4.6 dan $32.71 pada Claude Opus 4.7.
- Viabilitas Self-Judge: Mengganti frontier judge (GPT-5.4) dengan model kebijakan itu sendiri (Qwen3.6-27B) menggunakan aturan konsensus k=3 unanimity voting tetap menghasilkan 81.1% TGC—menghilangkan ketergantungan pada API komersial eksternal selama loop pelatihan RL berlangsung.
5. Implementasi Referensi Kernel: DracoCreditEngine (TypeScript)
Berikut adalah implementasi referensi lengkap kernel DRACO dalam TypeScript yang mengkapsulasi alur Discriminative Dropout, Outcome-Blind Reward Calculation, dan Closed-Form Step Advantage Reallocation:
// DRACO: Distributing Rubric-based Advantage for Credit Optimization Kernel
// Spesifikasi Arsitektur Berdasarkan IBM Research (arXiv:2609.04094, September 2026)
// Menghitung Closed-Form Step Credit Reallocation dalam GRPO Tanpa Verifier Programmatic

export interface StepCitation {
  stepIndex: number;
  tokenCount: number;
}

export interface RubricCriterion {
  id: string;
  description: string;
  isPassed: boolean;
  isApplicable: boolean;
  citedSteps: number[]; // Indeks langkah yang bertanggung jawab atas vonis kriteria
}

export interface TrajectoryRollout {
  trajectoryId: string;
  totalTokens: number;
  steps: Array<{
    stepIndex: number;
    tokenCount: number;
    toolName: string;
    actionPayload: string;
  }>;
  rubrics: RubricCriterion[];
  rawReward?: number;
  trajectoryAdvantage?: number; // Advantage GRPO standar A(y)
}

export interface StepAdvantageResult {
  stepIndex: number;
  stepQuality: number; // q_t: rasio kelulusan kriteria yang menyitir langkah t
  signPreservingWeight: number; // w_t: bobot pelestari arah gradien
  stepAdvantage: number; // A_t: advantage terdiferensiasi per token pada langkah t
  tokenCount: number;
}

export class DracoCreditEngine {
  /**
   * 1. Discriminative Dropout: Menghapus kriteria yang dilalui (pass) oleh seluruh anggota rollout group.
   * Kriteria yang tidak memiliki variansi kegagalan tidak memberikan sinyal pembeda pada GRPO.
   */
  public applyDiscriminativeDropout(group: TrajectoryRollout[]): string[] {
    const failedCriteriaIds = new Set();

    for (const rollout of group) {
      for (const rubric of rollout.rubrics) {
        if (rubric.isApplicable && !rubric.isPassed) {
          failedCriteriaIds.add(rubric.id);
        }
      }
    }

    // Hanya kriteria yang gagal pada minimal 1 anggota kelompok yang dipertahankan
    return Array.from(failedCriteriaIds);
  }

  /**
   * 2. Menghitung Nilai Reward Outcome-Blind:
   * R(y) = P / (P + F) dinormalisasi terhadap kriteria yang applicable.
   */
  public calculateTrajectoryReward(rollout: TrajectoryRollout, activeCriteriaIds: Set): number {
    let passedCount = 0;
    let failedCount = 0;

    for (const rubric of rollout.rubrics) {
      if (!activeCriteriaIds.has(rubric.id) || !rubric.isApplicable) continue;
      if (rubric.isPassed) {
        passedCount++;
      } else {
        failedCount++;
      }
    }

    const totalDecisions = passedCount + failedCount;
    return totalDecisions === 0 ? 0.5 : passedCount / totalDecisions;
  }

  /**
   * 3. Closed-Form Step Advantage Reallocation:
   * Memetakan A(y) menjadi A_t per langkah dengan menjamin Total-Push Conservation:
   * sum_{t} (n_t * A_t) = N * A(y)
   */
  public reallocateStepAdvantage(
    rollout: TrajectoryRollout,
    trajectoryAdvantage: number,
    activeCriteriaIds: Set
  ): StepAdvantageResult[] {
    const numSteps = rollout.steps.length;
    const totalStepTokens = rollout.steps.reduce((acc, s) => acc + s.tokenCount, 0);

    // Hitung pass (p_t) dan fail (f_t) per langkah t
    const stepPassCount = new Map();
    const stepFailCount = new Map();

    for (const rubric of rollout.rubrics) {
      if (!activeCriteriaIds.has(rubric.id) || !rubric.isApplicable) continue;

      for (const stepIdx of rubric.citedSteps) {
        if (rubric.isPassed) {
          stepPassCount.set(stepIdx, (stepPassCount.get(stepIdx) || 0) + 1);
        } else {
          stepFailCount.set(stepIdx, (stepFailCount.get(stepIdx) || 0) + 1);
        }
      }
    }

    // Hitung step quality q_t
    const stepQualities: number[] = [];
    let sumCitedQualities = 0;
    let citedStepsCount = 0;

    for (let t = 0; t < numSteps; t++) {
      const p = stepPassCount.get(t) || 0;
      const f = stepFailCount.get(t) || 0;
      if (p + f > 0) {
        const q = p / (p + f);
        stepQualities.push(q);
        sumCitedQualities += q;
        citedStepsCount++;
      } else {
        stepQualities.push(-1); // Penanda langkah yang tidak disitir
      }
    }

    // Default q_bar untuk langkah yang tidak disitir oleh kriteria manapun
    const qBar = citedStepsCount > 0 ? sumCitedQualities / citedStepsCount : 0.5;

    // Hitung bobot pelestari tanda (sign-preserving weights w_t)
    const isWinner = trajectoryAdvantage >= 0;
    const stepWeights: number[] = [];

    for (let t = 0; t < numSteps; t++) {
      const q = stepQualities[t] === -1 ? qBar : stepQualities[t];
      // Jika winner trajectory (A >= 0): w_t = 2 * q_t
      // Jika loser trajectory (A < 0):  w_t = 2 * (1 - q_t)
      const w = isWinner ? 2 * q : 2 * (1 - q);
      stepWeights.push(w);
    }

    // Hitung denominator tertimbang token: sum_j (n_j * w_j)
    let weightedTokenSum = 0;
    for (let j = 0; j < numSteps; j++) {
      weightedTokenSum += rollout.steps[j].tokenCount * stepWeights[j];
    }

    // Jika seluruh bobot 0 atau tidak ada sitasi, fallback ke GRPO standar (A_t = A(y))
    const results: StepAdvantageResult[] = [];
    for (let t = 0; t < numSteps; t++) {
      const n_t = rollout.steps[t].tokenCount;
      const w_t = stepWeights[t];
      const q_t = stepQualities[t] === -1 ? qBar : stepQualities[t];

      let a_t = trajectoryAdvantage;
      if (weightedTokenSum > 0) {
        // Rumus DRACO Eq. (6): A_t = (N * w_t / sum_j(n_j * w_j)) * A(y)
        a_t = (totalStepTokens * w_t / weightedTokenSum) * trajectoryAdvantage;
      }

      results.push({
        stepIndex: t,
        stepQuality: Number(q_t.toFixed(4)),
        signPreservingWeight: Number(w_t.toFixed(4)),
        stepAdvantage: Number(a_t.toFixed(6)),
        tokenCount: n_t,
      });
    }

    return results;
  }
}
6. Panduan Implementasi untuk Tim Rekayasa AI Enterprise
Bagi arsitek sistem dan praktisi AI yang membangun agen otonom di ranah produksi yang tidak memiliki unit-test verifier, arsitektur DRACO memberikan 4 prinsip esensial:
Referensi & Sumber Terverifikasi
- [1]DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training(arXiv:2609.04094 [cs.AI, cs.LG, cs.SE] — Shubham Gandhi, Saurabh Goyal, Kiran Kate, Yara Rizk (IBM Research))
- [2]DRACO Official Open-Source Implementation & Verification Harness(IBM Research GitHub Organization (IBM/draco))
- [3]DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO Formulation)(arXiv:2402.03300 [cs.CL, cs.AI] — DeepSeek-AI)
- [4]AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents(Association for Computational Linguistics (ACL 2024))
- [5]Tau-Bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains(Sierra Research / arXiv:2406.12045 [cs.AI])
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.