DualPath: Memecahkan Storage Bandwidth Bottleneck pada Agentic Multi-Turn LLM Inference 2026
Menganalisis arsitektur DualPath (Peking University & DeepSeek-AI) yang memecahkan bottleneck storage I/O bandwidth pada pemuatan KV-Cache untuk inferensi AI Agent multi-turn dengan peningkatan throughput serving hingga 1.96x.
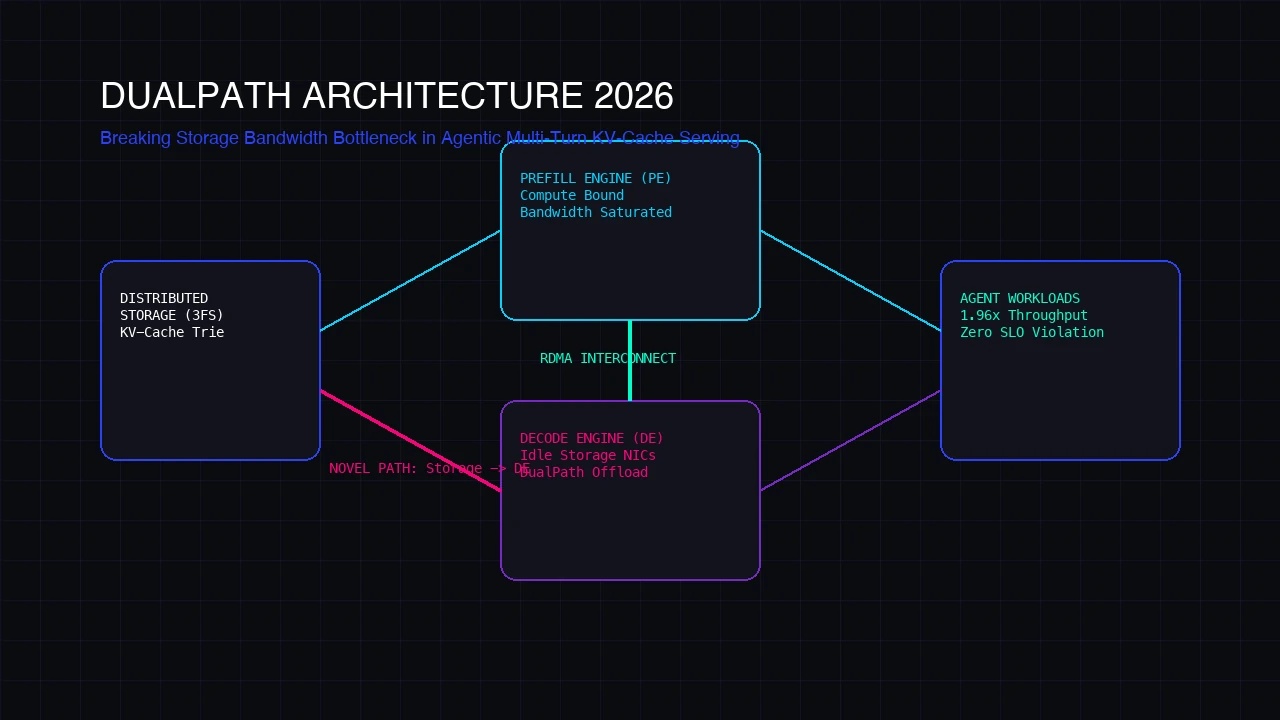
Dalam lanskap rekayasa kecerdasan buatan 2026, paradigma pemanfaatan Large Language Models (LLM) telah bergeser secara fundamental: dari sistem interaksi single-turn chatbot menjadi sistem otonom berbasis agent (agentic LLM systems). Agen otonom modern beroperasi dalam sesi interaksi multi-langkah berhorizon panjang, mengeksekusi puluhan hingga ratusan panggilan alat (tool calls), inspeksi browser, dan perbaikan kode. Konteks yang terakumulasi secara masif ini mengubah profil beban komputasi AI: inferensi tidak lagi didominasi oleh beban kalkulasi FLOPS, melainkan tertahan oleh Storage I/O Bottleneck pada pemuatan Key-Value Cache (KV-Cache).
Executive Architectural Summary & Core Finding
Pada arsitektur Prefill-Decoding Disaggregated (PD-disaggregated) konvensional, seluruh KV-Cache historis dimuat secara eksklusif oleh Prefill Engines (PE) langsung dari remote distributed storage. Hal ini memicu ketimpangan asimetris parah: Storage NIC pada Prefill Engines mengalami saturasi bandwidth 100%, sementara antarmuka jaringan storage pada Decoding Engines (DE) menganggur (idle). Riset terobosan DualPath (arXiv:2602.21548, 2026) dari peneliti Peking University, Tsinghua University, dan DeepSeek-AI memecahkan kemacetan ini melalui arsitektur dual-path KV-Cache loading. Memanfaatkan bandwidth remote storage milik Decoding Engine yang menganggur lalu mentransfernya ke Prefill Engine via RDMA over compute network meningkatkan throughput inferensi offline hingga 1.87x dan throughput serving online sebesar 1.96x tanpa melanggar SLO (Service Level Objective).
1. Anomali Beban Kerja Agentic: Mengapa KV-Cache Menjadi I/O Bound
Beban kerja inferensi agentic memiliki karakteristik yang sangat kontras jika dibandingkan dengan percakapan chat konvensional:
- Multi-Turn, Short-Append Trajectory: Pada setiap langkah pengambilan keputusan (misal: eksekusi perintah terminal atau inspeksi DOM), agen hanya menambahkan beberapa ratus token observasi baru, namun membawa puluhan ribu token riwayat percakapan sebelumnya.
- Ekstremnya Rasio KV-Cache Hit (≥ 95%): Karena konteks masa lalu bersifat deterministik, sistem inferensi modern memanfaatkan Prefix Caching. Prefill engine tidak menghitung ulang seluruh token dari awal, melainkan memuat blok KV-Cache yang sudah dihitung dari storage terdistribusi (seperti 3FS).
- Pergeseran dari Compute-Bound ke Storage-Bandwidth-Bound: Waktu prefill untuk prompt baru kini didominasi oleh waktu yang dibutuhkan kartu jaringan (NIC) untuk membaca tensor KV-Cache dari remote disk, bukan waktu komputasi GPU Tensor Core.
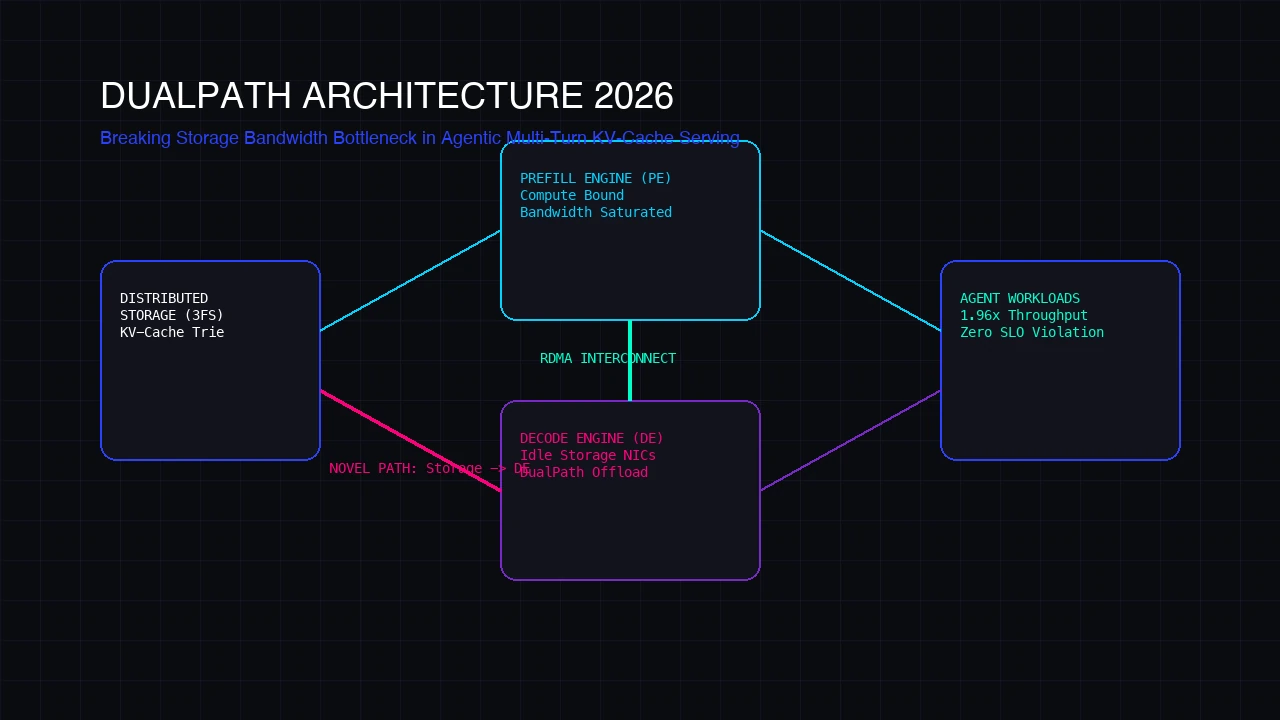
2. Asimetri Jaringan pada Arsitektur Prefill-Decoding Disaggregated
Untuk memaksimalkan efisiensi perangkat keras, industri komputasi AI memisahkan kluster menjadi dua entitas terpisah:
| Komponen Cluster | Karakteristik Komputasi | Pola Utilisasi Storage NIC | Status Bottleneck |
|---|---|---|---|
| Prefill Engine (PE) | Compute-intensive (Batch Gemm) | 100% Saturation (Membaca KV riwayat) | Critical Bottleneck |
| Decoding Engine (DE) | Memory-bandwidth-intensive (Token-by-token) | ≤ 5% Saturation (Hanya flush token baru) | Underutilized NIC Capacity |
Karena decoding engine menghasilkan token satu per satu, konsumsi bandwidth storage untuk menyimpan KV-Cache baru sangat kecil (hanya beberapa megabyte per detik per node). Sebaliknya, prefill engine harus menarik gigabyte tensor KV-Cache dalam hitungan milidetik agar TTFT (Time-to-First-Token) tetap rendah. Inilah ketimpangan fundamental yang diselesaikan oleh DualPath.
3. Arsitektur DualPath: Dual-Path Loading & Global Load Scheduler
Alih-alih memaksa seluruh pembacaan KV-Cache melewati antarmuka storage PE, DualPath membuka jalur sekunder:
- Storage-to-Decode Path: KV-Cache dari distributed storage (3FS/Lustre) dibaca oleh Decoding Engines yang memiliki bandwidth storage NIC melimpah.
- Zero-Copy RDMA Forwarding: DE langsung mentransfer blok KV-Cache ke PE menggunakan Compute Network (RDMA over Converged Ethernet / InfiniBand). Karena compute network pada kluster AI umumnya memiliki bandwidth jauh lebih masif (400Gbps - 800Gbps per GPU), transfer ini tidak menimbulkan kemacetan.
- Interference-Free Execution: DualPath menjadwalkan transfer RDMA di sela-sela iterasi decoding langkah model, memastikan transfer KV-Cache tidak menginterupsi latensi kritis pembuatan token real-time.
- Full-Block & Layer-Block Storage Layout: Menggunakan struktur Trie terdistribusi dengan format blok terpadu sehingga memory conversion tidak memerlukan overhead rekonstruksi CPU/GPU tambahan.
Implementasi Type-Safe: DualPath Routing Engine
Berikut adalah spesifikasi abstraksi dispatcher DualPath yang mengevaluasi utilisasi jaringan cluster secara dinamis:
// DualPath Dynamic KV-Cache Load Balancing & Asymmetric Route Dispatcher
export interface InferenceSessionContext {
  sessionId: string;
  turnId: number;
  kvCacheBlockIds: string[];
  totalTokens: number;
  prefillEngineBandwidthUtilization: number; // 0.0 - 1.0
  decodeEngineStorageNicIdleRate: number;    // 0.0 - 1.0
}

export interface DualPathRoutingDecision {
  route: 'DIRECT_STORAGE_TO_PREFILL' | 'DUALPATH_STORAGE_TO_DECODE_RDMA';
  estimatedTransferLatencyMs: number;
  targetDecodeNode?: string;
  rdmaChannelAllocated: boolean;
}

export class DualPathDispatcher {
  private peBandwidthThreshold = 0.85; // Ambang batas saturasi NIC Prefill

  // Evaluasi jalur pemuatan KV-Cache berdasarkan kondisi beban storage I/O real-time
  public evaluateOptimalRoute(context: InferenceSessionContext): DualPathRoutingDecision {
    const isPrefillSaturated = context.prefillEngineBandwidthUtilization > this.peBandwidthThreshold;
    const hasDecodeCapacity = context.decodeEngineStorageNicIdleRate > 0.40;

    // Jika Prefill NIC jenuh namun Decoding NIC menganggur, alihkan I/O ke jalur Decode + RDMA
    if (isPrefillSaturated && hasDecodeCapacity) {
      return {
        route: 'DUALPATH_STORAGE_TO_DECODE_RDMA',
        estimatedTransferLatencyMs: (context.totalTokens * 0.0012) + 0.45, // Zero-copy RDMA compute network
        targetDecodeNode: `de-node-${Math.floor(Math.random() * 8)}`,
        rdmaChannelAllocated: true,
      };
    }

    // Default fallback: Pemuatan langsung Storage-to-Prefill konvensional
    return {
      route: 'DIRECT_STORAGE_TO_PREFILL',
      estimatedTransferLatencyMs: context.totalTokens * 0.0038, // Terkendala bottleneck storage NIC
      rdmaChannelAllocated: false,
    };
  }
}
4. Evaluasi Kinerja & Hasil Benchmark Empiris
Dalam pengujian ekstensif menggunakan model frontier berskala besar (DeepSeek-V3, Qwen-2.5-72B, dan Qwen-32B) pada kluster produksi dengan ribuan sesi agen otonom:
5. Implikasi bagi Infrastruktur AI Enterprise Masa Depan
Peralihan menuju era autonomous agent menuntut rekayasa ulang pada lapisan inferensi sistem. Mengasumsikan bahwa performa LLM semata-mata ditentukan oleh jumlah FLOPs GPU adalah kekeliruan besar pada beban kerja interaktif multi-turn. Arsitektur DualPath membuktikan bahwa orkestrasi asimetris antara storage NIC dan compute RDMA mampu melipatgandakan kapasitas serving tanpa memerlukan belanja modal (CapEx) perangkat keras komputasi baru.
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.