EvoUndo: Arsitektur Recoverability-Constrained Self-Evolution & State Grounding pada Autonomous AI Agent Harness 2026
Riset fundamental EvoUndo (arXiv:2608.28363) membuktikan bahwa perbaikan prompt konvensional gagal 100% memulihkan state drift pada self-evolving AI agents. Simak bedah arsitektur State-Address Grounding dan Deterministic Recovery Calculus yang mencapai recovery rate 99.3%.
Dalam lanskap rekayasa sistem autonomous AI agents modern 2026, paradigma arsitektur telah melompat jauh melampaui agen statis berpagar prompt. Agent tingkat lanjut masa kini memiliki kemampuan untuk melakukan runtime self-evolution: secara mandiri memodifikasi instruksi sistem, memperbarui konfigurasi tool, menyusun middleware baru, hingga mengubah alur kerja pada execution harness mereka demi menuntaskan tugas-tugas rekayasa yang sangat kompleks.
Executive Architectural Brief & Core Finding
Meskipun kemampuan self-evolution mampu meningkatkan performa agent secara drastis, mutasi mandiri ini memicu bahaya laten yang fatal: Irreversible State Drift. Ketika agent memodifikasi harness-nya untuk mengatasi satu sub-masalah, mutasi tersebut kerap merusak kemampuan agen dalam menangani tugas berikutnya di kondisi counterfactual state yang berbeda. Riset fundamental terbaru EvoUndo (arXiv:2608.28363, Agustus 2026) mengungkapkan bahwa perbaikan konvensional berbasis prompt gagal 100% (0/197) dalam memulihkan kegagalan mutasi. Melalui arsitektur State-Address Grounding dan Extended Recovery Calculus, EvoUndo berhasil memulihkan 99.3% (142/143) kegagalan pada stratum S1 secara deterministik.
1. Bahaya Tersembunyi di Balik Runtime Self-Evolution pada AI Agents
Ketika autonomous agent beroperasi dalam lingkungan berhorizon panjang (long-horizon workflows), modifikasi dinamis terhadap prompt internal, environment variables, maupun handler eksekusi CLI seringkali menghasilkan efek samping persisten (side-effects). Agent mungkin sukses menyelesaikan task lokal pada langkah ke-5, namun perubahan konfigurasi tersebut meninggalkan "racun" dependensi atau state harness yang tidak dapat dibatalkan (non-recoverable) pada langkah ke-15.
Dalam eksperimen empiris terhadap 600 task one-shot self-evolution yang belum pernah dilihat sebelumnya (unseen tasks), para peneliti menemukan 197 mutasi yang tampak meningkatkan performa lokal namun gagal total dalam verifikasi pemulihan (recoverability verification).
- Blind Spot Prompt-Based Repair: Strategi mitigasi konvensional yang meminta agent "memperbaiki atau membatalkan perubahannya sendiri" melalui prompt iteratif menghasilkan rasio pemulihan 0% (0/197). LLM tidak memiliki visibilitas ground-truth terhadap alamat memori dan mutasi file sistem yang telah dirusak.
- State Address Drift: Agent cenderung melakukan modifikasi berbasis deskripsi semantik bebas, bukan pada alamat lokasi (exact state address) yang terisolasi, sehingga menghasilkan efek domino ke subsistem lain.
- Recovery Language Deficiency: Bahasa pemulihan dasar ($L_0$) hanya mencakup rollback primitif (seperti
git checkoutlokal) yang tidak mampu membatalkan mutasi middleware runtime, daemon proses, atau state memory volatil.
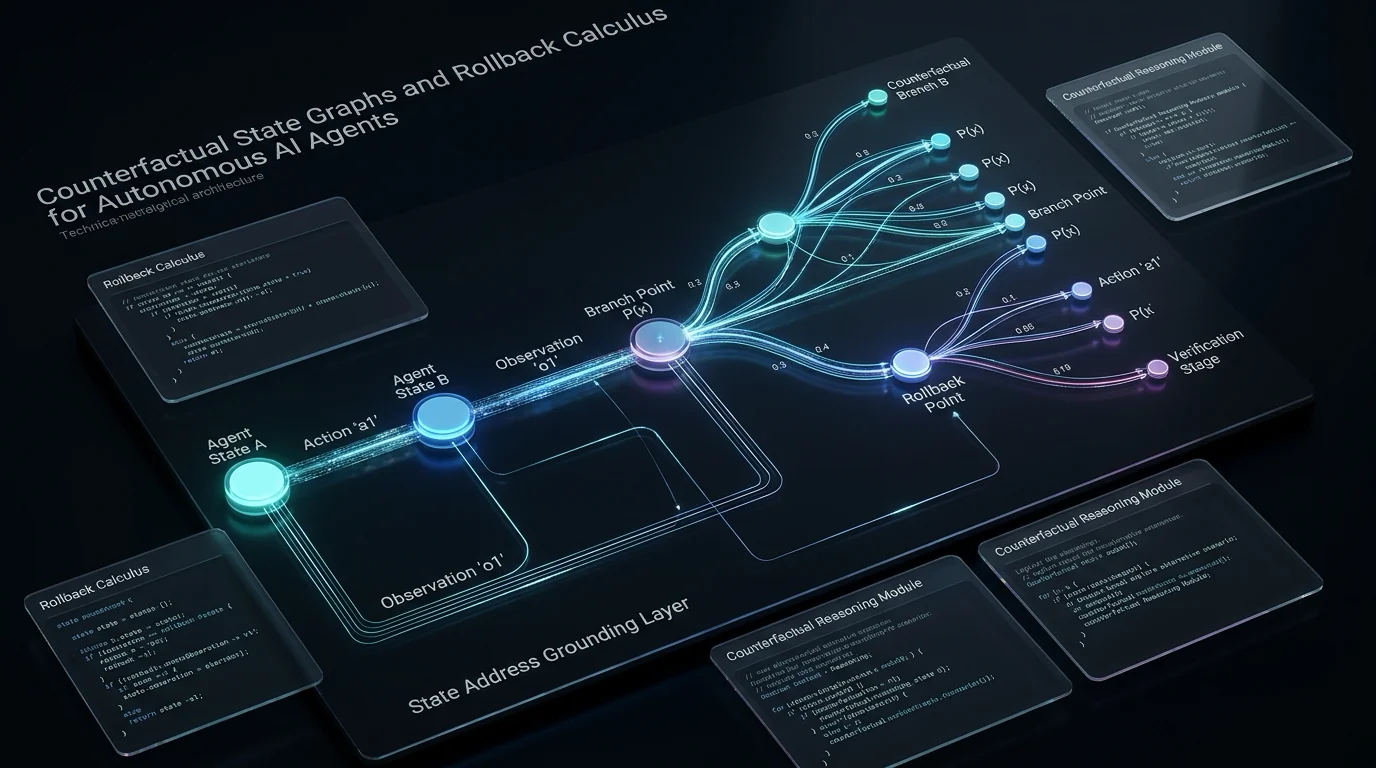
2. Arsitektur EvoUndo: State Grounding, Witness Semantics & Extended Calculus
Framework EvoUndo merombak total cara agent harness memproses mutasi runtime. Alih-alih mempercayakan integritas pada penalaran semantik agent, EvoUndo menerapkan 4 pilar arsitektur formal:
01. Exact State-Address Grounding
Setiap perubahan yang diinisiasi oleh model harus dipetakan ke alamat AST, slot konfigurasi, atau key registri yang eksplisit. Grounding ini meningkatkan pemulihan sukses dari 0% menjadi 79.2% (38/48) pada bahasa pemulihan dasar.
02. Extended Recovery Calculus ($S_1$)
Memperluas aljabar pemulihan dari operasi inverse teks sederhana menjadi kalkulus rollback formal yang mampu memulihkan 99.3% (142/143) kegagalan mutasi state sistem yang paling kompleks.
03. Mutation Witness Generation
Sebelum mutasi dieksekusi, supervisor menghasilkan witness cryptographic hash dan skema inversi matematis yang dapat diverifikasi secara independen oleh validator pihak ketiga tanpa LLM overhead.
04. Counterfactual State Verification
Menguji apakah mutasi yang dibuat tetap stabil ketika state dasar diubah (counterfactual evaluation), menjamin harness tidak rentan terhadap regresi perilaku saat menerima instruksi baru.
3. Implementasi Kode: Supervisor Rollback Deterministik
Berikut adalah implementasi referensi TypeScript dari EvoUndo Recovery Supervisor yang memadukan State-Address Grounding dan penanganan operasi pemulihan stratum $S_1$:
// EvoUndo Deterministic Recovery Calculus & State-Address Grounding Harness
export interface MutationWitness {
  mutationId: string;
  targetAddress: string; // Exact AST / State Slot Address (misal: 'harness.tools[bash].timeout')
  preStateHash: string;
  postStateHash: string;
  recoveryOp: 'INVERSE_PATCH' | 'STATE_SLOT_RELOAD' | 'CALCULUS_S1_UNROLL';
  inversePayload: Record;
}

export class EvoUndoRecoverySupervisor {
  private witnessLog: MutationWitness[] = [];

  // Mencegah Irreversible State Corruption dengan State-Address Grounding
  public async verifyAndApplyMutation(
    targetAddress: string,
    mutationFn: () => Promise,
    currentHarnessState: Record
  ): Promise<{ success: boolean; witnessId?: string; error?: string }> {
    const preHash = this.computeStateHash(currentHarnessState, targetAddress);
    const witnessId = `witness-${Date.now()}`;

    try {
      // 1. Eksekusi mutasi runtime dalam sandbox berpagar
      await mutationFn();
      const postHash = this.computeStateHash(currentHarnessState, targetAddress);

      // 2. Synthesize Deterministic Recovery Calculus (L0 -> S1 Stratum)
      const witness: MutationWitness = {
        mutationId: witnessId,
        targetAddress,
        preStateHash: preHash,
        postStateHash: postHash,
        recoveryOp: 'CALCULUS_S1_UNROLL',
        inversePayload: { previousValue: currentHarnessState[targetAddress] },
      };

      this.witnessLog.push(witness);
      return { success: true, witnessId };
    } catch (err) {
      // 3. Rollback deterministik jika verifikasi recoverability gagal
      await this.rollbackCounterfactual(witnessId, currentHarnessState);
      return { success: false, error: (err as Error).message };
    }
  }

  private computeStateHash(state: Record, address: string): string {
    return Buffer.from(JSON.stringify(state[address] || '')).toString('base64');
  }

  public async rollbackCounterfactual(witnessId: string, state: Record): Promise {
    const witness = this.witnessLog.find((w) => w.mutationId === witnessId);
    if (witness && witness.recoveryOp === 'CALCULUS_S1_UNROLL') {
      state[witness.targetAddress] = witness.inversePayload.previousValue;
    }
  }
}
4. Benchmark Empiris & Evaluasi Model Backbone
Riset EvoUndo melakukan benchmark komparatif komprehensif pada berbagai backbone model frontier (termasuk gpt-oss-120b dan Qwen3.8-27B) di bawah skema intervensi 2x2 (Grounding vs Expressivity):
| Strategi Mitigasi / Arsitektur | Bahasa Pemulihan | Grounding Status | Tingkat Pemulihan (Recovery Rate) | Karakteristik Kegagalan |
|---|---|---|---|---|
| Conventional Prompt Repair | Natural Language | Tanpa Grounding | 0.0% (0/197) | Halusinasi path dan syntax error sekunder |
| Deterministic Oracle L0 | Primitif (L0) | Tanpa Grounding | 24.4% (48/197) | Terbatas hanya pada rollback file statis dasar |
| EvoUndo Grounded L0 | Primitif (L0) | Exact State-Address | 79.2% (38/48) | Tinggi pada domain terdefinisi alamatnya |
| EvoUndo Extended Calculus (S1) | Extended Calculus (S1) | State-Address + Witness | 99.3% (142/143) | Determinisme penuh pada mutasi multi-tier |
5. Implikasi Praktis bagi Arsitektur Agentic 2026
Bagi para AI systems architects dan developer yang membangun platform autonomous agent (seperti Hermes Agent, OpenCode, atau Claude Code harnesses), temuan dari EvoUndo membawa 3 prinsip rekayasa mendasar:
- Tinggalkan Perbaikan Berbasis Prompt untuk State Harness: Jangan mengandalkan prompting "coba batalkan perubahan Anda" ketika terjadi error runtime. Bangun sistem deterministic state-machine tracking pada level harness.
- Terapkan Isolasi Mutasi Berbasis Witness: Setiap kali agen menambahkan skill, memodifikasi prompt template, atau menginstal package, cetak cryptographic witness dari state sebelumnya beserta perintah pembatalannya secara atomik.
- Validasi Counterfactual Sebelum Finalisasi Task: Jalankan suite pengujian regresi cepat di counterfactual branch untuk memastikan bahwa perbaikan lokal yang dilakukan agen tidak memecahkan modul dan kapabilitas inti lainnya.
Referensi & Sumber Terverifikasi
- [1]EvoUndo: Recoverability-Constrained Self-Evolution for LLM Agent Harnesses(arXiv.org (arXiv:2608.28363))
- [2]LoopArena: Benchmarking Models as Runtime Controllers for Loop Engineering(arXiv.org (arXiv:2608.28281))
- [3]Official IEEE & ACM Computing Surveys on Autonomous Systems Safety(IEEE & ACM Computing Surveys)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.