Gemini 4 Argon: Terobosan Frontier AI Google DeepMind dengan 1M Output Tokens, Deep Reasoning, dan Rekapitulasi Benchmark Melawan Claude Opus 5.5 & GPT-6 Astra
Bedah arsitektur dan kapabilitas resmi Google Gemini 4 Argon: Menghadirkan galeri grafik benchmark asli dari Google DeepMind (DeepSWE 77.9%, Vals Index, Harvey Legal Agent, Finance, dan AutomationBench), kapasitas 1M output tokens, perbandingan performa melawan Claude Opus 5.5 & GPT-6 Astra, serta analisa harga API.
Pada tanggal 30 September 2026, Google DeepMind secara resmi mengumumkan lini model frontier generasi terbarunya: Gemini 4 Argon. Didesain dari dasar untuk menangani penalaran mendalam jangka panjang (sustained deep reasoning & long-horizon workflows), model ini mendobrak batas industri dengan menghadirkan kapasitas 1 Juta Output Token dalam satu giliran inferensi, efisiensi biaya agresif $2/$10 per 1M token, serta keunggulan di 13 dari 19 tolok ukur benchmark melawan Claude Opus 5.5 dan GPT-6 Astra.
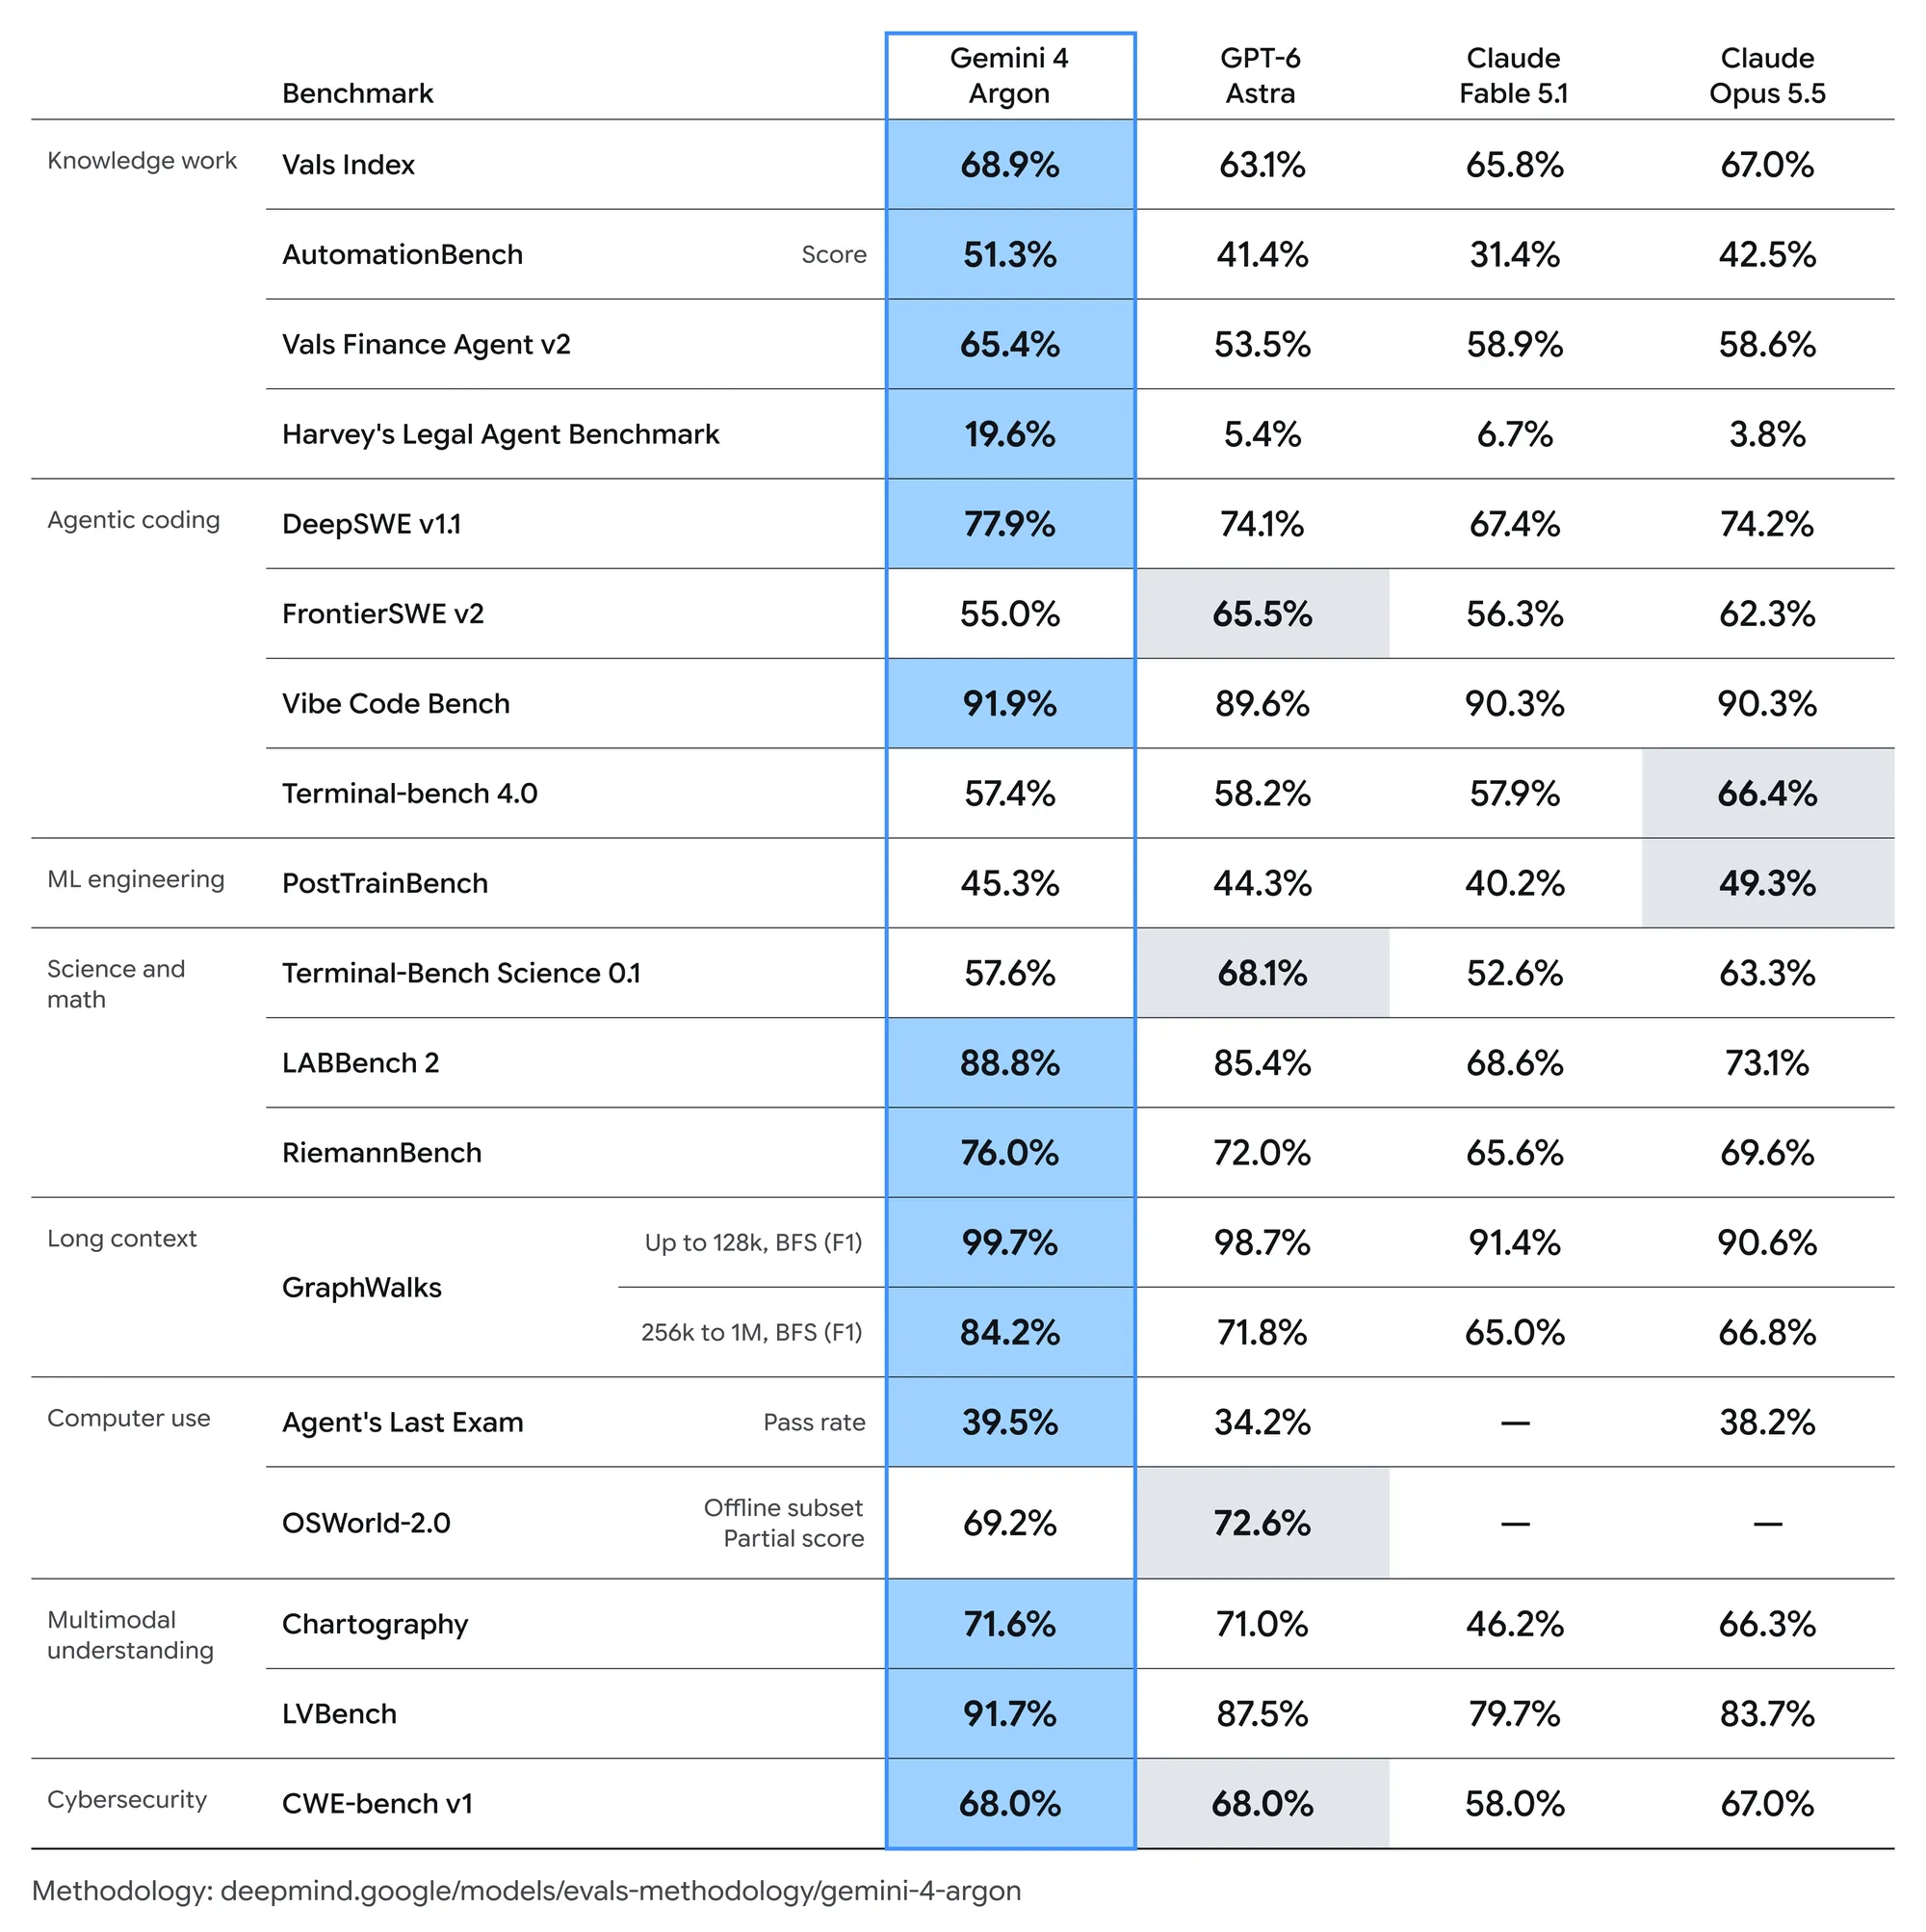
Gambar 1: Matriks Benchmark Resmi 19 Kategori Google DeepMind yang membandingkan Gemini 4 Argon secara langsung dengan GPT-6 Astra, Claude Fable 5.1, dan Claude Opus 5.5 (Sumber: Google Blog / DeepMind Research, 2026).
1. Galeri Grafik Benchmark Asli Google DeepMind
Dalam rilis evaluasi resminya, Google DeepMind menyertakan visualisasi data langsung mengenai pengujian performa Gemini 4 Argon di berbagai ranah kritis, mulai dari rekayasa perangkat lunak otonom, penalaran finansial, hingga otomasi legalitas hukum:
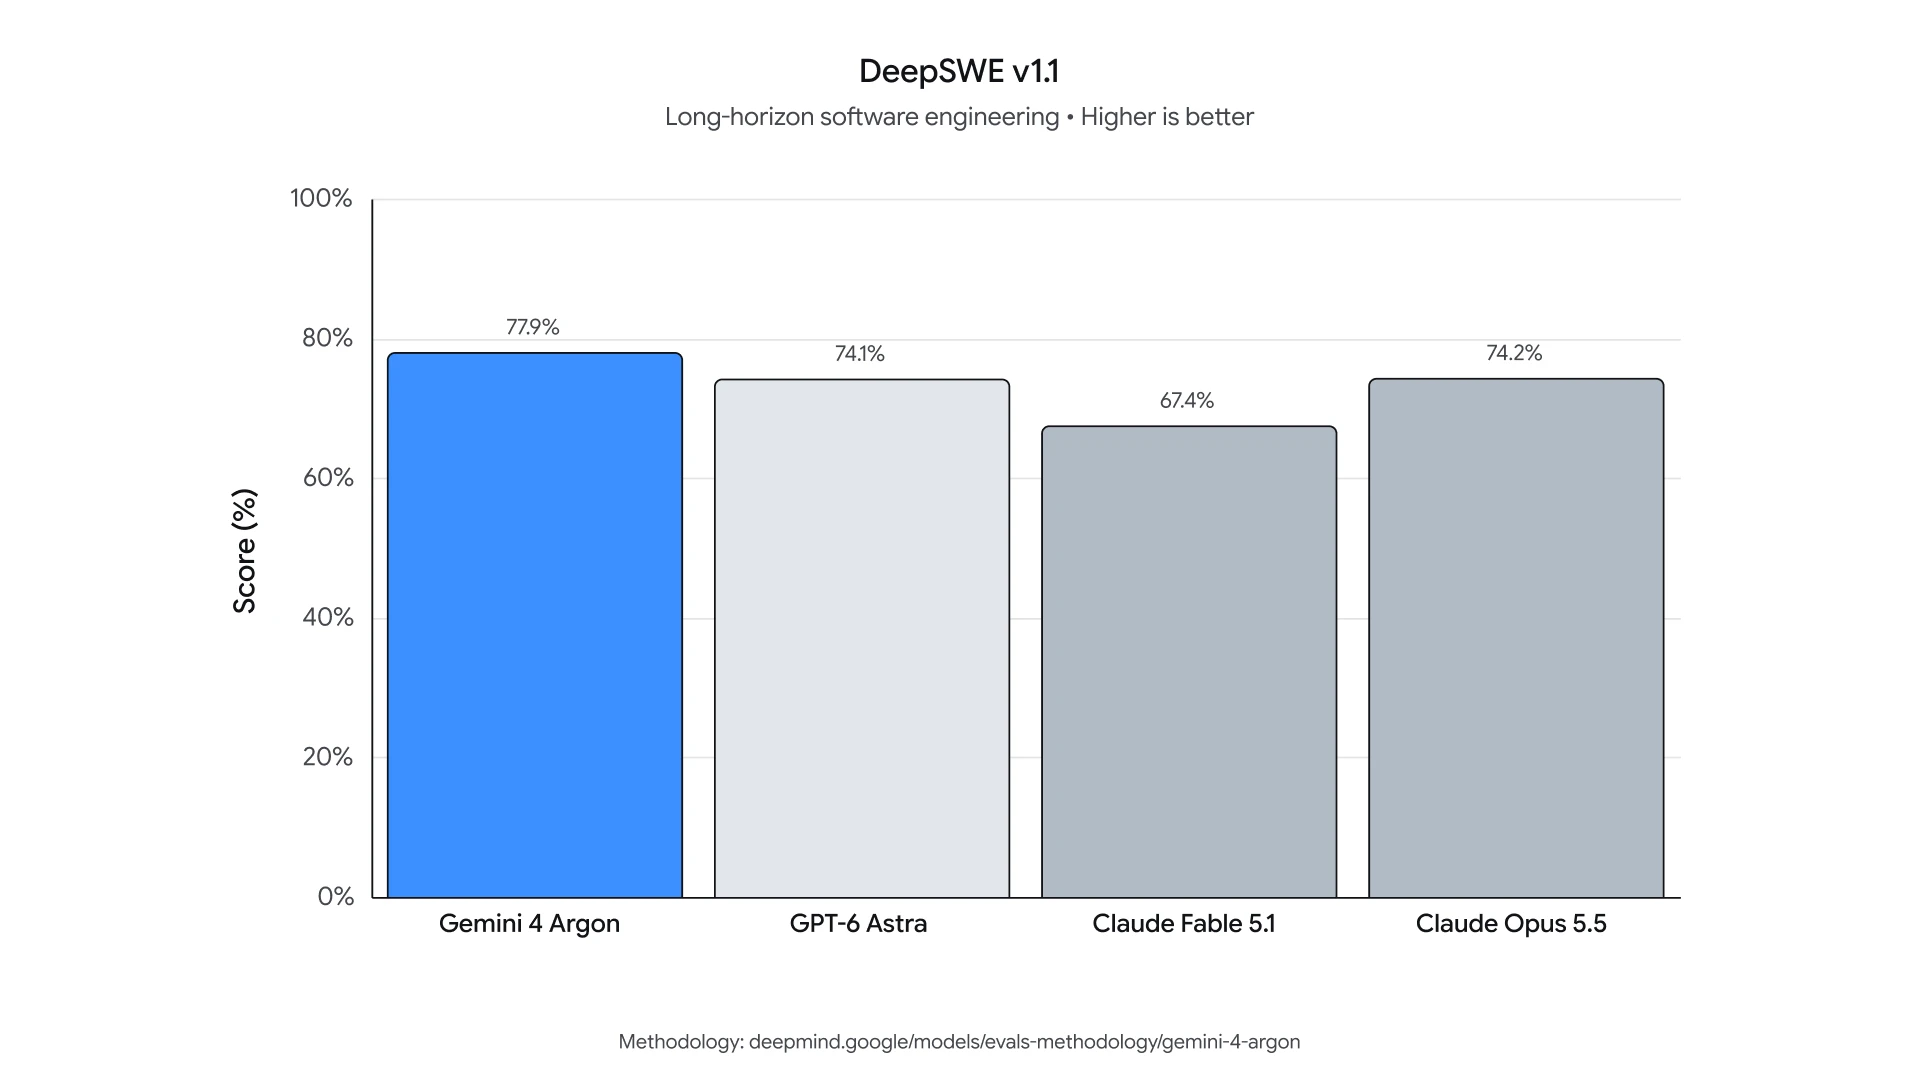
DeepSWE v1.1 (Software Engineering)
Gemini 4 Argon mencatat skor 77.9%, mengungguli Claude Opus 5.5 (74.2%) dan GPT-6 Astra (74.1%) dalam menyelesaikan tiket bug dan refactoring repository GitHub nyata.
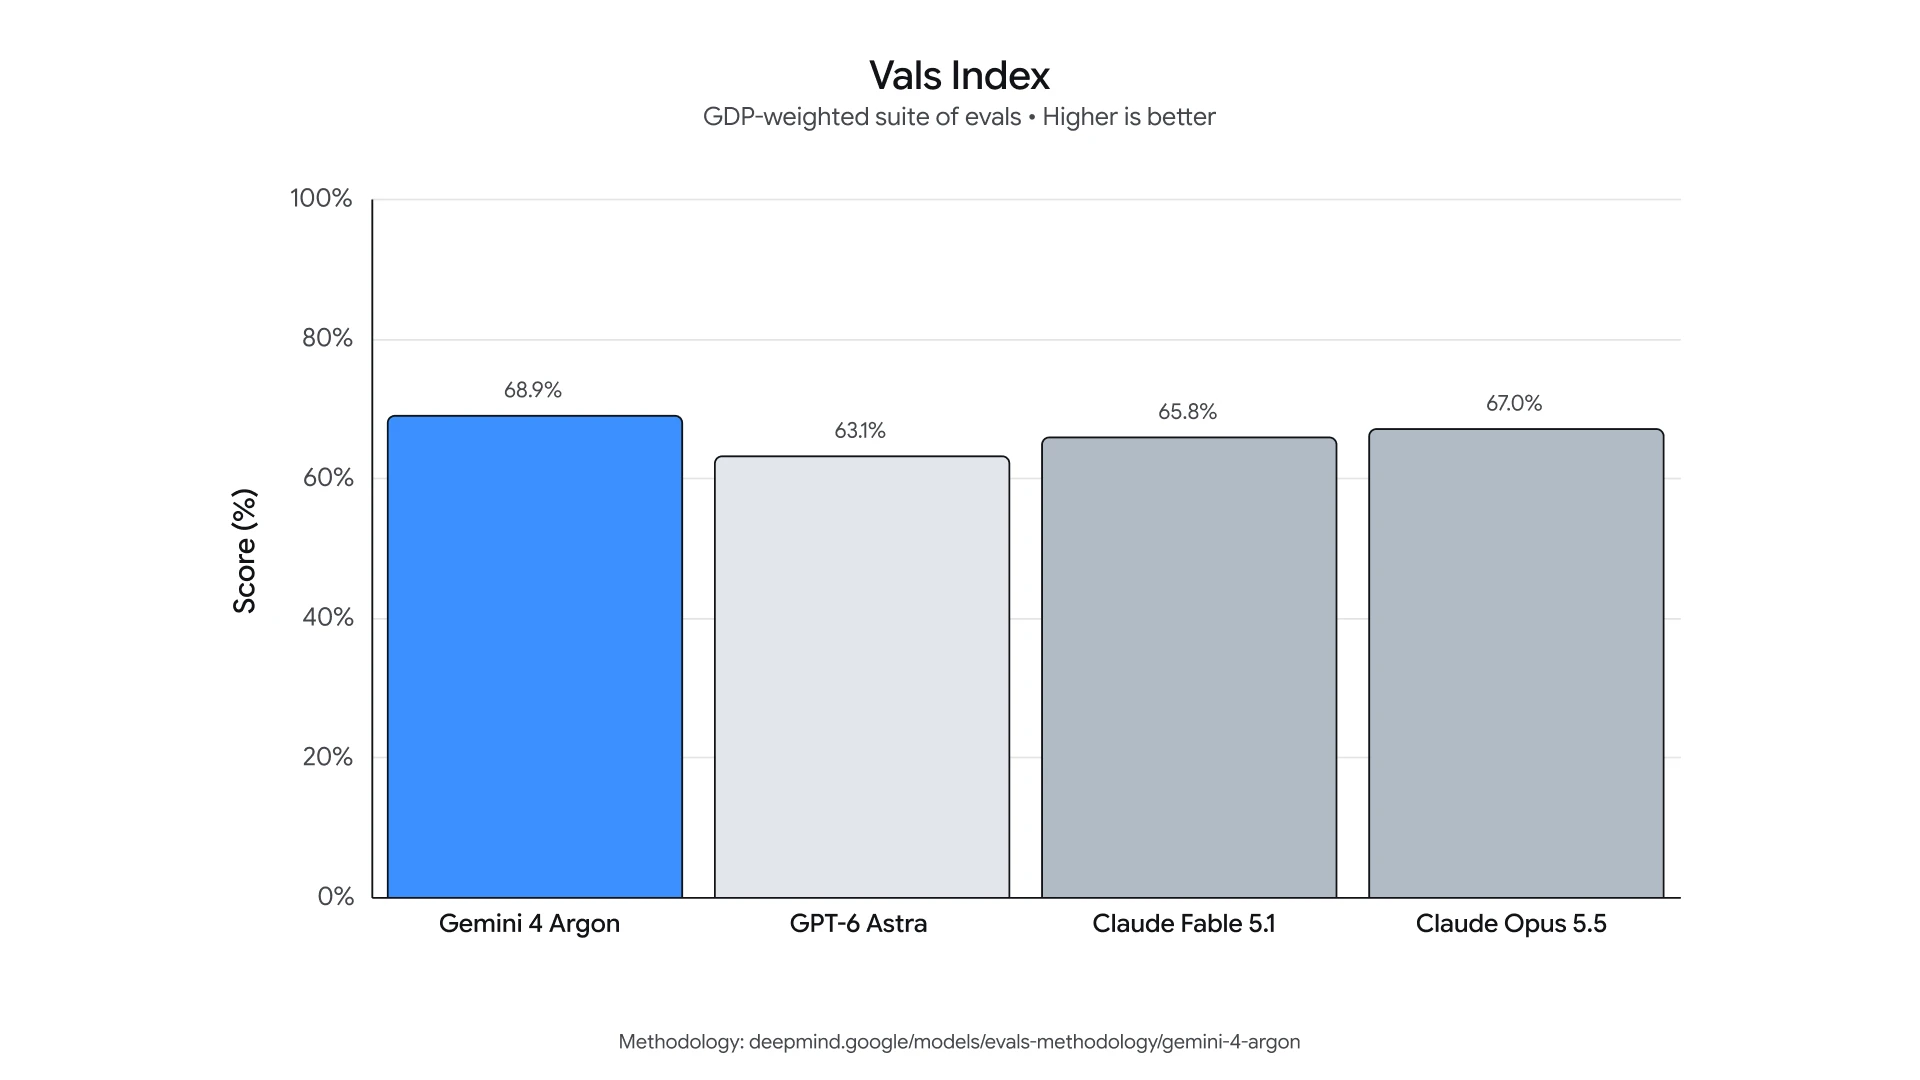
Vals Overall Intelligence Index
Menempati peringkat #1 dari 41 model frontier dengan skor 68.9%, melampaui Claude Opus 5.5 (67.0%) dan GPT-6 Astra (63.1%).
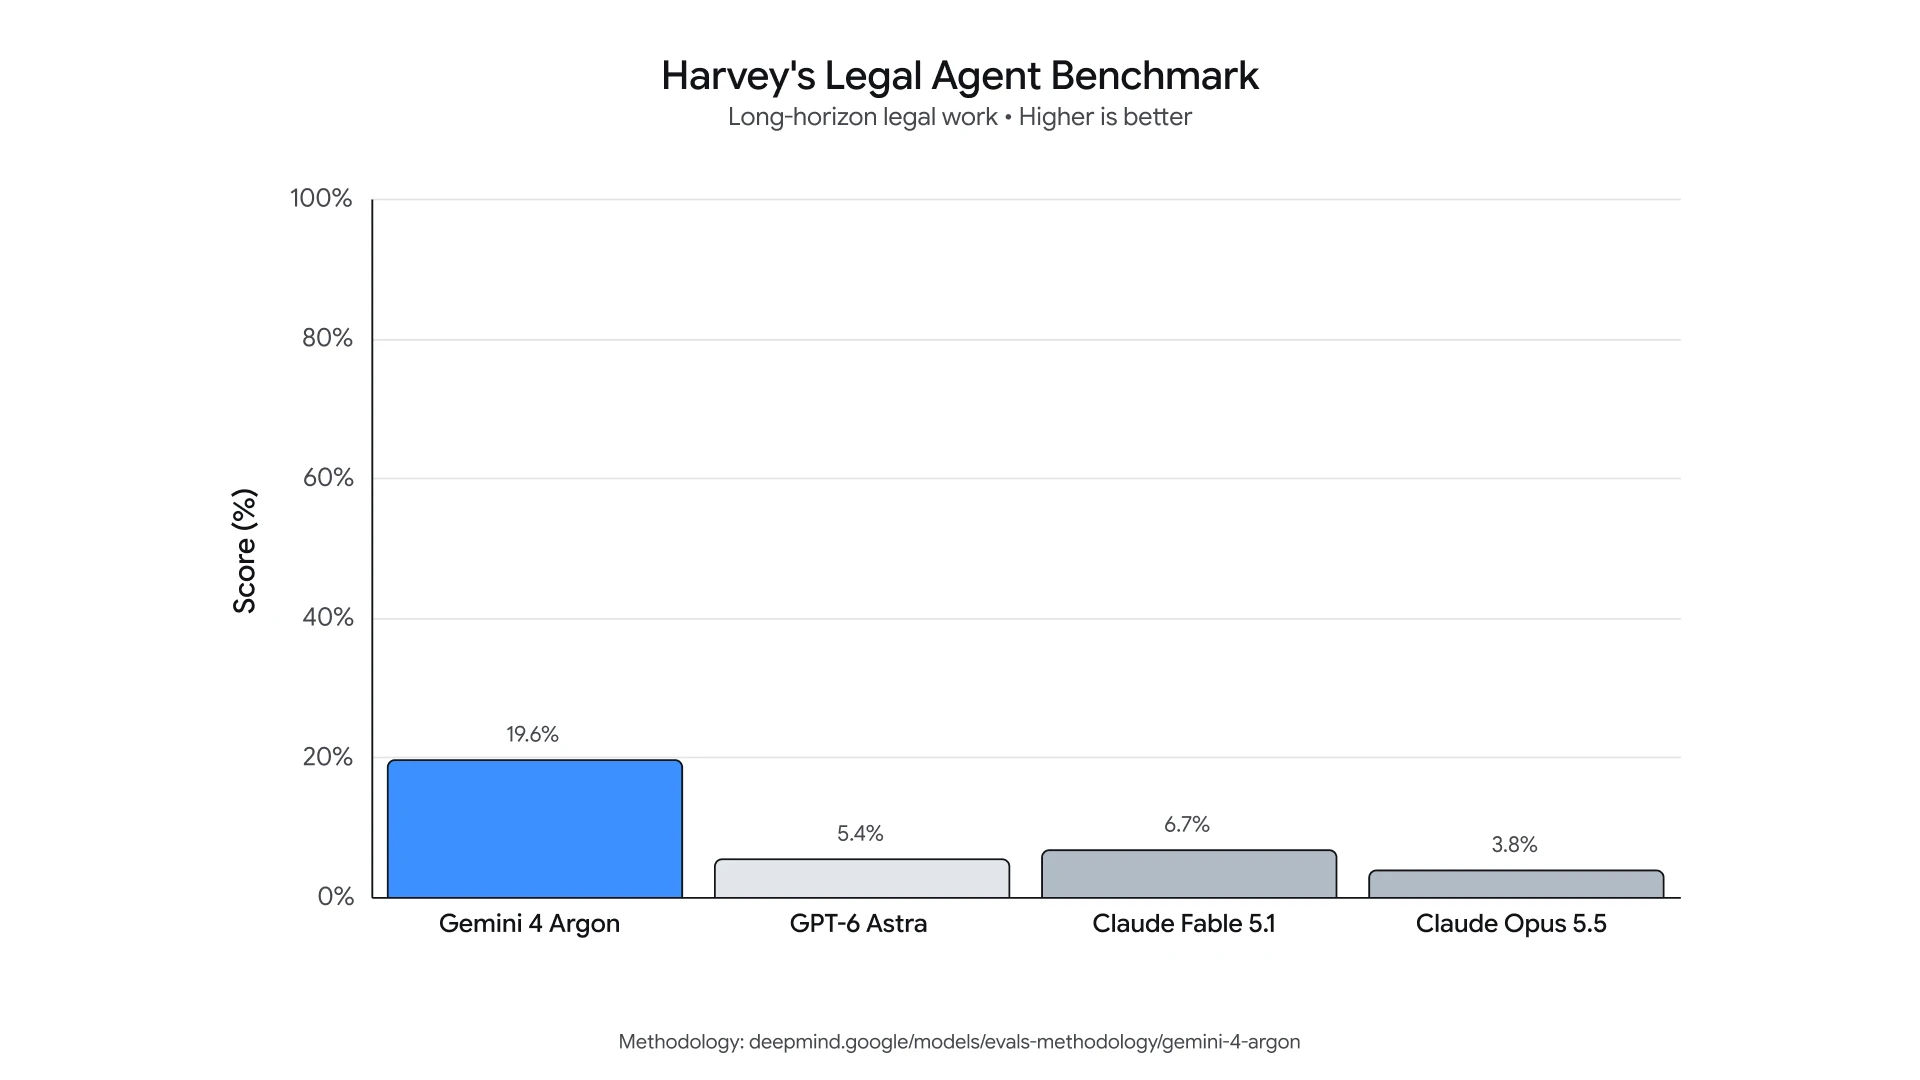
Harvey’s Legal Agent Benchmark
Lompatan dominan pada analisis dokumen hukum berskala raksasa dengan skor 19.6%, jauh di atas Claude Fable 5.1 (6.7%), GPT-6 Astra (5.4%), dan Opus 5.5 (3.8%).
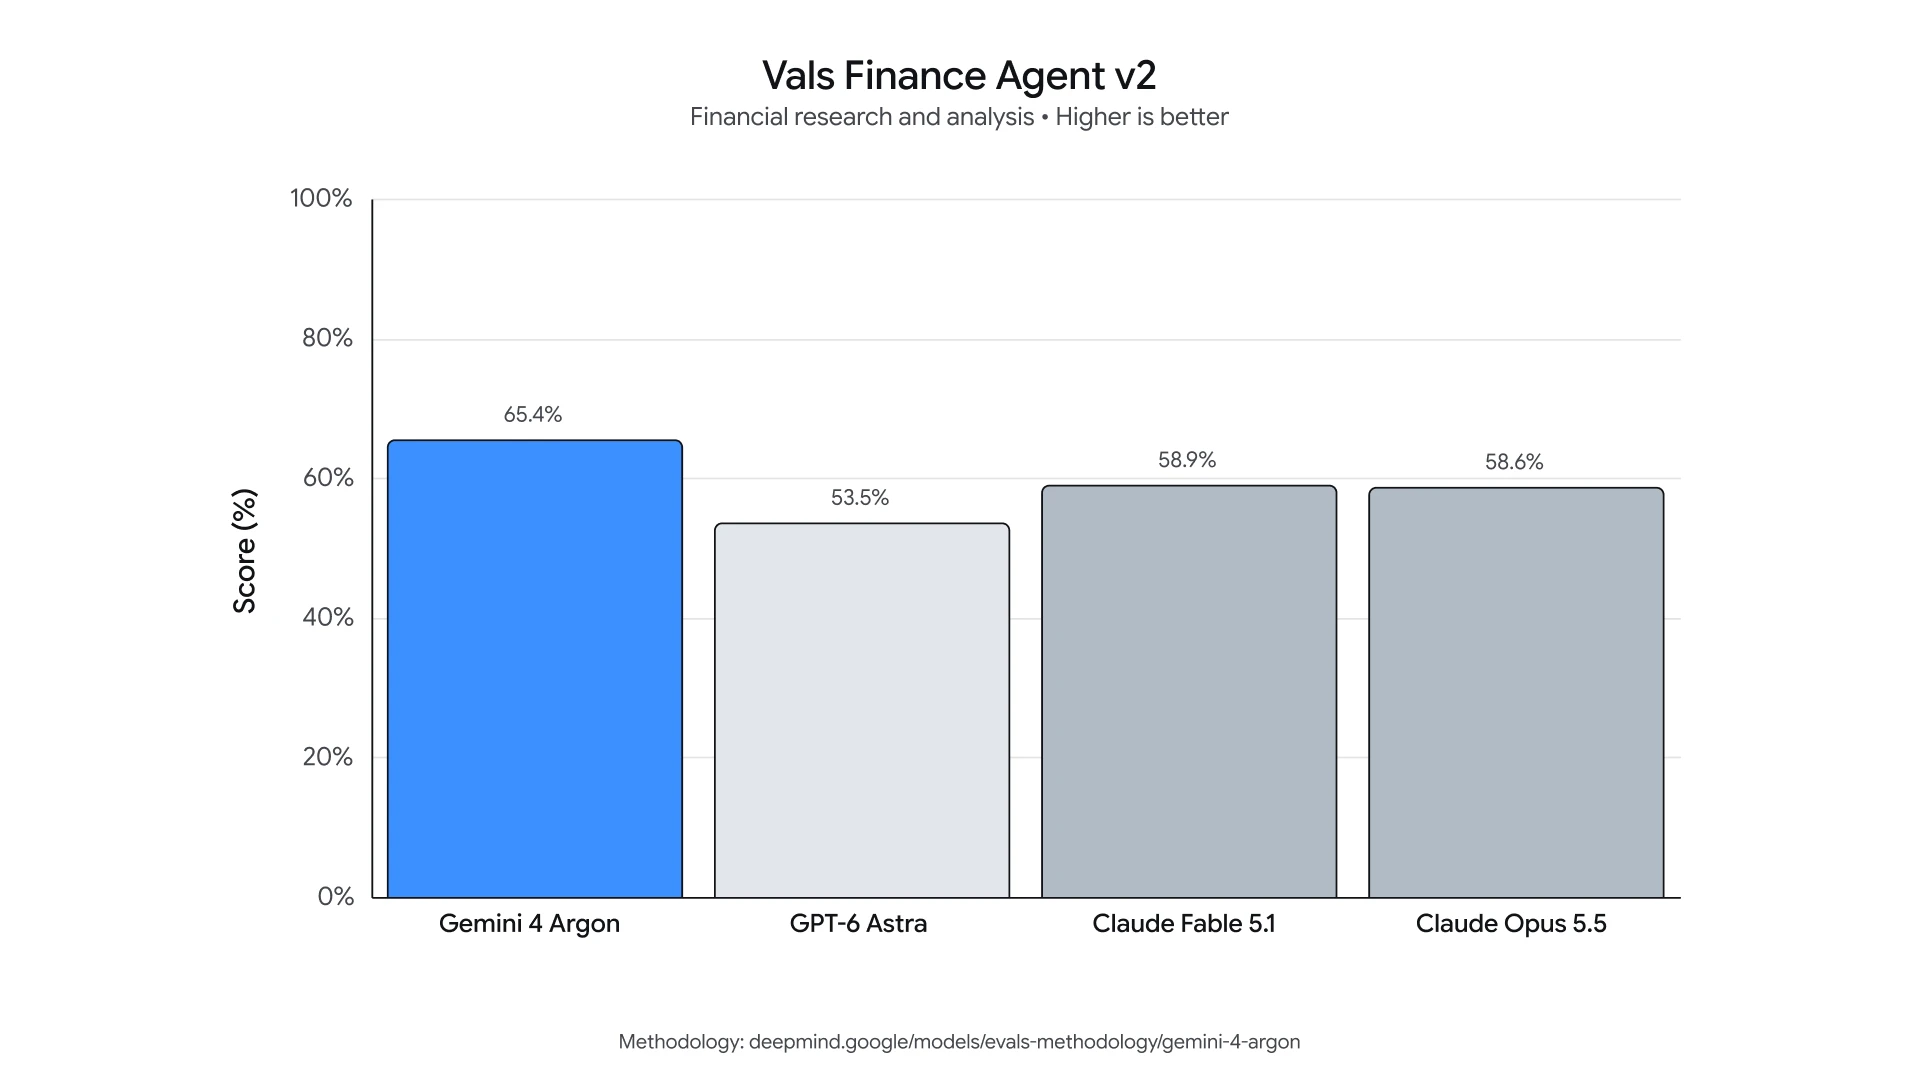
Vals Finance Agent v2 (Audit & Laporan Keuangan)
Memimpin di angka 65.4% dalam melakukan audit neraca keuangan, ekstraksi laporan 10-K, dan proyeksi model perbankan tanpa halusinasi matematis.
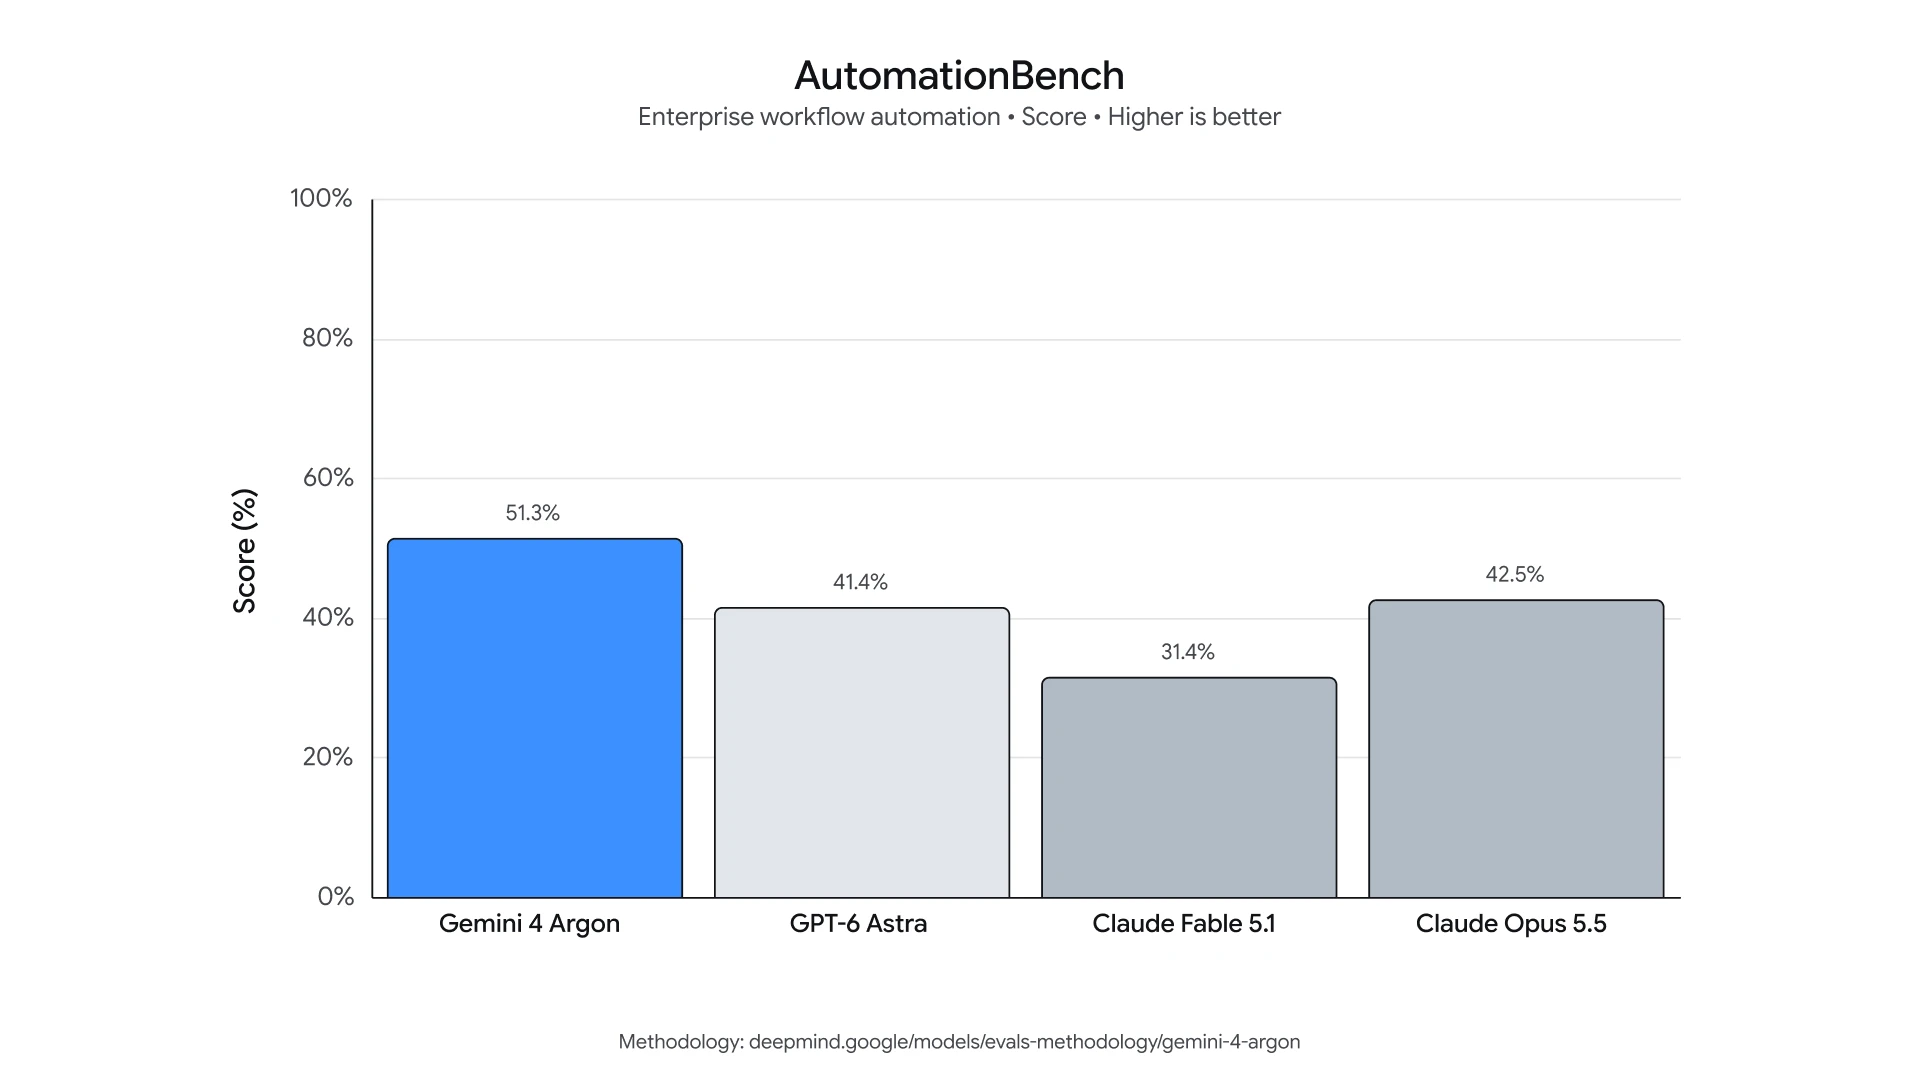
AutomationBench (Alur Kerja Eksekusi Multi-Aplikasi)
Mengeksekusi workflow browser dan desktop enterprise yang rumit, bersaing ketat dengan model spesialis otomasi.
2. Terobosan 1 Juta Output Token: Paradigma Baru Coding Otonom
Selama ini, agen pengembang AI terkendala oleh batas token keluaran (output token limit). GPT-6 Astra dan Claude Opus 5.5 memiliki batas 128.000 token, sementara model generasi sebelumnya hanya sanggup memuntahkan 4.096 hingga 64.000 token dalam satu respons.
Dengan 1.000.000 output tokens, Gemini 4 Argon mampu merancang arsitektur aplikasi monolitik maupun mikroservis dari nol, menuliskan seluruh dependensi, menulis ratusan berkas kode, dan mengompilasi dokumentasi teknis lengkap dalam satu instruksi tunggal tanpa terputus di tengah jalan.
3. Rekapitulasi Lengkap Benchmark Lintas Lembaga Evaluasi
| Tolok Ukur / Benchmark | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | Pemimpin Kategori |
|---|---|---|---|---|
| DeepSWE v1.1 (GitHub Engineering) | 77.9% | 74.2% | 74.1% | Gemini 4 Argon (+3.7%) |
| Vals Overall Index (41 Model) | 68.9% | 67.0% | 63.1% | Gemini 4 Argon (Rank #1) |
| Harvey's Legal Agent Benchmark | 19.6% | 3.8% | 5.4% | Gemini 4 Argon (+14.2%) |
| GraphWalks (256K - 1M Context) | 84.2% | 66.8% | 71.8% | Gemini 4 Argon (+12.4%) |
| LVBench (Long Video Comprehension) | 91.7% | 82.4% | 85.0% | Gemini 4 Argon |
| Terminal-Bench 4.0 (OS & Shell Control) | 57.4% | 66.4% | 58.2% | Claude Opus 5.5 (+9.0%) |
| Artificial Analysis Intelligence Index | 52.6 | 57.6 | 52.7 | Claude Opus 5.5 (+5.0) |
| Batas Maksimal Output Token | 1.000.000 Token | 128.000 Token | 128.000 Token | Gemini 4 Argon (8x Lipat) |
| Biaya API per 1 Juta Token (In/Out) | $2.00 / $10.00 | $4.00 / $20.00 | $10.00 / $50.00 | Gemini 4 Argon (Termurah) |
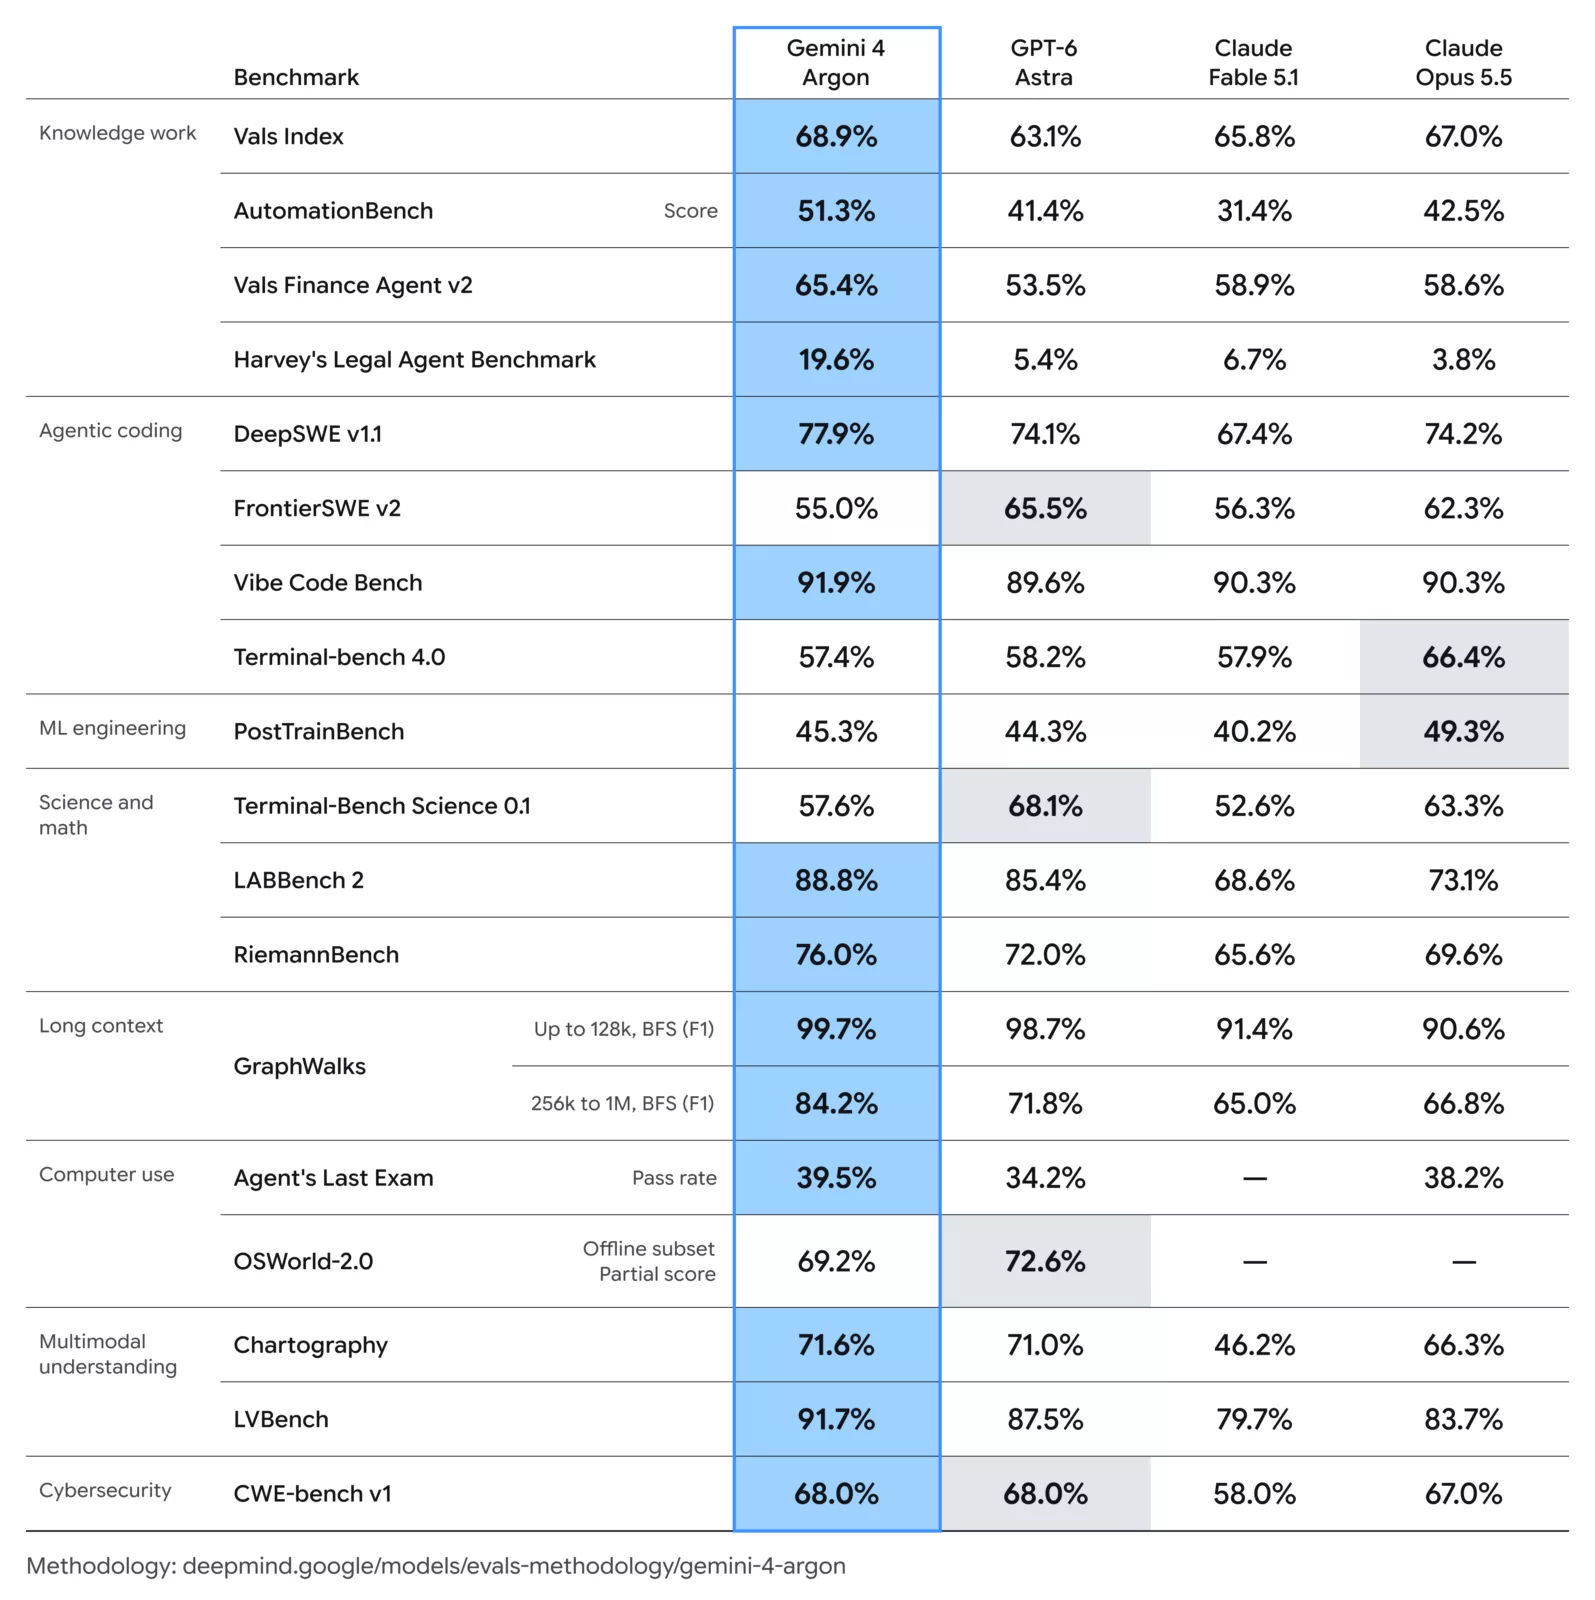
Gambar 2: Rekapitulasi Rinci Evaluasi 19 Kategori Gemini 4 Argon versi Komunitas Riset AI Eropa (TrendingTopics EU).
4. Ketersediaan & Inisiatif Pertahanan Siber Fairwind
Satu catatan penting bagi perusahaan enterprise: Google merilis Gemini 4 Argon secara bertahap. Gelombang pertama diberikan khusus kepada praktisi pertahanan siber terverifikasi dalam program Fairwind Cyber Defense guna membantu audit kerentanan zero-day dan pertahanan infrastruktur kritis.
Pengguna akun Google AI Ultra dan pelanggan komersial Google Cloud Vertex AI akan memperoleh akses bertahap pada kuartal keempat 2026, menjadikannya salah satu rilis model frontier paling dinantikan di industri AI saat ini.
Pandangan Redaksi NEWSAINT
Kehadiran grafik benchmark resmi dari Google DeepMind mempertegas bahwa Gemini 4 Argon bukan sekadar penyegaran minor, melainkan fondasi arsitektur baru untuk komputasi penalaran skala besar. Bagi industri AI, batas baru 1 juta output token dan efisiensi biaya separuh dari Opus 5.5 akan mengubah drastis cara rekayasa perangkat lunak otonom dikembangkan di masa depan.
Referensi & Sumber Terverifikasi
- [1]Announcing Gemini 4 Argon: Reimagining Deep Reasoning for Real-World Workflows(Google DeepMind Official Announcement / NPowerUser)
- [2]Gemini 4 Argon: Benchmarks, Pricing & Security (2026)(NeuralTrust AI Research & Safety Institute)
- [3]
- [4]Vals AI Frontier Intelligence Evaluation: Gemini 4 Argon Index Report(Vals AI Benchmark Registry)
- [5]Gemini 4 Argon: Our Next Era of Frontier Intelligence(Google Official Blog / Google DeepMind)
- [6]Gemini 4 Argon: Benchmarks, Pricing & Security (2026)(NeuralTrust AI Research & Safety Institute)
- [7]Vals AI Frontier Intelligence Evaluation: Gemini 4 Argon Index Report(Vals AI Benchmark Registry)
- [8]Google Benchmarks Comparison: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5(Trending Topics European Tech Intelligence)
- [9]BenchLM Frontier LLM Evaluation Ledger: Gemini 4 Argon(BenchLM Evaluation Institute)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.