MILO 2026: Arsitektur Meta-Evolutionary Island Orchestration, Hierarchical Lineage Memory, dan Automated Harness Discovery untuk Autonomous Coding Agents
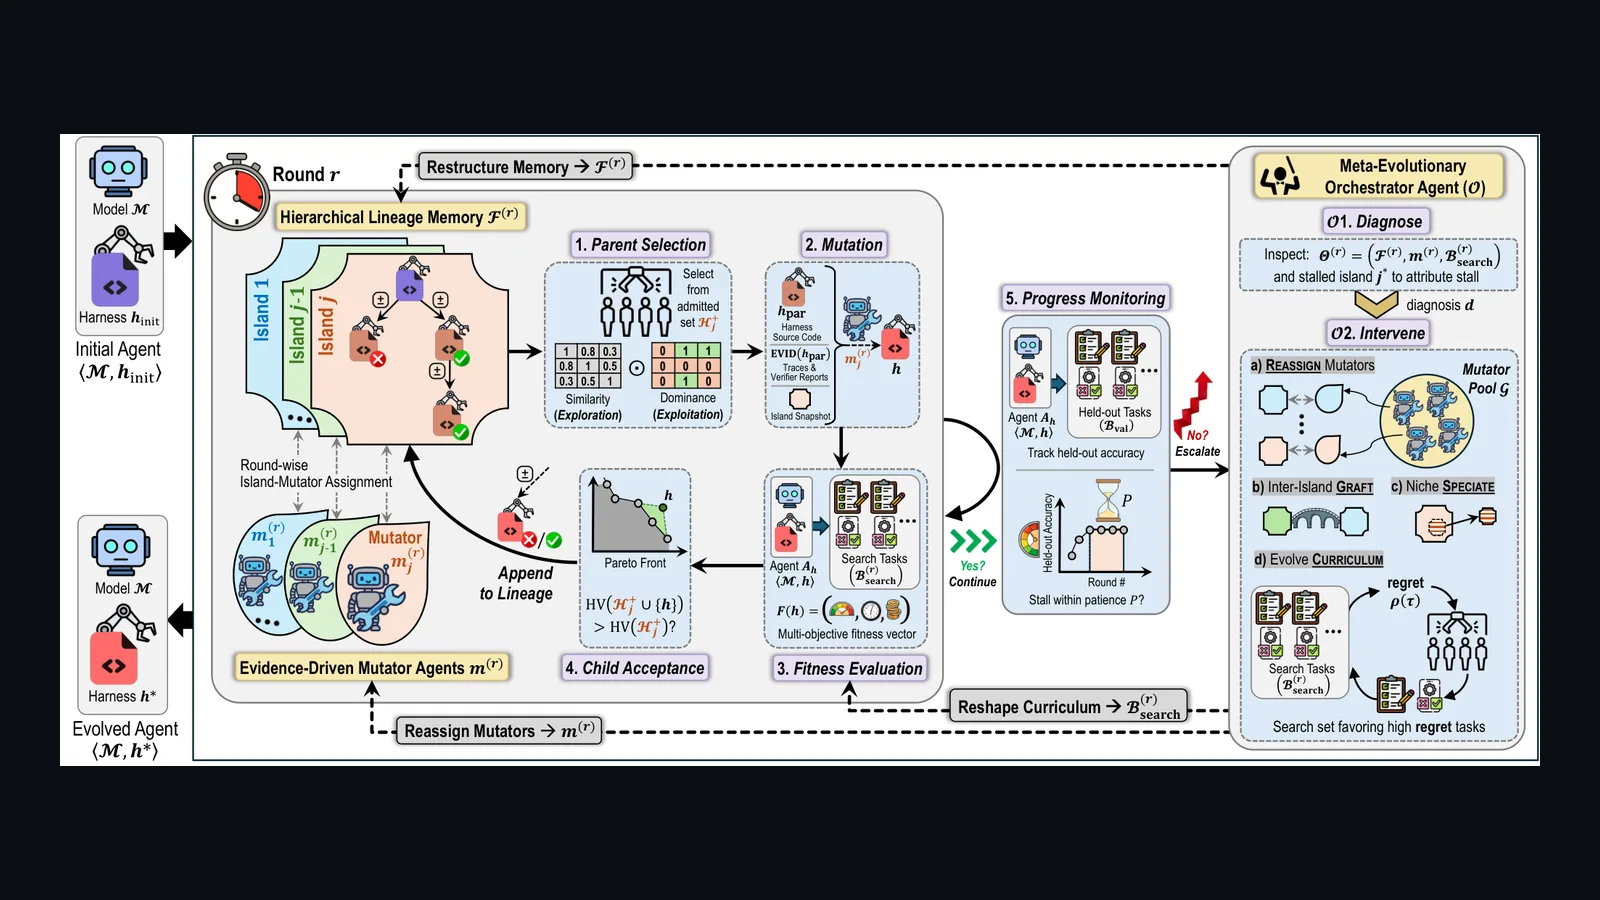
Analisis arsitektur sistemik riset frontier automatisasi rekayasa harness agen (arXiv:2609.38349, AWS AI Labs, Georgia Tech, CMU & WUSTL, Oktober 2026): Mengapa harness buatan manusia (artisanal) selalu tertinggal ketika model fondasi berganti atau task horizon melebihi ratusan langkah terminal. Memperkenalkan MILO (Meta-evolutionary Island Orchestration), framework penemuan harness otomatis pertama yang mengkoevolusikan harness kode agen sekaligus strategi pencariannya. Melalui Hierarchical Lineage Memory berbasis forest pohon pulau (island trees) yang mencatat mutasi tertolak sebagai negative evidence, Evidence-Driven Mutator Agents dengan workflow diagnose-first, serta Orchestrator Agent yang memitigasi stagnasi melalui 4 operator intervensi (Reassign, Graft, Speciate, Curriculum), MILO mendominasi Terminal-Bench 2.1 dengan pass-rate 86.1% (memangkas 26% konsumsi token), melesat +28.3% pada PaperBench, dan memecahkan rekor batas atas masalah matematika terbuka Erdős minimum-overlap pada EinsteinArena.
MILO: Otomasi Penemuan Harness Agen Koding Otonom Melalui Meta-Evolusi Multi-Agent Berbasis Pulau
Selama bertahun-tahun, rekayasa harness—lapisan perangkat lunak yang mengontrol alur eksekusi, injeksi prompt, intersep tool calls, dan verifikasi output LLM—dilakukan secara artisanal, manual, dan ad-hoc oleh tim engineer selama berbulan-bulan. Riset terkini membuktikan bahwa harness memengaruhi performa agen sebesar bobot model fondasi itu sendiri. MILO (Meta-evolutionary Island Orchestration) mendobrak paradigma ini dengan mengoevolusikan kode harness dan strategi penemuannya secara simultan melalui hierarchical lineage memory, evidence-driven coding mutators, dan meta-orchestrator yang mampu melompati jebakan optimum lokal.
1. Paradoks Harness Artisanal: Mengapa SOTA Harness Buatan Manusia Mengalami Bottleneck
Dalam arsitektur agen otonom modern seperti Claude Code, Codex, SWE-agent, maupun Terminus, sistem agen didefinisikan sebagai pasangan terikat:
Di mana ℳ adalah model fondasi (LLM) yang memproposisikan rencana aksi, dan h ∈ ℋ adalah harness perangkat lunak yang mengeksekusi aksi tersebut ke dalam lingkungan komputasi (terminal, shell, AST parser, test runner). Harness mengatur scaffolding (system prompt, daftar tools, restriksi context window, short/long-term memory) serta control flow (spawning sub-agent, retry budget, tool interception, dan stopping criteria).
Data empiris terbaru mengungkap fakta mengejutkan: pada Terminal-Bench, model identik GPT-5 hanya mampu menyelesaikan 35.2% tugas saat dipasangkan dengan harness Terminus 2, namun melonjak drastis hingga 49.6% ketika dijalankan di bawah harness Codex—sekaligus menghemat konsumsi token sebesar 35%. Sayangnya, membangun harness yang tangguh membutuhkan biaya riset yang sangat mahal karena tiga faktor kritis:
- Kombinatorial Ruang Desain Countably Infinite: Harness bukan sekadar prompt teks tunggal, melainkan program perangkat lunak utuh (ReAct loops, CodeAct bash wrappers, AST-guided test harness) dengan jutaan kemungkinan variasi interaksi.
- Sifat Model-Specific & Ketidakmampuan Transfer: Setiap model fondasi memiliki error modes, sensitivitas prompt, dan kapabilitas tool calling yang unik. Harness yang dioptimasi manual untuk Claude Opus sering kali menurunkan akurasi drastis saat dipasangkan pada open-weight LLM seperti Qwen-Code atau gpt-oss-120b.
- Kelemahan Metode Penemuan Otomatis Terdahulu (SOTA ES): Metode terdahulu seperti FunSearch, GEPA, dan Meta-Harness hanya mengoptimasi fragmen kecil (misal hanya prompt atau skill), menggunakan mutator stateless satu kali forward-pass tanpa eksekusi koding multi-turn, serta terkunci dalam exploitative bias yang gagal keluar dari jebakan optimum lokal.
2. Tiga Komponen Inti Arsitektur MILO
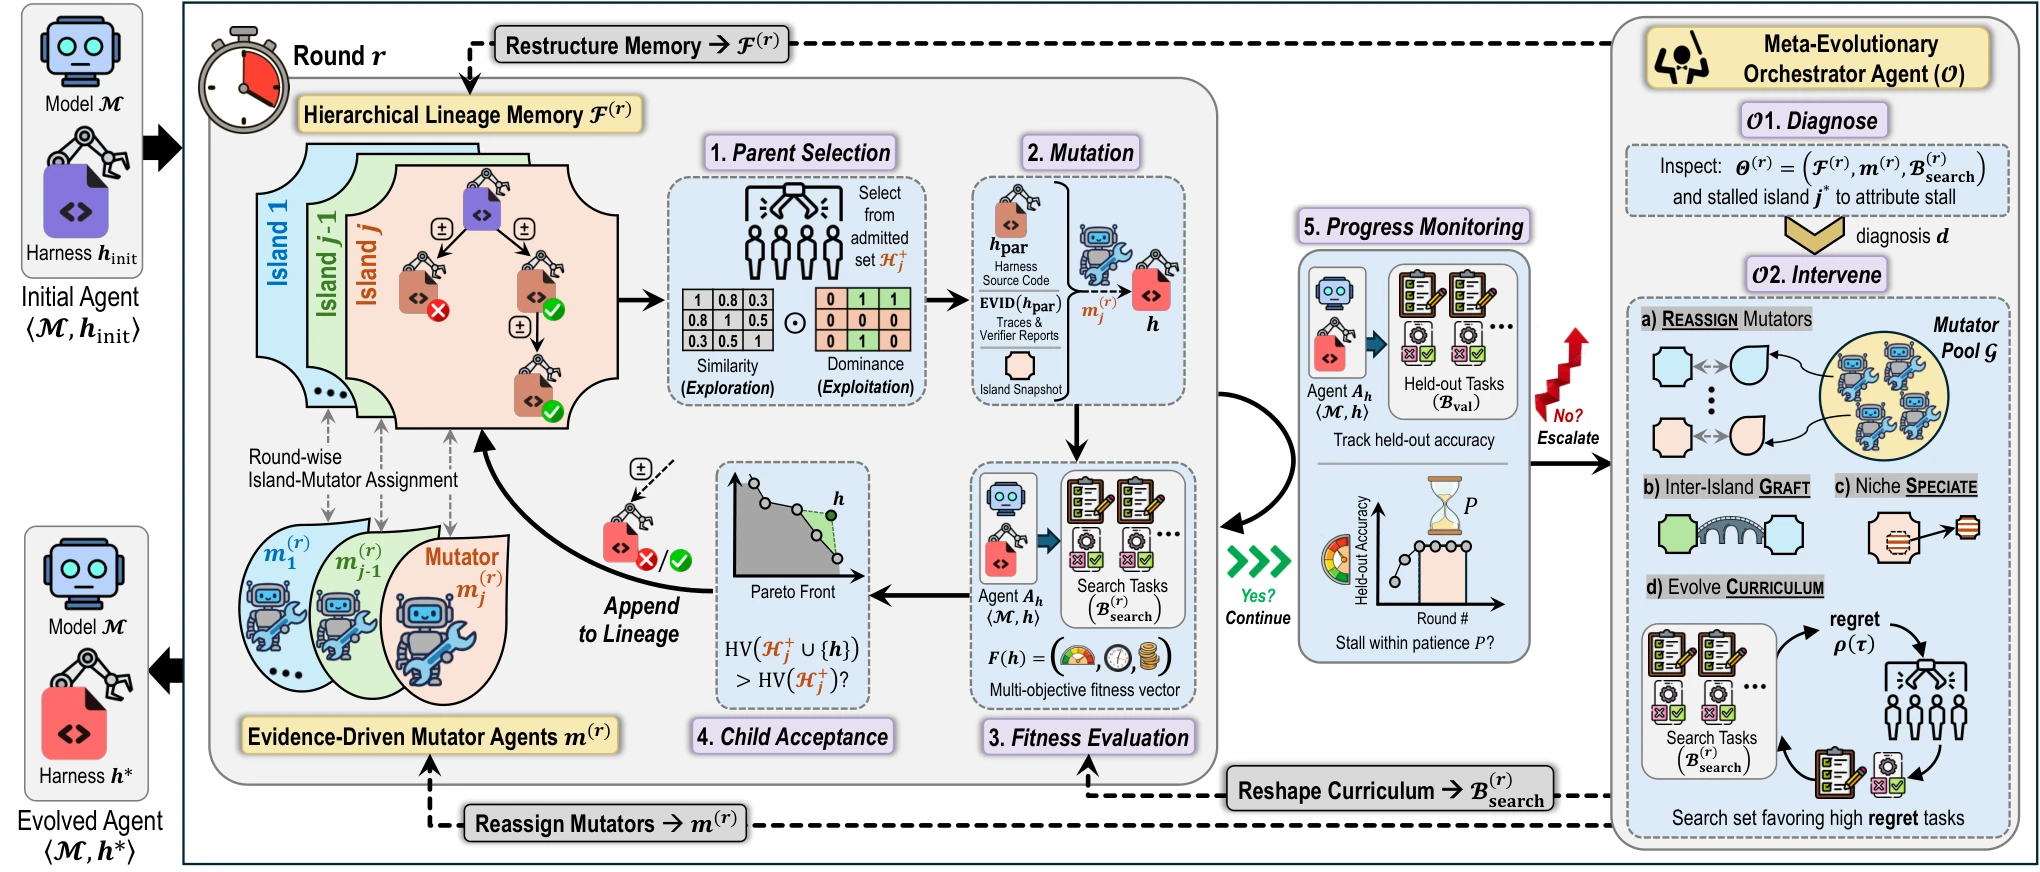
Untuk mengatasi keterbatasan metode pencarian evolusioner klasik, tim peneliti AWS AI Labs, Georgia Tech, CMU, dan WUSTL merekayasa MILO (Meta-evolutionary Island Orchestration) yang ditopang oleh tiga pilar arsitektur fundamental:
Hierarchical Lineage Memory
Struktur hutan pohon berlabel (forest of trees ℱ) yang memisahkan populasi ke dalam pulau-pulau independen (islands). Setiap node menyimpan skor Pareto, jejak eksekusi, serta kode patch. Paling krusial: mutasi yang ditolak (rejected candidates) tidak dibuang, melainkan disimpan sebagai negative evidence agar agen mutator tidak mengulangi kegagalan struktural yang sama.
Evidence-Driven Mutator Agents
Alih-alih prompt mutasi teks satu putaran, mutator MILO adalah agen koding multi-turn interaktif yang dibekali toolset lengkap (file read/write, bash, rg). Mutator menerapkan workflow diagnose-first: menganalisis log kegagalan orang tua (parent traces & compiler outputs) sebelum menulis patch unified-diff pada arsitektur kontrol agen.
Meta-Evolutionary Orchestrator
Supervisor global yang mengawasi seluruh pulau populasi. Ketika sebuah pulau mengalami stagnasi progres (stall), Orchestrator mendiagnosis akar masalah (apakah mutator tumpul, garis keturunan habis, atau ceruk tersingkir) dan mengeksekusi 4 operator intervensi dinamis untuk merestrukturisasi konfigurasi pencarian.
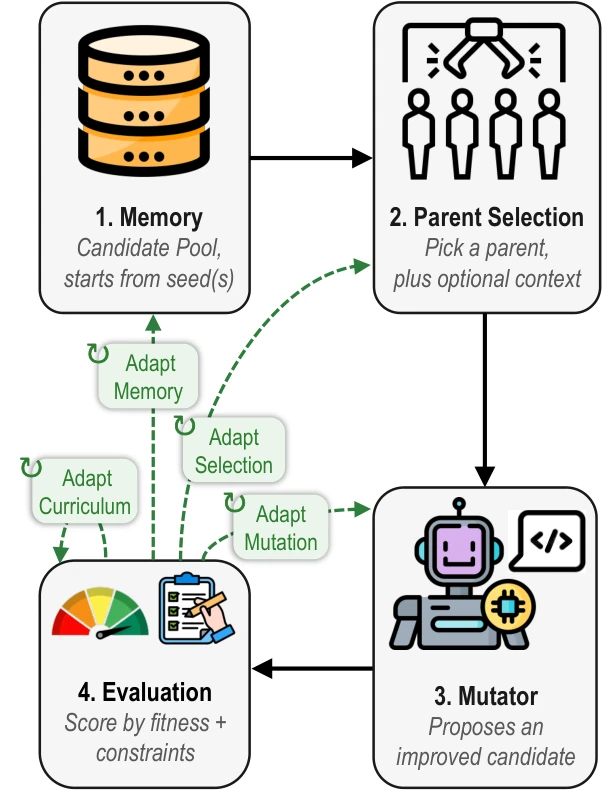
4 Operator Intervensi Orchestrator Saat Terjadi Kebuntuan:
- 1. Reassign(j, μ): Mengganti mutator agent pada pulau yang buntu dengan arsitektur mutator spesialis lain dari pool ketika mutator lama terus-menerus menghasilkan kode inert (dry mutator).
- 2. Graft(j_donor → j_dst): Menyilangkan sub-pohon harness terbaik dari pulau donor ke pulau penerima untuk mengimpor kapabilitas pemecahan masalah baru (lineage grafting).
- 3. Speciate(h, μ): Mempromosikan cabang minoritas yang menjanjikan menjadi pulau independen baru agar tidak tersingkir oleh garis keturunan dominan (niche protection).
- 4. Curriculum(B'): Memperluas atau merevisi distribusi task evaluasi untuk memaksa agen mengeksplorasi domain kegagalan baru saat seluruh populasi mencapai plateau.
3. Bukti Empiris & Dominasi Benchmark SOTA
MILO diuji secara ekstensif pada 3 benchmark rekayasa perangkat lunak berskala masif (long-horizon) melawan 8 harness buatan pakar industri (Cline, DeepAgents, Goose, Mini-SWE-Agent, OpenCode, OpenHands, Qwen-Code, Terminus-2) serta 6 metode automated search (OpenEvolve, ShinkaEvolve, EvoX, A-Evolve, GEPA, Meta-Harness):
| Model Fondasi | Metode Harness | Terminal-Bench 2.1 (RR@5) | PaperBench (RR@3) | DeepSWE (RR@3) | Efisiensi Token |
|---|---|---|---|---|---|
| Claude Opus 4.8 | Minimal Harness (Baseline) | 74.9% | 15.0% | 13.6% | Baseline (1.0x) |
| Claude Opus 4.8 | OpenHands (Expert Human SOTA) | 78.5% | 22.4% | 31.2% | +42% Overhead |
| Claude Opus 4.8 | Meta-Harness (Prior Auto-Search) | 79.4% | 33.3% | 31.2% | Stagnan (0% gain DeepSWE) |
| Claude Opus 4.8 | MILO (Proposed Framework) | 86.1 ± 2.0% | 43.3 ± 2.8% | 41.5 ± 2.1% | -26% Token Reduction |
| gpt-oss-120b | Minimal Harness (Baseline) | 38.6% | 0.0% | 0.0% | 1.0x |
| gpt-oss-120b | MILO (Proposed Framework) | 57.1 ± 2.0% | 21.6 ± 0.6% | 15.6 ± 1.7% | 20x Peningkatan Resolusi |
Beberapa penemuan penting dari evaluasi empiris di atas meliputi:
- Memecahkan Rekor Dunia Terminal-Bench 2.1: Pada Claude Opus 4.8, harness yang dievolusikan oleh MILO mencatatkan resolution rate 86.1%, melampaui posisi puncak leaderboard resmi sebelumnya (83.8%) dengan 26% konsumsi token lebih sedikit.
- Melipatgandakan Kapabilitas Model Open-Weight: Pada model terbuka gpt-oss-120b yang semula gagal total (0.0%) di benchmark multi-file software engineering DeepSWE, harness MILO merestrukturisasi sistem agen sehingga mampu mencapai 15.6% (peningkatan lebih dari 20 kali lipat dibanding rata-rata harness pakar 0.8%).
- Penemuan Ilmiah Masalah Terbuka Matematika (EinsteinArena): Pada ranah instance-level discovery, harness MILO memperketat batas atas matematis terbaik di dunia untuk masalah Erdős minimum-overlap problem dari 0.3808586 menjadi 0.3808568, serta memperbaiki batas first & third autocorrelation inequalities yang belum pernah terpecahkan oleh kalkulasi manusia.
4. Cetak Biru Arsitektur: Engine Meta-Evolusi Produksi
Berikut adalah implementasi TypeScript produksi yang memodelkan mesin seleksi Pareto, representasi pohon memori pulau (lineage forest), serta logika intervensi Orchestrator:
// Production Implementation: MILO (Meta-evolutionary Island Orchestration) Engine
// Berdasarkan Arsitektur AWS AI Labs & Georgia Tech (arXiv:2609.38349 - Oktober 2026)
//
// Karakteristik Inti:
// 1. Hierarchical Lineage Memory: Node- & Edge-labeled Trees per Island (menyimpan rejected candidates).
// 2. Multi-Objective Pareto Fitness: Menyeimbangkan akurasi, efisiensi token, dan limit latency.
// 3. Evidence-Driven Mutators: Workflow diagnose-first atas execution trace & failure reports.
// 4. Meta-Evolutionary Orchestrator: Intervensi dinamis (Graft, Speciate, Reassign, Curriculum) saat stagnan.

export interface ExecutionEvidence {
  taskId: string;
  trace: string[];         // Turn-by-turn action & tool outputs
  report: string;        // Compiler errors, assertion failures, or rubric leaf feedback
  cost: {
    tokens: number;
    latencyMs: number;
    toolCalls: number;
  };
}

export interface HarnessNode {
  harnessId: string;
  sourceCode: string;
  accuracy: number;
  costVector: { tokens: number; latencyMs: number };
  evidence: ExecutionEvidence[];
  isAdmitted: boolean;
  depth: number;
  parentId?: string;
  patchApplied?: string;   // Unified-diff e = (h_par -> h)
}

export interface IslandLineageTree {
  islandId: string;
  mutatorAgentId: string;
  rootId: string;
  nodes: Map;
  stallCounter: number;
  currentParetoFront: string[];
}

export class MILOEvolutionEngine {
  private islands: Map = new Map();
  private maxStallRounds: number = 3;
  private tokenCap: number = 100_000;

  constructor(initialSeeds: { id: string; code: string }[], mutatorPool: string[]) {
    initialSeeds.forEach((seed, idx) => {
      const islandId = `island-${idx + 1}`;
      const rootNode: HarnessNode = {
        harnessId: seed.id,
        sourceCode: seed.code,
        accuracy: 0.0,
        costVector: { tokens: 0, latencyMs: 0 },
        evidence: [],
        isAdmitted: true,
        depth: 0,
      };

      const nodes = new Map();
      nodes.set(seed.id, rootNode);

      this.islands.set(islandId, {
        islandId,
        mutatorAgentId: mutatorPool[idx % mutatorPool.length],
        rootId: seed.id,
        nodes,
        stallCounter: 0,
        currentParetoFront: [seed.id],
      });
    });
  }

  /**
   * Cek Pareto Dominance: h1 dominates h2 (h1 ≻ h2)
   */
  public dominates(h1: HarnessNode, h2: HarnessNode, eps: number = 0.005): boolean {
    const accDiff = h1.accuracy - h2.accuracy;
    if (accDiff > eps) return true;
    if (Math.abs(accDiff) <= eps) {
      // Jika akurasi setara dalam batas epsilon, menangkan yang paling hemat biaya (tokens & latency)
      return (
        h1.costVector.tokens <= h2.costVector.tokens &&
        h1.costVector.latencyMs <= h2.costVector.latencyMs &&
        (h1.costVector.tokens < h2.costVector.tokens || h1.costVector.latencyMs < h2.costVector.latencyMs)
      );
    }
    return false;
  }

  /**
   * Parent Selection: Menyeimbangkan eksploitasi Pareto dan eksplorasi dissimilar behavior
   */
  public selectParent(island: IslandLineageTree): HarnessNode {
    const admitted = Array.from(island.nodes.values()).filter(n => n.isAdmitted);
    if (admitted.length === 0) return island.nodes.get(island.rootId)!;

    // Utamakan kandidat di Pareto front yang belum sering bermutasi
    const paretoNodes = admitted.filter(n => island.currentParetoFront.includes(n.harnessId));
    return paretoNodes[Math.floor(Math.random() * paretoNodes.length)] || admitted[admitted.length - 1];
  }

  /**
   * Orchestrator Intervention: Diagnosis kebuntuan dan rekonfigurasi strategi pencarian
   */
  public orchestrateIntervention(stalledIsland: IslandLineageTree, allIslands: IslandLineageTree[]): string {
    console.warn(`[ORCHESTRATOR] Island ${stalledIsland.islandId} mengalami stagnasi (stall=${stalledIsland.stallCounter}). Mengevaluasi intervensi...`);

    // Cari donor island dengan akurasi Pareto tertinggi yang ortogonal
    const donor = allIslands.find(isl => isl.islandId !== stalledIsland.islandId);
    if (donor) {
      // 1. Intervensi Grafting: Silangkan harness terbaik donor ke pulau yang buntu
      const bestDonorNode = donor.nodes.get(donor.currentParetoFront[0])!;
      const graftedId = `graft-${bestDonorNode.harnessId}-to-${stalledIsland.islandId}`;
      stalledIsland.nodes.set(graftedId, {
        ...bestDonorNode,
        harnessId: graftedId,
        depth: stalledIsland.nodes.size,
        parentId: stalledIsland.currentParetoFront[0],
      });
      stalledIsland.stallCounter = 0;
      return `GRAFT: Mengimpor state ${bestDonorNode.harnessId} dari ${donor.islandId}`;
    }

    // 2. Intervensi Reassign Mutator jika donor tidak tersedia
    stalledIsland.mutatorAgentId = `mutator-specialist-${Date.now()}`;
    stalledIsland.stallCounter = 0;
    return `REASSIGN: Mengalokasikan mutator agent baru ke ${stalledIsland.islandId}`;
  }
}
5. Panduan Praktis untuk Tim Rekayasa AI Otonom 2026
Referensi & Sumber Terverifikasi
- [1]MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution(arXiv:2609.38349v1 [cs.AI / cs.SE] — Prithwish Jana, Mononito Goswami, Hao Liu, Xinyu Li, Langlin Huang, Zhehui Huang, Zhishen Huang, Patrick Blöbaum, Anoop Deoras, Purak Jain, Nikos Kanakaris, Sahika Genc (Georgia Tech, AWS AI Labs, CMU, WUSTL))
- [2]Meta-Harness: Automated Harness Optimization for Software Agents(arXiv:2602.12891 — Dongyoon Lee, Eric Xu, et al.)
- [3]Terminal-Bench 2.1: Evaluating Autonomous Long-Horizon System Engineering Agents(Frontier AI Evaluation Consortium — Michael Merrill et al.)
- [4]PaperBench-CodeDev: Evaluating End-to-End Scientific Reimplementation with Rubric Trees(ICML 2025 / arXiv:2506.09112 — Starace et al.)
- [5]DeepSWE: Multi-File Complex Software Engineering Benchmark for Frontier LLMs(Frontier Agent Benchmarks — Huang et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.