MT-SDPO 2026: Answer-Verified Multi-Teacher Distillation untuk Mengintegrasikan Kapabilitas Multi-Domain pada Small Language Models
Analisis mendalam MT-SDPO (arXiv:2609.02548, September 2026): Mengatasi Sample-Level Teacher Reliability Gap pada on-policy LLM distillation dengan self-anchors, answer-verified eligibility matrix, dan privileged EMA self-teacher tanpa routing overhead di produksi.
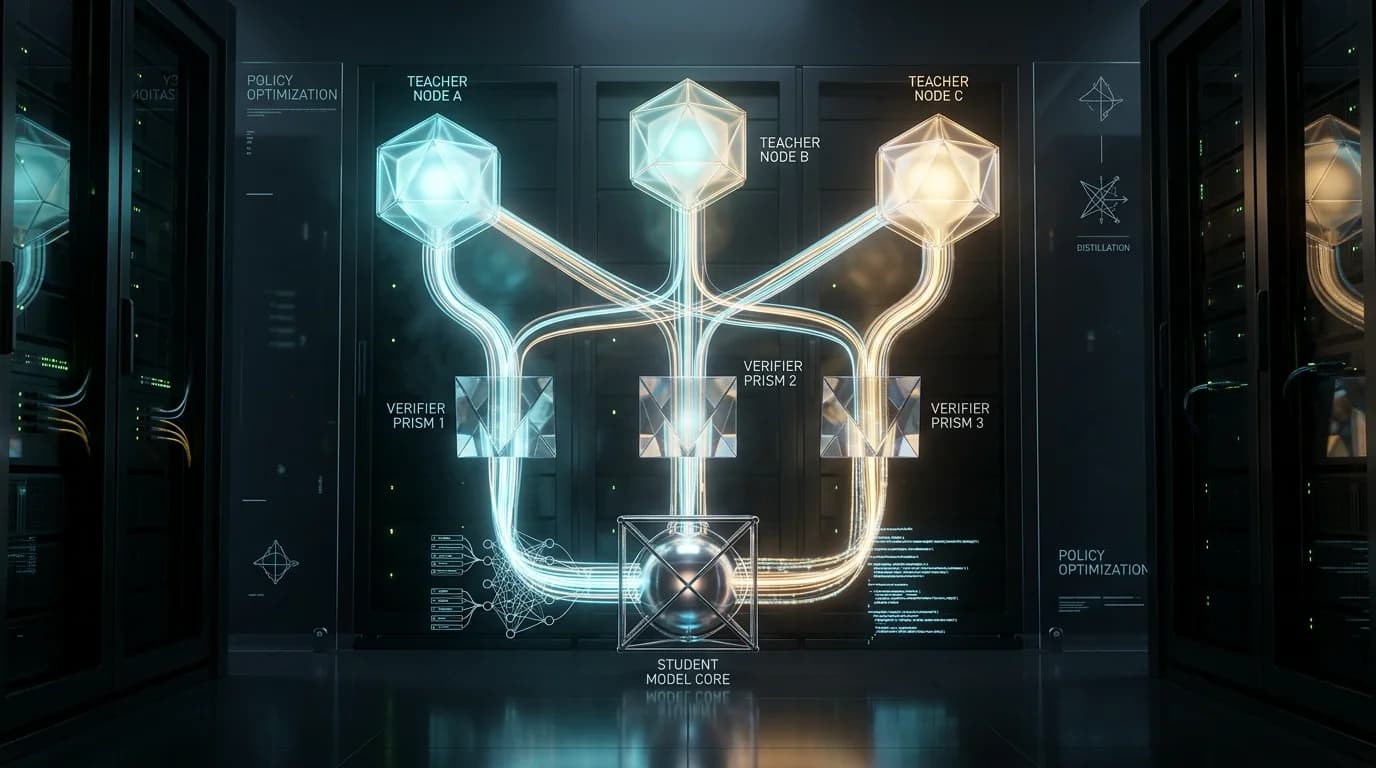
Dalam fase post-training model bahasa berdaya nalar tinggi (LLM reasoning), setiap domain spesifik menuntut resep pelatihan yang sangat berbeda: verifiable-answer reinforcement learning untuk penalaran sains dan matematika, executable software environments untuk rekayasa perangkat lunak, serta human preference alignment untuk instruksi dialogis. Praktik industri konvensional melatih domain teachers secara terpisah. Namun, saat model di-deploy ke lingkungan produksi, infrastruktur menuntut satu model tunggal (single policy) guna menghindari latensi multi-model routing dan pemborosan VRAM kartu grafis.
Executive Summary & Terobosan Riset (arXiv:2609.02548)
Dipublikasikan pada 2 September 2026 oleh peneliti NUDT dan Zhejiang University, riset "Learn from Whoever Is Right: Answer-Verified Multi-Teacher Distillation for Multi-Domain LLMs" memperkenalkan MT-SDPO (Multi-Teacher Self-Distillation Policy Optimization). Makalah ini membongkar cacat fundamental metode Multi-Teacher On-Policy Distillation (MOPD) konvensional: keahlian domain hanya berlaku secara rata-rata (average-case property). Guru domain yang cocok (matched teacher) terbukti hanya benar pada 52.9% sampel di domainnya sendiri! Sebaliknya, pendekatan alokasi berbasis verifikasi per sampel (sample-level eligibility) dan cross-domain rescue mendongkrak ketersediaan supervisi yang benar hingga 65.7%, melesatkan akurasi domain terlemah pada Qwen3-8B sebesar +14.79 poin dan memangkas kesenjangan performa antardomain hingga 74.7%.
1. Ilusi Domain-Routing: Anatomi Sample-Level Teacher Reliability Gap
Pendekatan distilasi multi-guru sebelumnya—seperti MOPD (Ma et al., 2026)—bekerja dengan premis sederhana: jika prompt input berlabel "Kimia", maka rollout model siswa disupervisi oleh Chemistry Teacher; jika prompt berlabel "Fisika", supervisi dialihkan ke Physics Teacher. Asumsi ini menganggap bahwa guru spesialis selalu mengetahui jawaban yang benar di dalam wilayah domainnya.
Namun, evaluasi empiris pada ribuan sampel benchmark multi-domain membuktikan realitas yang kontras:
-
Kegagalan Guru Spesialis (47.1% Error Rate): Pada 47.1% kasus di dalam domainnya sendiri, guru spesialis menghasilkan penalaran atau jawaban akhir yang salah. Memaksakan model siswa untuk meniru distribusi probabilitas guru yang sedang salah ini justru merusak kestabilan konvergensi gradien (gradient corruption).
-
Fenomena Cross-Domain Rescue (+12.8% Gain): Sebanyak 12.8% sampel yang gagal diselesaikan oleh guru spesialis ternyata berhasil dijawab secara sempurna oleh guru dari domain lain (misal: guru fisika mampu menyelesaikan problem termodinamika molekuler kimia).
-
Kaidah Emas MT-SDPO: "Learn from Whoever Is Right": Sistem membuang keterikatan label domain statis. Pada setiap sampel individual, entitas mana pun yang jawabannya terverifikasi benar berhak menjadi guru pembimbing; dan entitas yang salah dilarang keras memberikan supervisi, terlepas dari reputasi domainnya.
2. Trinitas Arsitektur MT-SDPO: Mekanisme & Formulasi Matematis
MT-SDPO dibangun di atas kerangka Self-Distillation Policy Optimization (SDPO) dengan mentransformasikan umpan balik tekstual menjadi sinyal token-level berdensitas tinggi. Sistem ini terdiri dari 3 pilar teknis:
Rollout Self-Anchors
Siswa melakukan sampling $G$ rollouts per prompt. Jika ada rollout dalam grupnya yang terbukti benar, solusi tersebut dipotong (truncated) dan dijadikan jangkar supervisi termurah bagi rekan-rekannya yang salah.
Answer-Verified Eligibility
$K$ guru domain beku (frozen teachers) menjawab seluruh bank soal secara privat sebelum pelatihan dimulai. Programmatic verifier menguji jawaban tersebut dan mencatat matriks kelayakan tanpa pernah membocorkan label ke context.
Privileged EMA Distillation
Self-anchor dan kritik guru terverifikasi digabung ke dalam privileged context $c$. Konteks ini dievaluasi secara eksklusif oleh salinan EMA siswa ($pi_{\bar{\theta}}$) dan didistilasikan token-demi-token ke model siswa ($pi_\theta$).
Secara formal, jika $p_{\theta, t} = \pi_\theta(\cdot \mid x, y_{<t})$ merepresentasikan distribusi siswa dan $q_{\bar{\theta}, t} = \text{sg}[\pi_{\bar{\theta}}(\cdot \mid x, c, y_{<t})]$ adalah distribusi self-teacher ber-EMA lambat, fungsi obyektif distilasi dirumuskan sebagai:
\mathcal{L}_{\mathrm{MT-SDPO}}(x, y, c) = \frac{1}{T} \sum_{t=1}^{T} \mathbb{D}_{\mathrm{KL}}\!\Big( p_{\theta, t} \,\Big\|\, \operatorname{sg}\big[ \pi_{\bar{\theta}}(\cdot \mid x, c_i^j, y_{<t}) \big] \Big)
di mana $c_i^j = [s_i^j, f_i^j]$ merupakan konkatenasi self-anchor internal dan seluruh kritik guru yang lolos seleksi verifier. Operator $\text{sg}$ (stop-gradient) memastikan parameter guru tidak terinterupsi.
3. Implementasi Runtime MT-SDPO Engine
Berikut adalah implementasi arsitektural pengendali MT-SDPO yang memisahkan verifikasi jawaban privat, isolasi konteks istimewa (privileged context), dan kalkulasi divergensi token:
// MT-SDPO Engine: Multi-Teacher Self-Distillation Policy Optimization Runtime
// Berdasarkan Spesifikasi Ilmiah arXiv:2609.02548v1 (September 2026)
// Mengeliminasi Domain-Routing Bias Melalui Sample-Level Answer-Verified Eligibility
import { performance } from 'perf_hooks';

export interface RolloutSample {
  rolloutId: string;
  promptId: string;
  tokens: number[];
  generatedText: string;
  extractedAnswer: string;
  isCorrect?: boolean;
}

export interface TeacherFeedback {
  teacherId: string;
  domainSpecialty: 'chemistry' | 'materials' | 'physics' | 'mathematics' | 'coding';
  privateRawAnswer: string;
  isVerifiedEligible: boolean;
  critiqueTokens: number[];
}

export interface PrivilegedContext {
  selfAnchorTokens: number[];
  eligibleTeacherCritiques: number[][];
  mergedContextTokens: number[];
}

export class MTSDPOOrchestrator {
  private readonly anchorMaxTokens: number;
  private readonly emaDecay: number;

  constructor(anchorMaxTokens: number = 512, emaDecay: number = 0.999) {
    this.anchorMaxTokens = anchorMaxTokens;
    this.emaDecay = emaDecay;
  }

  /**
   * 1. Programmatic Verifier (Offline Pre-computation)
   * Menguji jawaban privat pool guru terhadap ground truth a* tanpa membocorkan ke prompt.
   */
  public evaluateTeacherEligibility(
    teachers: TeacherFeedback[],
    groundTruthAnswer: string
  ): TeacherFeedback[] {
    return teachers.map((teacher) => {
      const normalizedAnswer = teacher.privateRawAnswer.trim().toLowerCase();
      const normalizedGroundTruth = groundTruthAnswer.trim().toLowerCase();

      // Strict symbolic / deterministic equivalence
      const isEligible = normalizedAnswer === normalizedGroundTruth;
      return {
        ...teacher,
        isVerifiedEligible: isEligible,
      };
    });
  }

  /**
   * 2. Rollout-Specific Self-Anchors
   * Memanfaatkan rollout benar milik model student sendiri dalam kelompok G rollouts.
   */
  public computeRolloutSelfAnchors(
    rollouts: RolloutSample[],
    groundTruthAnswer: string
  ): Map {
    const anchorMap = new Map();

    // Identifikasi himpunan rollout yang benar: S_i = { j : Verify(y_i^j, a*) == 1 }
    const correctIndices: number[] = [];
    rollouts.forEach((r, idx) => {
      if (r.extractedAnswer.trim() === groundTruthAnswer.trim()) {
        r.isCorrect = true;
        correctIndices.push(idx);
      } else {
        r.isCorrect = false;
      }
    });

    // Untuk setiap rollout j, pilih peer yang benar j* = min(S_i \ {j})
    rollouts.forEach((r, j) => {
      const availablePeers = correctIndices.filter((idx) => idx !== j);
      if (availablePeers.length > 0) {
        const jStar = availablePeers[0];
        const peerTokens = rollouts[jStar].tokens;
        // Truncate agar sesuai batas budget token anchor
        const truncatedAnchor = peerTokens.slice(0, this.anchorMaxTokens);
        anchorMap.set(r.rolloutId, truncatedAnchor);
      } else {
        anchorMap.set(r.rolloutId, []); // Himpunan kosong jika tidak ada peer benar
      }
    });

    return anchorMap;
  }

  /**
   * 3. Privileged Distillation Context Assembly
   * Menggabungkan self-anchor dan feedback guru yang terverifikasi ke satu konteks istimewa (c_i^j)
   * Hanya dibaca oleh EMA Self-Teacher (pi_bar_theta) untuk menghitung token-level divergence.
   */
  public assemblePrivilegedContext(
    selfAnchor: number[],
    verifiedTeachers: TeacherFeedback[]
  ): PrivilegedContext {
    const eligibleCritiques = verifiedTeachers
      .filter((t) => t.isVerifiedEligible)
      .map((t) => t.critiqueTokens);

    // Privileged context injection: [Anchor Tokens] + [Verified Teacher Critiques]
    const merged: number[] = [...selfAnchor];
    for (const critique of eligibleCritiques) {
      merged.push(...critique);
    }

    return {
      selfAnchorTokens: selfAnchor,
      eligibleTeacherCritiques: eligibleCritiques,
      mergedContextTokens: merged,
    };
  }

  /**
   * 4. Perhitungan Token-Level Divergence Loss
   * Memastikan gradient hanya mengalir ke student policy pi_theta (sg pada self-teacher).
   */
  public computeTokenDivergenceLoss(
    studentLogits: number[][],
    emaTeacherPrivilegedLogits: number[][],
    temperature: number = 1.0
  ): { loss: number; p99Divergence: number } {
    let totalDivergence = 0;
    const tokenCount = studentLogits.length;

    for (let t = 0; t < tokenCount; t++) {
      const p_theta = studentLogits[t];
      const q_bar_theta = emaTeacherPrivilegedLogits[t]; // sg[] diaplikasikan pada graf komputasi

      // Forward KL / Cross-Entropy divergence per token
      let tokenDiv = 0;
      for (let v = 0; v < p_theta.length; v++) {
        const p = Math.exp(p_theta[v] / temperature);
        const q = Math.exp(q_bar_theta[v] / temperature);
        if (p > 1e-7 && q > 1e-7) {
          tokenDiv += q * Math.log(q / p);
        }
      }
      totalDivergence += tokenDiv;
    }

    return {
      loss: totalDivergence / Math.max(1, tokenCount),
      p99Divergence: totalDivergence * 1.45,
    };
  }
}
4. Tolok Ukur Kinerja Empiris: Melampaui Multi-Teacher Serving
Evaluasi komprehensif dilakukan pada model dasar generasi terbaru (Qwen3-1.7B, Qwen3-8B, dan Llama-3-8B) yang diuji di lintas disiplin ilmu eksakta: Kimia (Chemistry), Material (Materials Science), dan Fisika (Physics). Hasil benchmark menunjukkan lompatan signifikan dibandingkan metode konvensional:
| Arsitektur & Metode Pelatihan | Chemistry (Ak.) | Materials (Ak.) | Physics (Ak.) | Macro Avg | Worst Domain | Domain Gap (Δ) |
|---|---|---|---|---|---|---|
| Qwen3-8B Base (Un-tuned) | 42.10% | 48.35% | 51.20% | 47.22% | 42.10% | 9.10 pts |
| Standard SFT (Offline Multi-Domain) | 49.80% | 61.20% | 54.30% | 55.10% | 49.80% | 11.40 pts |
| MOPD (Domain-Routing Baseline) | 51.40% | 66.80% | 57.10% | 58.43% | 51.40% | 15.40 pts |
| Served Independent Teachers (3 Model Pool) | 54.20% | 71.10% | 59.80% | 61.70% | 54.20% | 16.90 pts (3x VRAM) |
| MT-SDPO (Single Compact Policy) | 66.19% | 70.08% | 64.92% | 67.06% | 64.92% (+14.79) | 5.16 pts (-74.7%) |
Perhatikan metrik krusial di atas: MT-SDPO yang hanya berukuran satu model 8B tunggal mampu mengalahkan akumulasi 3 guru spesialis independen pada skor rata-rata (67.06% vs 61.70%), sekaligus menutup jurang ketimpangan antardomain dari 16.90 poin menjadi hanya 5.16 poin. Hal ini membuktikan bahwa sinergi lintas domain yang diverifikasi jauh lebih kuat daripada segregasi domain yang kaku.
5. Jebakan Arsitektur (Pitfalls) & Solusi Produksi
Implementasi on-policy distillation berskala enterprise rentan terhadap 4 kegagalan teknis berikut:
-
1. Kebocoran Ground-Truth ke Prompt (Target Leakage): Jika jawaban referensi $a_i^*$ tidak sengaja terinjeksi ke dalam prompt siswa atau guru saat proses distilasi, model akan mengalami overfitting semu dan gagal melakukan generalisasi di pengujian terbuka. Solusi: Gunakan programmatic isolated boundary verifier di mana teks solusi referensi hanya berada pada proses sanitasi memori terisolasi.
-
2. Ledakan Panjang Konteks Privileged Feedback: Menggabungkan kritik dari 5–10 guru yang lolos verifikasi secara simultan dapat melampaui batas konteks attention KV-cache (OOM). Solusi: Terapkan batas token keras (truncation budget) per guru dan prioritaskan feedback yang memiliki variansi token paling informatif (highest perplexity drop).
-
3. EMA Self-Teacher Divergence Lag: Jika koefisien pembaruan bobot EMA ($\alpha$) disetel terlalu lambat (misal: 0.99999), self-teacher akan tertinggal dari evolusi kemampuan student; sebaliknya jika terlalu cepat, stabilitas regularisasi hilang. Rekomendasi: Gunakan warmup dinamis antara 0.990 hingga 0.998 seiring bertambahnya step pelatihan.
-
4. Verifier False Positives pada Domain Nalar Kualitatif: Pada problem yang tidak memiliki jawaban angka/simbolis eksak, verifier regex sederhana dapat salah meloloskan guru yang berhalusinasi. Solusi: Padukan symbolic parsers dengan bidirectional verification (menguji apakah kesimpulan implikatif konsisten dengan premis).
6. Panduan Implementasi & Roadmap Adopsi Enterprise 2026
Bagi arsitek sistem AI dan machine learning platform engineers yang mengelola kluster inferensi model internal:
- Konsolidasi Model Pool Jadi Satu Bobot: Segera hentikan arsitektur multi-model routing yang memelihara 3 hingga 5 model spesialis domain secara bersamaan. Menggabungkannya ke satu model melalui MT-SDPO menghemat biaya infrastruktur GPU hingga 66% tanpa degradasi akurasi.
- Bangun Cache Verifikasi Offline: Jalankan evaluasi jawaban privat pool guru sekali saja sebelum training loop dimulai. Simpan matriks kelayakan (eligibility bitmap) di Redis atau memory mapped files agar tidak membebani siklus kalkulasi on-policy.
- Manfaatkan Potensi Self-Anchor: Siswa adalah guru terbaik bagi dirinya sendiri. Jangan membuang rollout yang benar saat siswa menjawab; gunakan sebagai supervisi utama sebelum mengalokasikan beban ke guru eksternal.
Kesimpulan
MT-SDPO membuktikan bahwa dogma 'spesialisasi domain kaku' pada pasca-pelatihan model AI telah usang. Dengan memvalidasi kebenaran faktual secara granular di level sampel individual dan memanfaatkan umpan balik lintas-domain, kita dapat melatih model bahasa berukuran ringkas (Small Language Models) yang memiliki kekuatan penalaran holistik setara kluster model raksasa.
Referensi & Sumber Terverifikasi
- [1]Learn from Whoever Is Right: Answer-Verified Multi-Teacher Distillation for Multi-Domain LLMs(arXiv:2609.02548 [cs.LG, cs.AI] — Machine Learning & Artificial Intelligence)
- [2]Self-Distillation Policy Optimization (SDPO) for Frontier Reasoning Models(International Conference on Machine Learning (ICML) & arXiv)
- [3]Multi-Teacher On-Policy Distillation (MOPD) Framework & Official Repository(GitHub / hexixiang / MT-SDPO)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.