One to More, More to One 2026: Arsitektur Category-Aware Iterative Expert Training, Algoritma Agentic-miniRL & RRE, dan Multi-Teacher On-Policy Distillation (MOPD) pada Autonomous Software Engineering Agents
Bedah arsitektur riset frontier Alibaba Group arXiv:2609.23377 (Jie Zhao, Ziyu Jiang, Suhang Zheng, Minghui Shan, Xiaoxiao Xu, Lin Qu, September 2026): Mengapa post-training RL konvensional (Pooled RL) pada software engineering agents kerap terjebak fenomena Category See-Saw—di mana peningkatan di satu kategori meregresi kategori lain? Makalah ini memperkenalkan framework spesialisasi kategori yang revolusioner tanpa guru lintasan eksternal (teacher-free). Mengawinkan SWE Labeler hierarkis, algoritma Agentic-miniRL berbasis RLOO & regularisasi K1, siklus Refresh-Repair-Expand (RRE) untuk melatih spesialis mandiri, serta integrasi satu model tunggal via Label-Routed Multi-Teacher On-Policy Distillation (MOPD) dengan ReLU-gated reward extrapolation. Berhasil mencetak rekor resolusi 58.04% pada Pro-618 (+5.39 pp) dan 59.00% pada SWE-bench Multilingual.
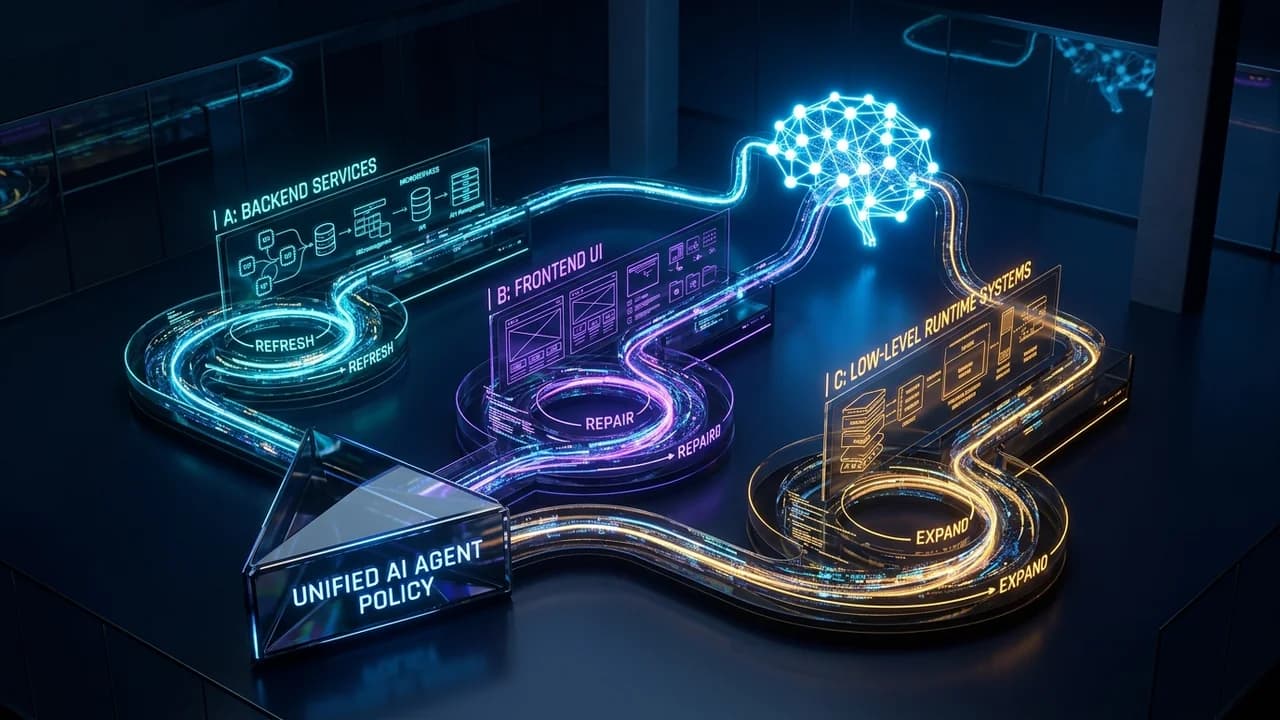
Pada pelatihan reinforcement learning (RL) model coding otonom skala repositori, komunitas riset selama ini bertumpu pada Pooled RL—menggabungkan seluruh jenis tiket bug ke dalam satu antrean seragam. Riset frontier Alibaba Group arXiv:2609.23377 mengungkap bahwa strategi pooled tersebut memicu fenomena Category See-Saw: perbaikan signifikan pada satu kategori rekayasa perangkat lunak (misalnya backend atau patch keamanan) secara diam-diam dibayar mahal oleh penurunan performa (regression) drastis di kategori antarmuka UI atau sistem dasar, tertutup oleh metrik rata-rata agregat.
Untuk mengakhiri dilema trade-off ini, Alibaba memperkenalkan paradigma One to More, More to One: memecah ruang tugas repositori secara terstruktur menggunakan SWE Labeler, melatih spesialis kategori berakar sama (same-origin experts) via algoritma Agentic-miniRL dan loop adaptif Refresh-Repair-Expand (RRE) tanpa guru trajektori eksternal, lalu menyatukannya kembali menjadi satu model terpadu melalui Label-Routed Multi-Teacher On-Policy Distillation (MOPD) dengan mekanisme ReLU-gated reward extrapolation. Hasilnya mencetak rekor resolusi 58.04% pada Pro-618 (+5.39 pp atas base model) dan 59.00% pada SWE-bench Multilingual, dengan peningkatan positif serentak di ketiga kategori teknis.
1. Anatomi Fenomena Category See-Saw: Mengapa Pooled RL Menipu Pengembang?
Mengembangkan agen otonom untuk rekayasa perangkat lunak tingkat repositori (repository-level SWE) berbeda fundamental dari memecahkan soal algoritma singkat (LeetCode/HumanEval). Trajektori agen melibatkan navigasi repositori berukuran gigabyte, penelusuran call-graph antarfile, pembacaan log tes unit, hingga sintesis patch multi-file yang panjang dan stateful.
Dalam implementasi industri, tugas-tugas repositori memiliki karakteristik yang sangat heterogen:
- Layanan & Keamanan Data (Category A): Berfokus pada invariant transaksi basis data, penanganan race conditions, sanitasi kriptografi, dan kontrak API internal. Memerlukan audit statis yang ketat dan trace eksekusi deterministik.
- Aplikasi Antarmuka & Presentasi (Category B): Berfokus pada state frontend, parsing event pengguna, format CLI, manipulasi DOM, dan rendering data visual. Sering kali mentolerir variasi implementasi asalkan fungsionalitas pengguna tercapai.
- Sistem, Tooling & Runtime (Category C): Berfokus pada modul kernel/OS, konfigurasi compiler, virtualisasi container, build system, dan sinkronisasi threading berlatensi rendah. Sangat rentan terhadap degradasi performa mikro.
Ketika satu model LLM tunggal dilatih menggunakan RL gabungan (Pooled RL) pada seluruh kumpulan tugas ini, pembaruan gradien (gradient updates) dari tugas Kategori A kerap kali berkonflik ortogonal dengan perilaku eksplorasi yang diperlukan untuk tugas Kategori B atau C. Evaluasi empiris Alibaba membuktikan bahwa skor resolusi agregat yang terlihat stabil atau naik tipis sesungguhnya menyembunyikan defisit parah: kenaikan +8% pada Kategori A terjadi bersamaan dengan anjloknya performa Kategori C hingga -6%.
| Paradigma Pelatihan | Strategi Komposisi Data | Dinamika Gradien & Pembelajaran | Risiko Kegagalan Produksi |
|---|---|---|---|
| Pooled RL (Konvensional) | Seluruh 6.723 tugas SWE dicampur secara acak dalam satu buffer rollout. | Gradient interference antarkategori; gradien tugas dominan mengikis kemampuan edge-case sistemik. | Category See-Saw: Peningkatan semu pada metrik agregat diiringi regresi tajam pada domain kritis. |
| Balanced RL | Sampling batch diseimbangkan secara merata per kategori (1:1:1). | Meredam dominasi satu kategori, namun model tunggal tetap dipaksa menginternalisasi multi-objektif yang berlawanan. | Stagnasi konvergensi: resolusi mandek pada batas kompromi moderat. |
| One-to-More-to-One (Alibaba) | Spesialisasi 3 expert independen via RRE → Disatukan via MOPD dengan ReLU extrapolation. | Eksplorasi murni pada domain masing-masing tanpa gangguan gradien luar; transfer terarah saat distilasi. | Optimal Pareto: Peningkatan serentak di seluruh kategori tanpa degradasi trade-off. |
2. Tiga Pilar Arsitektur: SWE Labeler, Agentic-miniRL, dan Siklus RRE
Framework One to More, More to One dibangun di atas tiga pilar teknologi yang terintegrasi secara matematis:
2.1 SWE Labeler: Taksonomi Bukti Multidimensi
Di dalam repositori tunggal, batas antarkategori tidak selalu eksplisit. Peneliti merancang SWE Labeler, sebuah sistem pelabelan hierarkis berbasis bukti nyata (evidence-grounded) yang menganalisis:
- Task Contract: Analisis AST pada file yang dimodifikasi, jenis dependensi pihak ketiga, dan modul target.
- Trajectory Traces: Pola panggilan tool yang dibutuhkan (apakah didominasi inspeksi runtime terminal vs penelusuran semantic grep).
- Grounding Rules: Aturan deterministik yang memetakan setiap instans ke dalam partisi mutually exclusive Kategori A, B, atau C.
2.2 Agentic-miniRL: RLOO Centering & Regularisasi K1
Tantangan terbesar RL pada lingkungan agen SWE adalah umpan balik verifikasi yang bersifat sparse binary (1.0 untuk lolos semua test suite, 0.0 jika satu saja gagal). Algoritma GRPO konvensional yang menyertakan sampel saat ini ke dalam rata-rata kelompok melemahkan sinyal pembelajaran pada tugas sulit di mana keberhasilan sangat langka.
Alibaba mengadopsi Leave-One-Out (RLOO) Reward Centering:
Dengan mengeliminasi rollout ke-i dari estimasi baseline-nya sendiri, RLOO menjaga ekspektasi gradien tidak bias (zero expectation score-function) sekaligus memaksimalkan varians reduksi tanpa memerlukan komputasi critic terpisah yang berat. Selain itu, drift kebijakan dikendalikan melalui penalti K1 divergence pada level token sebelum kalkulasi return-to-go, serta reduksi loss berbasis turn-aware masking untuk menyeimbangkan disparitas panjang aksi tool.
2.3 Refresh-Repair-Expand (RRE): Tanpa Guru Eksternal (Teacher-Free)
Banyak sistem agen SWE mengandalkan guru komersial raksasa (seperti Claude 3.5 Sonnet atau GPT-4o) untuk memproduksi trajektori sintetis. Sebaliknya, Alibaba membuktikan bahwa model dasar berbobot sama (π0) dapat mengembangkan keahlian spesialis mandiri dengan mengulang siklus RRE:
- Refresh: Menguji ulang instans kandidat untuk memperbarui peta penguasaan (mastery map). Instans yang sudah 100% dikuasai disisihkan agar komputasi tidak mubazir.
- Repair SFT: Mengumpulkan trajektori sukses yang berhasil dieksekusi oleh model itu sendiri di lingkungan nyata, lalu menggunakannya untuk fine-tuning terarah guna mengonsolidasikan perilaku pemecahan masalah yang benar.
- Expand: Memperluas antrean pelatihan RL berikutnya dengan memasukkan instans yang berada tepat di perbatasan kemampuan (learning frontier, tingkat penguasaan antara 0% hingga 80%).
3. Implementasi Kode: Komponen Inti MiniRL & Distilasi MOPD
Cuplikan modul Python berikut mengilustrasikan logika operasional RLOO advantage calculation, token loss dengan penalti K1, serta router keuntungan MOPD berbasis ReLU gating:
"""
One to More, More to One: Category-Aware Iterative Expert Training Architecture.
Berdasarkan Makalah Frontier arXiv:2609.23377 (Alibaba Group, September 2026).

Komponen Arsitektur Utama:
1. SWE Labeler: Pengelompokan taksonomi bukti multi-axis ke dalam 3 kategori terisolasi (Pro-A, Pro-B, Pro-C).
2. Agentic-miniRL: RLOO reward centering + regularisasi K1 + koreksi rasio token probabilitas.
3. Refresh-Repair-Expand (RRE): Siklus adaptif penyegaran mastery, Repair SFT trajektori sukses mandiri,
   dan pembukaan perbatasan eksplorasi RL.
4. Label-Routed Multi-Teacher On-Policy Distillation (MOPD): Ekstrapolasi reward berbasis ReLU gating
   untuk menggabungkan kembali expert menjadi satu model siap produksi (deployable student).
"""

import math
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
from dataclasses import dataclass, field
from enum import Enum
from typing import Dict, List, Optional, Tuple

class SWECategory(Enum):
    CATEGORY_A = "service_data_security"  # Backend, database, middleware, crypto
    CATEGORY_B = "user_facing_applications" # Web UI, CLI interaction, client presentations
    CATEGORY_C = "systems_tooling_runtimes" # Compilers, build systems, virtualization, OS kernel

@dataclass
class SWEInstance:
    instance_id: str
    repo_name: str
    problem_statement: str
    category: SWECategory
    baseline_success_rate: float = 0.0
    current_mastery: float = 0.0

@dataclass
class TrajectoryRollout:
    instance_id: str
    tokens: torch.Tensor
    behavior_logprobs: torch.Tensor
    is_terminal_success: bool
    executable_reward: float  # 1.0 jika lolos verifier, 0.0 jika gagal
    action_turns_mask: torch.Tensor

class AgenticMiniRL:
    """
    Algoritma RL untuk agen software engineering multi-turn berhorizon panjang.
    Menggunakan Leave-One-Out (RLOO) untuk centering reward tanpa bias finite-group.
    """
    def __init__(self, beta_k1: float = 0.02, clip_epsilon: float = 0.2):
        self.beta_k1 = beta_k1
        self.clip_epsilon = clip_epsilon

    def compute_rloo_advantages(self, returns: List[float]) -> List[float]:
        """
        Rumus RLOO: \bar{R}_i = R_i - (1 / (G - 1)) * \sum_{j != i} R_j
        Mencegah peredaman gradien pada kelompok sparse reward dengan finite sample G.
        """
        G = len(returns)
        if G <= 1:
            return [0.0] * G

        sum_all = sum(returns)
        advantages = []
        for r_i in returns:
            baseline_other = (sum_all - r_i) / (G - 1)
            advantages.append(r_i - baseline_other)
        return advantages

    def compute_token_loss(
        self,
        current_logprobs: torch.Tensor,
        old_logprobs: torch.Tensor,
        ref_logprobs: torch.Tensor,
        advantage: float,
        turn_mask: torch.Tensor
    ) -> torch.Tensor:
        """
        Menghitung MiniRL Token Update dengan regularisasi K1:
        K1 = exp(log_ref - log_curr) - (log_ref - log_curr) - 1
        """
        # Rasio probabilitas pi_theta / pi_theta_minus
        ratio = torch.exp(current_logprobs - old_logprobs)
        clipped_ratio = torch.clamp(ratio, 1.0 - self.clip_epsilon, 1.0 + self.clip_epsilon)

        # Policy gradient surrogate
        surr1 = ratio * advantage
        surr2 = clipped_ratio * advantage
        policy_loss = -torch.min(surr1, surr2)

        # Penalti drift K1 terhadap model referensi beku
        log_diff = ref_logprobs - current_logprobs
        k1_penalty = torch.exp(log_diff) - log_diff - 1.0

        total_loss = policy_loss + self.beta_k1 * k1_penalty

        # Reduksi loss per turn (turn-aware reduction)
        return (total_loss * turn_mask).sum() / (turn_mask.sum() + 1e-8)

class RefreshRepairExpandScheduler:
    """
    Mengontrol siklus evolusi kategori expert:
    - Refresh: Evaluasi ulang tingkat keberhasilan instans (mastery)
    - Repair: SFT pada trajektori sukses yang dihasilkan sendiri (self-grounded)
    - Expand: Menambahkan task pada ambang batas frontier eksplorasi
    """
    def __init__(self, target_category: SWECategory):
        self.category = target_category
        self.verified_success_buffer: List[TrajectoryRollout] = []

    def refresh_instance_mastery(self, instance: SWEInstance, rollout_results: List[bool]) -> None:
        instance.current_mastery = sum(rollout_results) / len(rollout_results)

    def select_repair_trajectories(self) -> List[TrajectoryRollout]:
        """Memilih trajektori sukses dari buffer internal tanpa bantuan LLM teacher luar."""
        return [t for t in self.verified_success_buffer if t.is_terminal_success]

    def expand_learning_frontier(
        self, candidate_pool: List[SWEInstance], sample_size: int = 100
    ) -> List[SWEInstance]:
        """
        Memilih task di frontier belajar:
        Task yang memiliki baseline 0.0 < mastery < 0.8 untuk eksplorasi gradien optimal.
        """
        frontier = [
            inst for inst in candidate_pool
            if inst.category == self.category and 0.0 <= inst.current_mastery < 0.8
        ]
        return frontier[:sample_size]

class LabelRoutedMOPD:
    """
    Label-Routed Multi-Teacher On-Policy Distillation:
    Mengonsolidasikan ketiga expert (A, B, C) ke dalam satu student policy.
    Dilengkapi ReLU-Gated Reward Extrapolation.
    """
    def __init__(self, extrapolation_lambda: float = 1.25):
        self.lambd = extrapolation_lambda

    def compute_routed_advantage(
        self,
        student_logprob: float,
        teacher_logprob: float,
        ref_logprob: float,
        is_routed_for_task: bool
    ) -> float:
        """
        Rumus A_t^MOPD = m_k(x) * [ -d_{t,k} + (lambda_k - 1) * max(e_{t,k}, 0) ]
        di mana d_{t,k} = student - teacher, e_{t,k} = teacher - ref.
        """
        if not is_routed_for_task:
            return 0.0

        d_tk = student_logprob - teacher_logprob
        e_tk = teacher_logprob - ref_logprob

        imitation_term = -d_tk
        extrapolation_term = (self.lambd - 1.0) * max(0.0, e_tk)

        return imitation_term + extrapolation_term
4. Menyatukan Tiga Pakar Menjadi Satu: MOPD & ReLU-Gated Reward Extrapolation
Memiliki tiga checkpoint terpisah (Expert A, Expert B, Expert C) tidak praktis untuk penerapan produksi di runtime IDE atau pipeline CI/CD otonom. Model akhir harus berupa satu model tunggal yang siap di-deploy (single deployable student).
Pendekatan penggabungan bobot konvensional (model merging seperti SLERP, DARE, atau Ties-Merging) terbukti gagal total pada tugas penalaran agen, karena merusak struktur penelusuran CoT. Alibaba merancang Label-Routed Multi-Teacher On-Policy Distillation (MOPD):
Di mana:
m_k(x)adalah mask routing satu pintu: tugas Kategori A hanya dibimbing oleh Guru A, Kategori B oleh Guru B, dan Kategori C oleh Guru C.d_{t,k} = q_t - \log \pi_{T_k}(y_t \mid h_t)merepresentasikan celah imitasi (student-teacher imitation gap).e_{t,k} = \log \pi_{T_k}(y_t \mid h_t) - \log \pi_{\mathrm{ref}}(y_t \mid h_t)mengukur arah kemajuan guru dibanding model acuan awal.- Mekanisme
(\lambda_k - 1) \max(e_{t,k}, 0)mengaktifkan ReLU-Gated Reward Extrapolation: jika guru menugaskan probabilitas lebih tinggi daripada model referensi beku, student didorong untuk mengekstrapolasi penalaran lebih jauh dari sekadar imitasi pasif!
5. Hasil Evaluasi Benchmark: Pro-618 & SWE-bench Multilingual
Evaluasi dijalankan menggunakan model dasar Logics-SWE-Qwen3.6-27B pada benchmark audit terverifikasi Pro-618 (221 tugas Pro-A, 201 tugas Pro-B, 196 tugas Pro-C yang telah dibersihkan dari kecacatan environment container) dan SWE-bench Multilingual.
| Arsitektur Model | Pro-A (Service/Sec) | Pro-B (UI/App) | Pro-C (System/Tool) | Pro-618 Full (Mean) | SWE-bench Multilingual |
|---|---|---|---|---|---|
| Base Policy (π0) | 51.74% | 54.39% | 51.87% | 52.65% | 56.22% |
| Pooled RL | 54.75% (+3.01) | 56.72% (+2.33) | 55.10% (+3.23) | 55.50% (+2.85) | 57.48% (+1.26) |
| Balanced RL | 54.45% (+2.71) | 57.05% (+2.66) | 54.59% (+2.72) | 55.34% (+2.69) | 57.10% (+0.88) |
| Individual Experts (Pre-Fusion) | 59.58% (+7.84) | 58.87% (+4.48) | 57.48% (+5.61) | — (Terpisah) | — |
| MOPD Consolidated Model | 58.07% (+6.33) | 59.37% (+4.98) | 56.63% (+4.76) | 58.04% (+5.39) | 59.00% (+2.78) |
Temuan kuantitatif paling impresif meliputi:
- Peningkatan Merata Tanpa Trade-off: MOPD mengungguli Pooled RL sebesar +2.54 pp dan Balanced RL sebesar +2.70 pp secara total, dengan kenaikan positif di setiap kategori: +3.32 pp pada A, +2.65 pp pada B, dan +1.53 pp pada C dibanding Pooled RL.
- Pemulihan Keuntungan Pakar (Expert-Gain Recovery): Model tunggal hasil distilasi MOPD berhasil mempertahankan 80.8% keuntungan Expert A, 84.8% keuntungan Expert C, dan bahkan mencapai 111.1% pada Kategori B (efek super-teacher, di mana student melampaui gurunya berkat regularisasi transfer representasi umum).
- Generalisasi Multibahasa: Pada SWE-bench Multilingual (mencakup repositori Java, Go, C++, JavaScript), kebijakan MOPD melesat menjadi 59.00%, membuktikan bahwa spesialisasi kategori modular menumbuhkan intuisi rekayasa perangkat lunak yang universal lintas sintaksis bahasa.
6. Cetak Biru untuk AI Engineering & Platform Infrastructure
Bagi tim rekayasa AI otonom (seperti tim pengembang Hermes Agent, Claude Code, Cursor, atau sistem coding perusahaan), temuan riset ini menawarkan panduan aksi yang konkret:
Segmentasikan Data Latihan
Jangan melatih model coding dengan mencampur seluruh issue GitHub secara acak. Pasang labeler semantik untuk mengelompokkan issue ke dalam kluster domain (backend/data vs UI/frontend vs low-level tools).
Terapkan Siklus RRE
Hilangkan ketergantungan pada model komersial berbiaya mahal untuk membuat trajektori sintetis. Gunakan rollouts model sendiri yang terbukti lulus pengujian nyata sebagai data Repair SFT.
Distilasi dengan Ekstrapolasi
Hindari merge bobot kasar (weight averaging). Lakukan on-policy distillation terarah per rute tugas dengan penalti K1 dan eksplorasi ekstrapolasi reward ReLU-gated.
Referensi & Sumber Terverifikasi
- [1]One to More, More to One: Category-Aware Iterative Expert Training for Software Engineering Agents(arXiv:2609.23377 [cs.SE / cs.AI] — Jie Zhao, Ziyu Jiang, Suhang Zheng, Minghui Shan, Xiaoxiao Xu, Lin Qu (Alibaba Group))
- [2]Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs (RLOO)(arXiv / Cohere & Google DeepMind (Ahmadian et al., 2024))
- [3]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 / Princeton University (Jimenez et al., 2024))
- [4]On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes (MOPD / OPD)(arXiv / Google Research (Agarwal et al., 2023))
- [5]SWE-bench Pro: Can Language Model Agents Solve Difficult Production Software Engineering Issues?(arXiv / Scale AI & Princeton (Deng et al., 2026))
- [6]CodeMidas 2026: Arsitektur Penskalaan Lingkungan RL Coding Agent Langsung dari Kode Sumber(arXiv:2609.22068 / NEWSAINT Systems Architecture Review)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.