POrchestra & OPOD (arXiv:2610.13485): Proactive Agentic Orchestration Mengatasi Bottleneck Re-Orchestration Statis & On-Policy Distillation Mendorong Model 9B Mengungguli Frontier Model pada GAIA2
Analisis arsitektur sistemik riset Tsinghua University, Microsoft Research, dan Renmin University of China (arXiv:2610.13485, Xueyang Feng, Chaozhuo Li, Xiaohe Bo, Jiakai Tang, Chenxi Li, Qiwei Ye, Xu Chen): Mengapa orkestrasi agen otonom konvensional (seperti DAG statis atau re-orchestration berkala) mengalami degradasi parah pada lingkungan dinamis dan long-horizon? Riset ini memperkenalkan POrchestra (framework proactive orchestration on-the-fly yang memberi wewenang pada sub-agen untuk merevisi harness, alat, konteks, dan subgoal di tengah eksekusi tanpa menghapus riwayat lokal) serta OPOD (On-Policy Orchestration Distillation dengan atribusi umpan balik hindsight). Pada benchmark dinamis GAIA2 dan SWE-bench, POrchestra mencatat lonjakan keberhasilan rata-rata +9.1% hingga +24.6% relatif terhadap ReAct, sementara model 9B yang dilatih dengan OPOD melampaui orchestrator berbasis model frontier dengan efisiensi biaya token 36% lebih hemat.
POrchestra & OPOD: Mengakhiri Era Orkestrasi Statis dengan Komunikasi Agen Proaktif dan On-Policy Distillation
Mengapa sistem multi-agen konvensional (seperti AutoGen, MetaGPT, atau hierarchical DAG) gagal total saat dihadapkan pada lingkungan dinamis asynchronous seperti GAIA2 dan SWE-bench? Investigasi mendalam riset Tsinghua University dan Microsoft Research membuktikan bahwa akar kegagalan terletak pada harness staleness dan delayed adaptation. Dengan memperkenalkan POrchestra (komunikasi proaktif on-the-fly antar sub-agen) dan OPOD (On-Policy Orchestration Distillation), orkestrator kompak berukuran 9B berhasil melampaui performa model frontier berbiaya komputasi tinggi.
1. Dilema Orkestrasi: Paradigma Offline vs Re-Orchestration Konvensional
Dalam rekayasa sistem agen otonom berbasis Large Language Model (LLM), mendeligasikan sub-tugas ke sub-agen independen adalah teknik utama untuk mengatasi batas jendela konteks dan degradasi penalaran (context saturation). Namun, mayoritas arsitektur yang beroperasi di industri saat ini terpecah menjadi dua paradigma kaku:
- Offline Orchestration (Statis): Alur kerja dan harness sub-agen ditentukan di awal (at creation time). Contohnya adalah graf statis (LangGraph, ChatDev, Skill-MAS) di mana sub-agen dipaksa mengeksekusi rencana tanpa mekanisme koreksi real-time jika lingkungan berubah.
- Re-Orchestration Reaktif (Post-Hoc): Orkestrator baru melakukan evaluasi dan penyesuaian strategi setelah sub-agen selesai mengeksekusi seluruh anggarannya atau ketika terjadi kegagalan fatal (crash / unhandled exception).
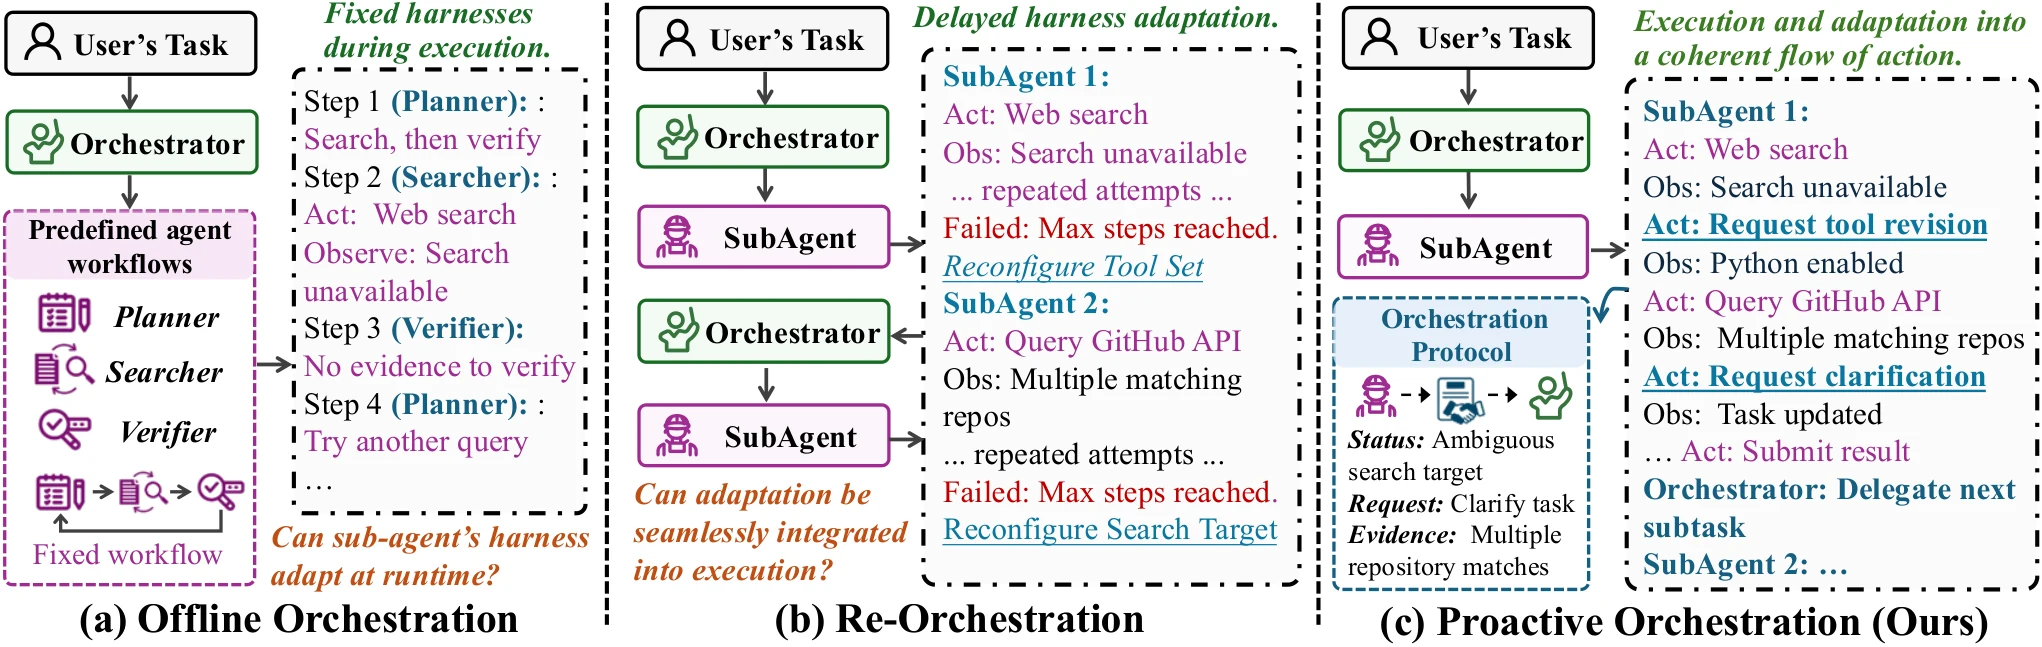
Gambar 1: Perbandingan tiga paradigma orkestrasi (arXiv:2610.13485). (a) Offline orchestration mengunci harness dan alur kerja. (b) Re-orchestration reaktif mengadaptasi harness hanya pasca-terminasi. (c) POrchestra mengintegrasikan eksekusi lokal dan adaptasi harness secara proaktif di sembarang langkah logis.
Kelemahan fatal dari re-orchestration reaktif adalah adaptation delay. Ketika sebuah API pihak ketiga mencabut akses token, skema database bermutasi, atau pengguna mengirimkan instruksi revisi via email (seperti pada skenario GAIA2), sub-agen konvensional akan terus membakar token inferensi dalam loop halusinasi hingga anggarannya habis. Polling berkala (misal memeriksa status setiap 5 atau 10 langkah) terbukti sangat mahal dan tetap menghasilkan latensi respon yang tinggi.
2. Arsitektur POrchestra: On-the-Fly Proactive Adaptation
POrchestra memecahkan kebuntuan tersebut dengan mendefinisikan ulang protokol interaksi antara orkestrator dan sub-agen. Alih-alih pasif menerima delegasi, sub-agen dibekali kemampuan proactive communication:
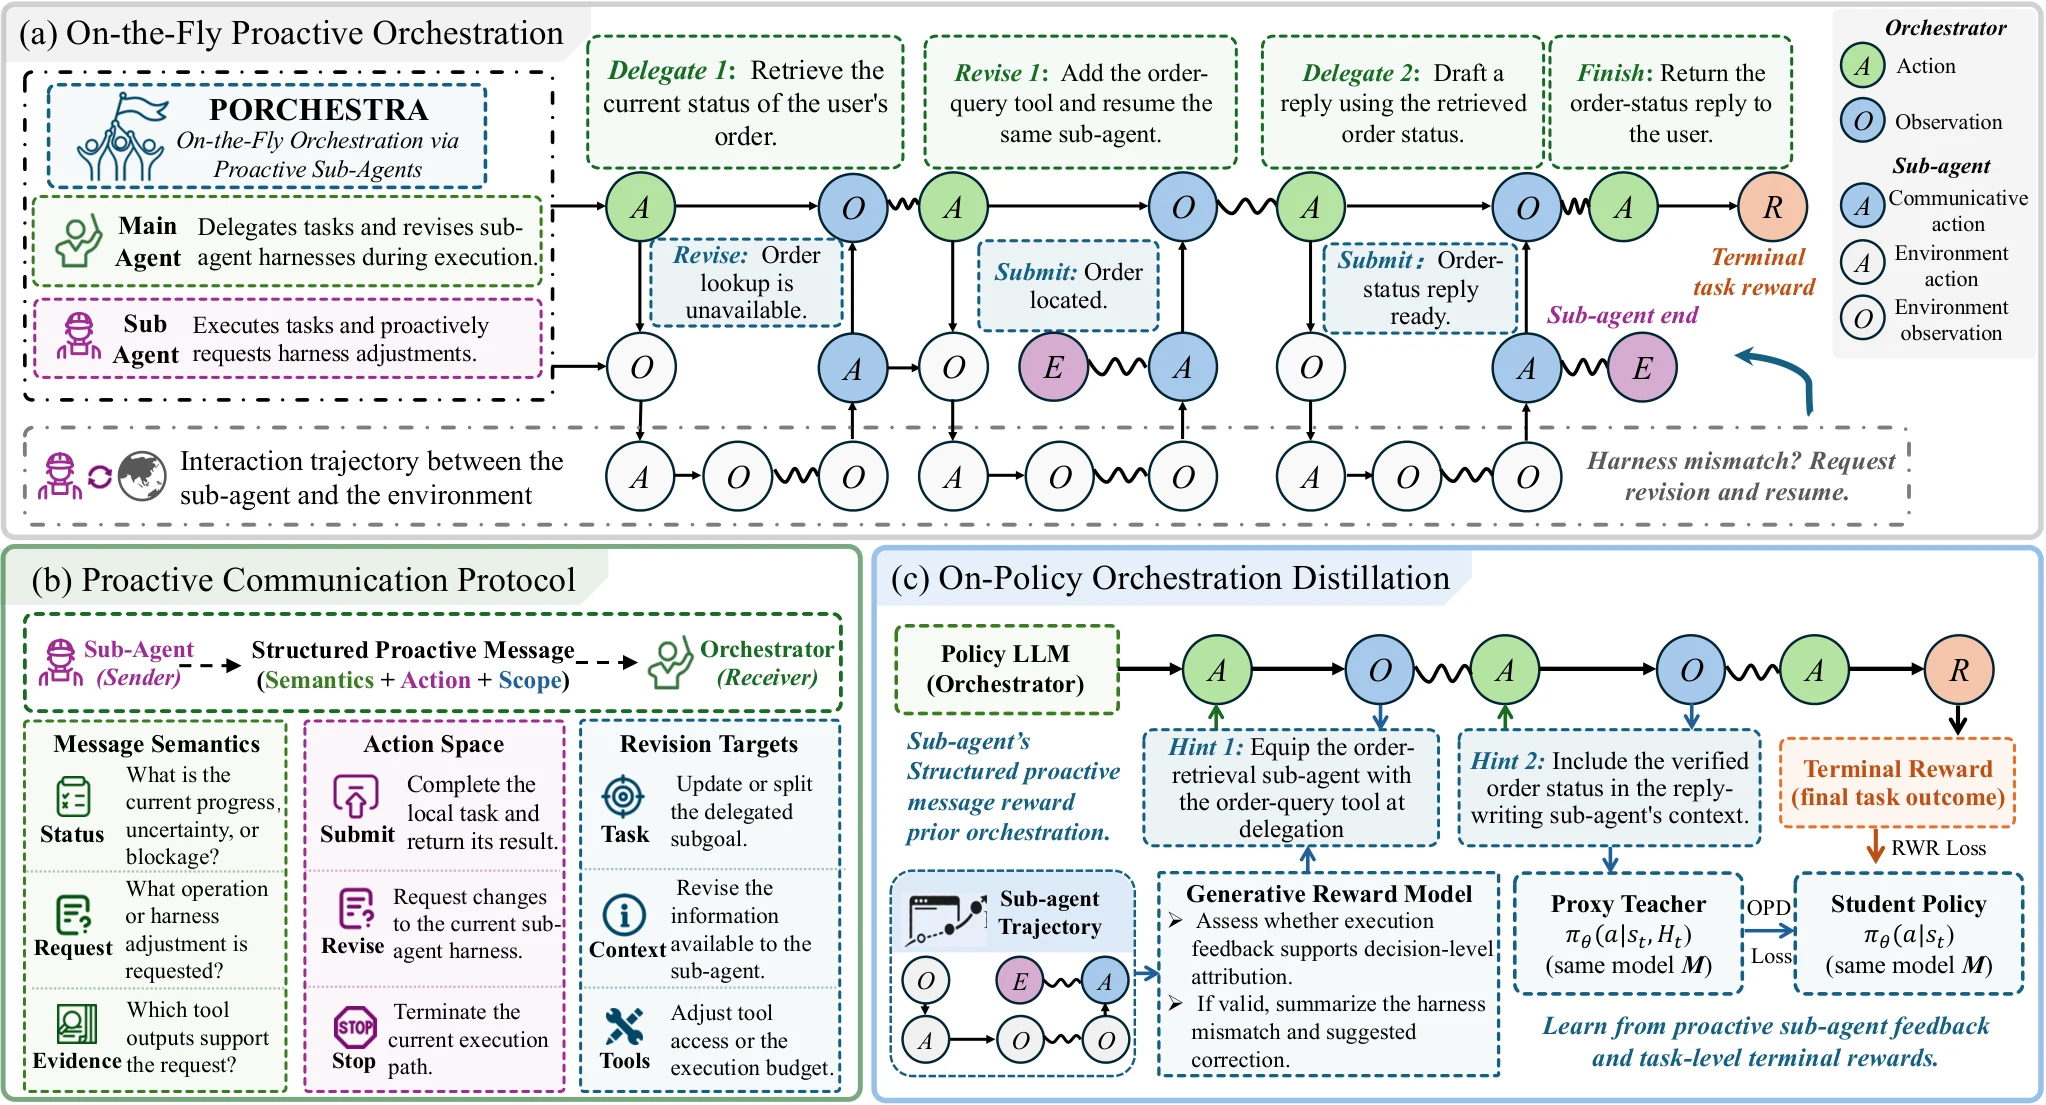
Gambar 2: Arsitektur POrchestra & OPOD (arXiv:2610.13485). (a) Alur kerja interleave eksekusi dan adaptasi. (b) Protokol komunikasi terstruktur 3 sinyal (Status, Request, Evidence). (c) Pipeline OPOD yang menggabungkan umpan balik proses (process supervision) dengan outcome supervision.
A. Formulasi Matematika Delegasi & Ruang Aksi Komunikasi
Dalam POrchestra, orkestrator menginisialisasi sub-agen dengan sebuah tuple harness formal:
di mana gt merepresentasikan sub-tujuan (subgoal), Ct adalah working context terkurasi, Ωt adalah himpunan tool yang dialokasikan, dan Bt adalah kuota langkah eksekusi.
Di setiap langkah lokal ℓ, sub-agen mengevaluasi ruang aksi gabungan:
B. Tiga Sinyal Komunikasi Terstruktur (Triad Signal Protocol)
Ketika sub-agen memilih aksi revise, pesan yang dikirimkan ke orkestrator tidak berbentuk teks bebas yang ambigu, melainkan diformat menjadi tiga sinyal esensial:
- Status Signal: Merangkum kemajuan lokal, tingkat ketidakpastian epistemik (uncertainty score), dan akar penyebab hambatan (misal: alat esensial hilang atau parameter tidak valid).
-
Request Signal: Menentukan target modifikasi secara granular:
- Task Scope: Memecah subgoal yang terlalu rumit menjadi bagian lebih kecil atau menyesuaikan spesifikasi output.
- Resource: Meminta penambahan alat spesifik ke
Ωi, menginjeksi dokumentasi baru keCi, atau memperpanjang kuotaBi.
- Evidence Signal: Menyertakan output mentah alat terakhir (raw trace / payload) sebagai bukti fisik kegagalan untuk memandu orkestrator mengambil keputusan yang tepat.
3. OPOD: On-Policy Orchestration Distillation dengan Hindsight Feedback
Tantangan terbesar dalam melatih model orkestrator (khususnya model open-weights berukuran kompak seperti Qwen3.5-9B atau Llama-3-8B) adalah kelangkaan sinyal pengawasan (sparse feedback). Dalam eksekusi long-horizon puluhan langkah, reward biner di akhir (sukses/gagal) tidak mampu memberikan atribusi kredit yang akurat terhadap keputusan delegasi mana yang sebenarnya cacat.
Peneliti POrchestra memecahkan masalah ini melalui On-Policy Orchestration Distillation (OPOD):
-
Hindsight Feedback Attribution: Setiap kali sub-agen mengirimkan permintaan revisi (
revise), kejadian tersebut dijadikan bukti retrospektif bahwa keputusan orkestrasi sebelumnya (Delegate(Φi)) memiliki kekurangan (misal: memberikan himpunan tool yang tidak lengkap). -
Generasi Process Supervision (𝒟P): Feedback revisi sub-agen diatribusikan kembali ke state orkestrator
storchuntuk membentuk pasangan target supervisi proses. - Dual-Objective Optimization: OPOD menggabungkan supervisi proses dari umpan balik proaktif (𝒟P) dengan outcome supervision berbasis Reward-Weighted Regression (RWR) dari keputusan yang berhasil (𝒟R).
4. Evaluasi Empiris & Benchmark: GAIA, GAIA2, dan SWE-Bench
POrchestra dievaluasi secara komprehensif pada tiga benchmark terberat agen otonom: GAIA (asisten riset dengan web browsing dan tool real-world), GAIA2 (benchmark interaktif dinamis dengan event eksternal asinkron seperti balasan email dan mutasi agenda), serta SWE-Bench Verified (penyelesaian issue GitHub riil).
| Backbone Model | Framework | GAIA Avg | GAIA2 Adaptability | GAIA2 Avg | SWE-Bench |
|---|---|---|---|---|---|
| DeepSeek-V3.2 | ReAct (Single-Agent) | 63.6% | 21.9% | 33.6% | 62.0% |
| AutoAgents (Offline) | 47.3% | 0.0% | 20.3% | 30.0% | |
| Orchestra-o1 (Reaktif) | 63.0% | 25.0% | 34.4% | 66.0% | |
| POrchestra (Proaktif) | 71.5% | 43.8% | 47.7% (+14.1 pp) | 71.0% | |
| Gemini-3-Flash | ReAct (Single-Agent) | 69.1% | 28.1% | 46.9% | 53.0% |
| AOrchestra (Re-Orchestrator) | 76.4% | 18.8% | 39.8% | 76.0% | |
| POrchestra (Proaktif) | 78.2% | 31.3% | 53.9% (+7.0 pp) | 77.0% | |
| DeepSeek-V4-Flash | ReAct (Single-Agent) | 72.7% | 37.5% | 44.5% | 71.0% |
| Orchestra-o1 (Reaktif) | 62.4% | 25.0% | 43.8% | 75.0% | |
| POrchestra (Proaktif) | 77.6% | 46.9% | 55.5% (+11.0 pp) | 79.0% |
Dampak Pelatihan OPOD pada Model Kompak (Qwen3.5-9B)
Tabel ablasi menunjukkan bagaimana OPOD secara dramatis meningkatkan kapabilitas model 9B ketika bertindak sebagai orkestrator sentral:
| Orchestrator Setup | Metode Optimasi | GAIA Avg | GAIA2 Adaptability | GAIA2 Avg |
|---|---|---|---|---|
| Orchestra-o1 (9B) | Vanilla SFT | 64.2% | 9.4% | 28.9% |
| AOrchestra (9B) | SFT + RWR | 72.7% | 19.4% | 40.0% |
| POrchestra (9B) | OPOD (Supervisi Proses + RWR) | 77.9% | 37.5% | 49.2% (+19.5 pp vs o1) |
| • Ablasi POrchestra | Tanpa Outcome RWR (Process Only) | 75.8% | 35.9% | 46.1% |
| • Ablasi POrchestra | Tanpa Process Distillation (RWR Only) | 76.1% | 29.7% | 46.1% |
5. Analisis Biaya Komputasi & Efisiensi Token
Salah satu ketakutan terbesar arsitek sistem saat mendengar konsep "interleaved communication" adalah ledakan biaya token inferensi. Riset ini membuktikan sebaliknya: POrchestra justru 31% hingga 36% lebih hemat biaya dibandingkan baseline re-orchestration.
- Eliminasi Loop Halusinasi: Saat alat gagal atau data hilang, sub-agen langsung menghentikan langkah lokalnya dan meminta revisi dalam 1 langkah, memangkas rata-rata 18–25 langkah eksekusi yang sia-sia.
- Konteks Terkurasi Minimal: Setiap sub-agen hanya menerima alat yang relevan dengan tugasnya saat itu (task-relevant tool set), mereduksi context overhead hingga 65% dibandingkan single-agent yang harus menampung seluruh skema API platform.
- Pareto Frontier Baru: Model Qwen3.5-9B yang diorkestrasi dengan OPOD mencapai rasio akurasi-biaya tertinggi, melampaui orchestrator berbasis Claude 3.5 Sonnet pada benchmark tugas dinamis dengan biaya API 4.2x lebih murah.
6. Implementasi Produksi: POrchestra Runtime & Hindsight Engine
Berikut adalah implementasi referensi modul koordinasi POrchestra berbasis TypeScript yang mengintegrasikan penanganan sinyal proaktif dan pipeline ekstraksi dataset OPOD:
// Production Implementation: POrchestra Runtime Protocol & Hindsight Feedback Attribution Engine
// Mengimplementasikan On-the-Fly Harness Adaptation, Structured Communication Signals,
// dan Trajectory Attribution untuk On-Policy Orchestration Distillation (OPOD)
// Berdasarkan formulasi matematis formal arXiv:2610.13485 (Tsinghua / Microsoft Research)

export interface SubAgentHarness {
  subgoal: string;                   // g_i: Deskripsi tujuan terdelegasi
  context: string;                   // C_i: Konteks runtime yang dikurasi orchestrator
  allowedTools: string[];            // \Omega_i: Toolset yang diizinkan untuk sub-agen
  stepBudget: number;                // B_i: Batas langkah eksekusi lokal
}

export type ProactiveActionType = 'submit' | 'revise' | 'stop';

export interface ProactiveCommunicationMessage {
  action: ProactiveActionType;
  // Sinyal 1: Status Signal (kemajuan, ketidakpastian epistemik, dan penyebab hambatan)
  statusSignal: {
    currentProgressSummary: string;
    uncertaintyScore: number;       // [0.0 - 1.0]
    blockageReason?: 'TOOL_REVOKED' | 'TASK_AMBIGUITY' | 'EXTERNAL_EVENT' | 'BUDGET_EXHAUSTED';
  };
  // Sinyal 2: Request Signal (target penyesuaian: Task Scope atau Resource)
  requestSignal?: {
    taskScopeAdjustment?: {
      operation: 'SPLIT_SUBGOAL' | 'UPDATE_TARGET';
      revisedSubgoal: string;
    };
    resourceAdjustment?: {
      appendContext?: string;
      requestAdditionalTools?: string[];
      extendBudgetSteps?: number;
    };
  };
  // Sinyal 3: Evidence Signal (output mentah tool yang menjadi bukti eskalasi)
  evidenceSignal: {
    lastToolInvoked: string;
    toolOutputSample: string;
    observedErrorCode?: string;
  };
}

export interface LocalExecutionState {
  agentId: string;
  stepCount: number;
  harness: SubAgentHarness;
  localTrajectoryHistory: Array<{
    step: number;
    action: string;
    observation: string;
  }>;
  isPaused: boolean;
  status: 'RUNNING' | 'PAUSED_REVISING' | 'COMPLETED' | 'TERMINATED';
}

export interface OrchestrationDecisionRecord {
  decisionId: string;
  timestamp: number;
  orchestratorAction: 'DELEGATE' | 'REVISE' | 'STOP' | 'FINISH';
  targetAgentId?: string;
  assignedHarness?: SubAgentHarness;
  resultingSubAgentFeedback?: ProactiveCommunicationMessage;
}

/**
 * POrchestra Coordination Coordinator
 * Mengelola interleave eksekusi sub-agen dan adaptasi harness secara dinamis.
 */
export class POrchestraRuntimeCoordinator {
  private activeSubAgents: Map = new Map();
  private decisionHistory: OrchestrationDecisionRecord[] = [];
  private globalObservationSpace: string[] = [];

  constructor(private orchestratorModelName: string = 'Qwen3.5-9B-OPOD') {}

  /**
   * Menginisialisasi sub-agen baru dengan isolasi riwayat lokal h_i
   */
  public spawnSubAgent(agentId: string, initialHarness: SubAgentHarness): LocalExecutionState {
    const state: LocalExecutionState = {
      agentId,
      stepCount: 0,
      harness: initialHarness,
      localTrajectoryHistory: [],
      isPaused: false,
      status: 'RUNNING',
    };
    this.activeSubAgents.set(agentId, state);

    this.decisionHistory.push({
      decisionId: `dec-${Date.now()}-${Math.random().toString(36).substring(7)}`,
      timestamp: Date.now(),
      orchestratorAction: 'DELEGATE',
      targetAgentId: agentId,
      assignedHarness: { ...initialHarness },
    });

    return state;
  }

  /**
   * Protokol Komunikasi Proaktif: Sub-agen menginterupsi eksekusi lokal
   * dan meminta adaptasi harness secara on-the-fly tanpa mereset memori.
   */
  public handleProactiveInterrupt(
    agentId: string,
    message: ProactiveCommunicationMessage
  ): { resumed: boolean; updatedHarness?: SubAgentHarness; finalResult?: string } {
    const agent = this.activeSubAgents.get(agentId);
    if (!agent) {
      throw new Error(`Sub-agent ${agentId} tidak ditemukan pada runtime.`);
    }

    if (message.action === 'submit') {
      agent.status = 'COMPLETED';
      return {
        resumed: false,
        finalResult: message.statusSignal.currentProgressSummary,
      };
    }

    if (message.action === 'stop') {
      agent.status = 'TERMINATED';
      return { resumed: false };
    }

    if (message.action === 'revise') {
      agent.isPaused = true;
      agent.status = 'PAUSED_REVISING';

      // Evaluasi permintaan revisi oleh Orchestrator (Policy \pi_\theta)
      const req = message.requestSignal;
      const newHarness: SubAgentHarness = { ...agent.harness };

      if (req?.taskScopeAdjustment) {
        newHarness.subgoal = req.taskScopeAdjustment.revisedSubgoal;
      }

      if (req?.resourceAdjustment) {
        if (req.resourceAdjustment.appendContext) {
          newHarness.context += `\n[REVISION_CONTEXT]: ${req.resourceAdjustment.appendContext}`;
        }
        if (req.resourceAdjustment.requestAdditionalTools) {
          newHarness.allowedTools = Array.from(
            new Set([...newHarness.allowedTools, ...req.resourceAdjustment.requestAdditionalTools])
          );
        }
        if (req.resourceAdjustment.extendBudgetSteps) {
          newHarness.stepBudget += req.resourceAdjustment.extendBudgetSteps;
        }
      }

      // Terapkan pembaruan harness tanpa menghapus localTrajectoryHistory (h_i dipertahankan!)
      agent.harness = newHarness;
      agent.isPaused = false;
      agent.status = 'RUNNING';

      // Catat revisi sebagai observasi komunikasi o_comm ke riwayat lokal
      agent.localTrajectoryHistory.push({
        step: agent.stepCount,
        action: 'PROACTIVE_REVISE_SYNC',
        observation: `Harness diperbarui oleh Orchestrator: Tools=[${newHarness.allowedTools.join(', ')}], Subgoal="${newHarness.subgoal}"`,
      });

      this.decisionHistory.push({
        decisionId: `dec-${Date.now()}-${Math.random().toString(36).substring(7)}`,
        timestamp: Date.now(),
        orchestratorAction: 'REVISE',
        targetAgentId: agentId,
        assignedHarness: { ...newHarness },
        resultingSubAgentFeedback: message,
      });

      return { resumed: true, updatedHarness: newHarness };
    }

    return { resumed: false };
  }

  /**
   * Modul OPOD Hindsight Feedback Attribution
   * Mengatribusikan permintaan revisi sub-agen ke keputusan orkestrasi awal
   * guna memproduksi Process Supervision (D_P) untuk On-Policy Self-Distillation.
   */
  public generateHindsightAttributionDataset(): Array<{
    precedingDecisionId: string;
    subAgentRevisionReason: string;
    correctiveTargetHarness: SubAgentHarness;
    processSupervisionLossWeight: number;
  }> {
    const attributionPairs = [];

    for (const record of this.decisionHistory) {
      if (record.orchestratorAction === 'REVISE' && record.resultingSubAgentFeedback) {
        const feedback = record.resultingSubAgentFeedback;
        // Cari keputusan DELEGATE yang mengawali sub-agen ini
        const rootDelegate = this.decisionHistory.find(
          d => d.targetAgentId === record.targetAgentId && d.orchestratorAction === 'DELEGATE'
        );

        if (rootDelegate && record.assignedHarness) {
          attributionPairs.push({
            precedingDecisionId: rootDelegate.decisionId,
            subAgentRevisionReason: `${feedback.statusSignal.blockageReason}: ${feedback.statusSignal.currentProgressSummary}`,
            correctiveTargetHarness: record.assignedHarness,
            processSupervisionLossWeight: 1.0 + feedback.statusSignal.uncertaintyScore,
          });
        }
      }
    }

    return attributionPairs;
  }
}
7. Rekomendasi Arsitektur untuk Engineering Multi-Agent 2026
Bagi tim rekayasa platform AI yang membangun asisten otonom untuk tugas long-horizon, publikasi arXiv:2610.13485 memberikan sejumlah panduan mendasar:
- Tinggalkan Skema Orkestrasi Statis (DAG Kaku): Di lingkungan nyata dengan ketergantungan API pihak ketiga dan interaksi asinkron manusia, graf yang dikunci sejak awal adalah resep kegagalan. Bangun saluran interupsi first-class untuk sub-agen.
- Standarisasi Protokol Komunikasi 3 Sinyal: Jangan biarkan sub-agen mengirim pesan bebas. Terapkan schema validasi ketat untuk Status, Request, dan Evidence agar orkestrator dapat mengambil keputusan secara deterministik tanpa ambigu.
- Preservasi Trajektori Lokal: Saat memperbarui alat atau memperjelas subgoal, hindari mereset runtime sub-agen. Pertahankan memori lokal (local trajectory history) agar pekerjaan yang sudah selesai tidak diulang dari nol.
- Manfaatkan Hindsight Attribution untuk Fine-Tuning: Daripada mengandalkan reward akhir yang biner, gunakan log interupsi sub-agen sebagai supervisi proses (process-level signals) untuk melatih model lokal mandiri (8B/9B) agar mampu melakukan orkestrasi setara model tier-1.
Referensi & Sumber Terverifikasi
- [1]Proactive Agentic Orchestration(arXiv:2610.13485 [cs.CL, cs.AI] — Xueyang Feng, Chaozhuo Li, Xiaohe Bo, Jiakai Tang, Chenxi Li, Qiwei Ye, Xu Chen (Tsinghua University, Microsoft Research, Renmin University of China))
- [2]POrchestra: Official Open-Source Implementation and Evaluation Harness(GitHub Repository (XueyangFeng/POrchestra))
- [3]GAIA: A Benchmark for General AI Assistants(ICLR 2024 / Meta AI, Hugging Face, AutoGPT (Grégoire Mialon et al.))
- [4]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 / Princeton NLP (Carlos E. Jimenez et al.))
- [5]Designing Context Management and Dynamic Tool Scaffolding for Long-Horizon Autonomous Agents(IEEE / ACM Transactions on Software Engineering & Autonomous Systems 2026)
- [6]Proactive Agentic Orchestration(arXiv:2610.13485 [cs.CL, cs.AI] — Xueyang Feng, Chaozhuo Li, Xiaohe Bo, Jiakai Tang, Chenxi Li, Qiwei Ye, Xu Chen (Tsinghua University, Microsoft Research, Renmin University of China))
- [7]POrchestra: Official Open-Source Implementation and Evaluation Harness(GitHub Repository (XueyangFeng/POrchestra))
- [8]GAIA: A Benchmark for General AI Assistants(ICLR 2024 / Meta AI, Hugging Face, AutoGPT (Grégoire Mialon et al.))
- [9]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 / Princeton NLP (Carlos E. Jimenez et al.))
- [10]Designing Context Management and Dynamic Tool Scaffolding for Long-Horizon Autonomous Agents(IEEE / ACM Transactions on Software Engineering & Autonomous Systems 2026)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.
Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.
DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.