RetireOPD 2026: Arsitektur Self-Retiring On-Policy Distillation & Decoupled Skill Teachers untuk Mengatasi Ceiling Reinforcement Learning pada Autonomous LLM Agents
Bedah arsitektur riset frontier arXiv:2609.20784 (September 2026, Zhejiang University): Mengapa on-policy distillation dengan guru berkemampuan khusus (privileged skill teacher) kerap mengalami stagnasi dan membatasi eksplorasi agen otonom. RetireOPD menghadirkan paradigma Decoupled Skill-Conditioned Teacher Optimization dengan GRPO serta gerbang Adaptive Retirement berbasis dinamika penurunan celah probabilitas token (ρ_m^(K) ≥ δ) dan rasio kompetensi relatif (η_m ≥ γ). Pada benchmark ALFWorld dan WebShop, agen siswa tanpa skill berhasil melampaui performa gurunya sendiri dengan lonjakan akurasi hingga +18.8 poin di atas baseline RL standar tanpa overhead token saat inferensi.
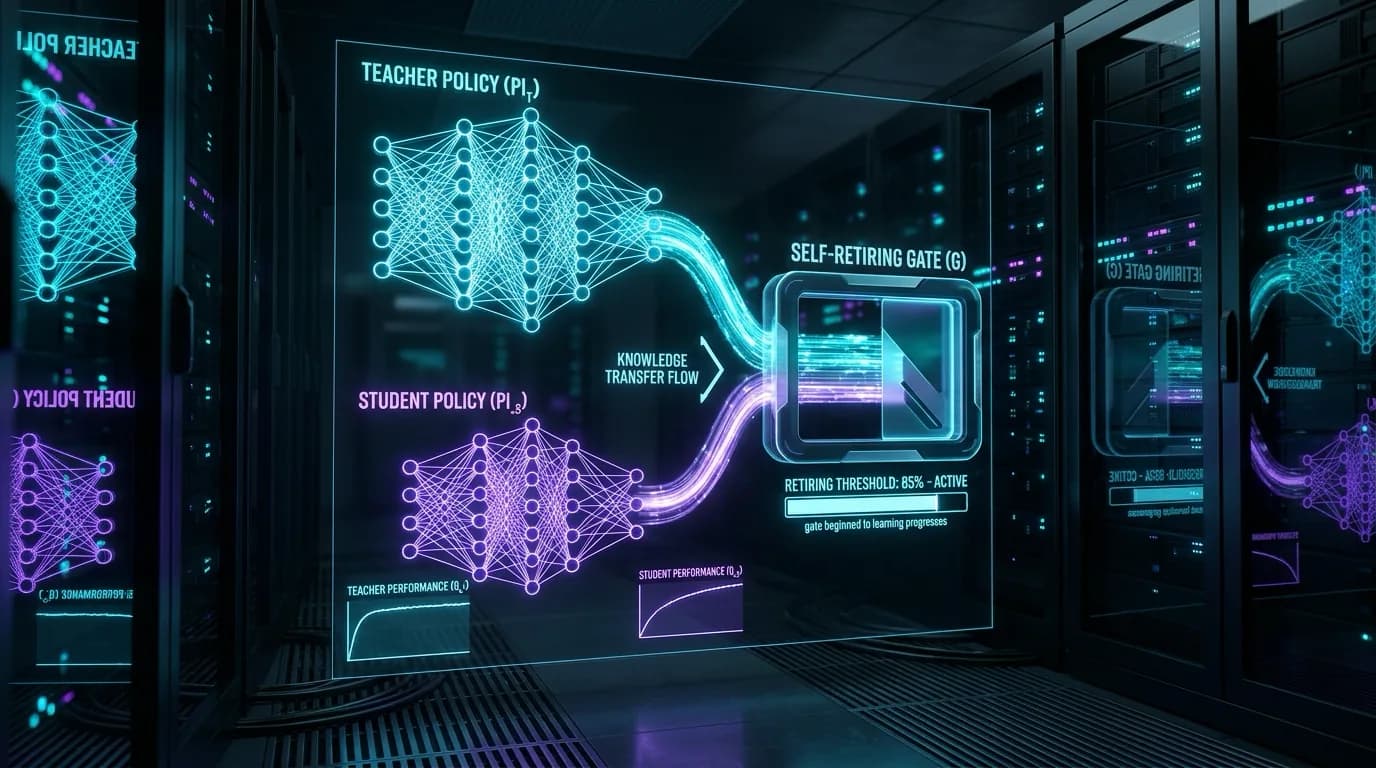
Dalam lanskap pengembangan agen otonom berbasis model bahasa besar (Autonomous LLM Agents), proses post-training dengan reinforcement learning (RL) menghadapi rintangan mendasar: interaksi multi-langkah (multi-turn decision making) hanya menerima satu sinyal scalar reward di akhir lintasan (trajectory). Ketiadaan umpan balik padat di tingkat token (token-level dense feedback) mengakibatkan eksplorasi berlatensi tinggi, varians gradien ekstrem, dan kegagalan konvergensi pada lingkungan kompleks seperti navigasi sistem operasi, pencarian e-commerce, atau perbaikan kode repositori.
Executive Architectural Brief & Penemuan Riset (arXiv:2609.20784)
Dipublikasikan pada September 2026 oleh tim peneliti Zhejiang University (Yan Yu, Zhengxi Lu, Weiming Lu, Yongliang Shen, dkk.), riset bertajuk "RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning" mengungkap anomali kritis dalam paradigma distilasi agen otonom: privileged context berupa keahlian manual (skill manuals) semata tidak serta-merta menjadikan model guru andal, dan bimbingan guru memiliki fase kadaluwarsa (stage-dependent efficacy). Memaksakan distilasi on-policy sepanjang masa pelatihan justru mengekang kapasitas eksplorasi model siswa. Melalui pemisahan optimasi guru berketerampilan khusus (Decoupled Skill-Conditioned Teacher via GRPO) dan mekanisme gerbang pemensiunan otomatis (Adaptive Teacher Retirement), RetireOPD membebaskan model siswa tanpa skill untuk melampaui performa gurunya sendiri (super-teacher generalization), mencatatkan rekor akurasi hingga 93.8% di ALFWorld (+18.8 pp) dan 75.8% di WebShop (+19.0 pp) pada model famili Qwen2.5.
1. Paradoks Guru Istimewa & Jebakan Distilasi Statis pada Agentic RL
Untuk mengatasi kelangkaan reward (sparse trajectory rewards), literatur modern mengandalkan On-Policy Distillation (OPD) atau On-Policy Self-Distillation (OPSD). Pada arsitektur ini, model guru diberikan konteks istimewa berupa keterampilan eksplisit $c^+$ (seperti aturan transisi environment, panduan manipulasi objek, atau template tindakan API), lalu memandu model siswa yang tidak memiliki akses ke $c^+$. Harapannya, siswa dapat menginternalisasi pola tindakan tingkat lanjut tanpa perlu menyertakan manual skill yang menghabiskan token konteks saat inferensi di lingkungan produksi.
Akan tetapi, investigasi empiris mendalam Yu et al. (2026) mengungkap dua kegagalan struktural dari paradigma konvensional:
Privileged Context Incompetence
Memberikan teks instruksi $c^+$ pada prompt model dasar (prompt-based teacher) tanpa proses fine-tuning RL tidak menjamin keandalan tindakan. Model kerap berhalusinasi atau salah menginterpretasikan instruksi simbolik di lingkungan non-deterministik. Pada Qwen2.5-1.5B di ALFWorld, menambahkan skill pada prompt hanya menghasilkan keberhasilan 6.2%, dan distilasi langsung dari guru yang belum teroptimasi (GRPO+OPSD) mandek di angka 72.7%.
The Teacher Ceiling Dilemma
Supervisi guru bertindak laksana roda bantu sepeda: sangat krusial pada fase awal (early bootstrapping) agar agen tidak tersesat dalam ruang tindakan acak. Namun ketika siswa telah mencapai pemahaman dasar, distribusi probabilitas guru berubah menjadi belenggu optimasi (policy constraint). Gradien distilasi Kullback-Leibler memaksa siswa meniru lintasan guru yang sub-optimal, melarang siswa mengeksplorasi rute pintas baru yang menghasilkan reward lingkungan lebih tinggi.
2. Arsitektur RetireOPD: Formulasi Matematis & Mekanisme Tiga Pilar
RetireOPD memecahkan dilema tersebut melalui pemisahan siklus hidup pelatihan menjadi tiga pilar matematis terpadu:
Decoupled Teacher GRPO
Alih-alih memakai model dasar mentah, kebijakan guru $\pi_\phi$ dioptimasi secara terpisah menggunakan Group Relative Policy Optimization (GRPO) berbekal konteks $c^+$, mentransformasikan informasi manual menjadi keunggulan perilaku deterministik ber-success rate tinggi ($SR_T$).
Joint GRPO-OPD Objective
Kebijakan siswa $\pi_\theta$ dilatih tanpa akses $c^+$. Siswa belajar secara simultan dari imbalan lingkungan melalui fungsi objektif GRPO dan supervisi halus tingkat token melalui penalti divergensi KL on-policy terhadap guru $\pi_T$.
Adaptive Teacher Retirement
Sistem memonitor dinamika penyusutan jarak probabilitas token $\rho_m^{(K)}$ dan rasio kompetensi relatif $\eta_m$ dalam jendela berjalan $W$. Begitu syarat terpenuhi, bobot $\lambda \to 0$, mempensiunkan guru dan mengizinkan siswa berinovasi murni via RL.
Formulasi Kerugian Gabungan (Joint Objective Formulation)
Dalam setiap iterasi pelatihan siswa, untuk sebuah tugas $x \sim \mathcal{D}$, sistem mengambil sampel grup $G$ lintasan $\{\tau^{(i)}\}_{i=1}^G$ dari kebijakan siswa saat ini $\pi_\theta$, di mana setiap lintasan memiliki imbalan skalar lingkungan $R(\tau^{(i)})$. Skor keunggulan dihitung secara ternormalisasi tanpa ketergantungan model pengkritik terpisah (critic-free group relative advantage):
\hat{A}^{(i)} = \frac{R(\tau^{(i)}) - \operatorname{Mean}\big(\{R(\tau^{(i)})\}_{i=1}^G\big)}{\operatorname{std}\big(\{R(\tau^{(i)})\}_{i=1}^G\big)}
Kerugian optimasi siswa menggabungkan tujuan GRPO terpotong (clipped surrogate objective) dengan kerugian distilasi on-policy (OPD):
\mathcal{L}_{\mathrm{student}}(\theta) = \mathcal{L}_{\mathrm{GRPO}}(\theta) + \lambda \,\mathcal{L}_{\mathrm{OPD}}(\theta)
di mana komponen GRPO dirumuskan sebagai:
\mathcal{L}_{\mathrm{GRPO}}(\theta) = -\mathbb{E}\left[ \frac{1}{G} \sum_{i=1}^G \frac{1}{|y^{(i)}|} \sum_{t=1}^{|y^{(i)}|} \min\!\Big( r_t^{(i)}(\theta) \hat{A}^{(i)}, \,\operatorname{clip}\big(r_t^{(i)}(\theta), 1-\epsilon, 1+\epsilon\big)\hat{A}^{(i)} \Big) \right]
dan komponen OPD mengukur divergensi token dari guru terlatih $\pi_T$:
\mathcal{L}_{\mathrm{OPD}}(\theta) = \mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi_\theta(\cdot\mid x)}\left[ \frac{1}{|y|}\sum_{t=1}^{|y|} D_{\mathrm{KL}}\big(\pi_\theta(\cdot\mid x, y_{<t}) \,\big\|\, \pi_T(\cdot\mid x, c^+, y_{<t})\big) \right]
Mekanisme Gerbang Pensiun Adaptif (Adaptive Retirement Gate)
Jadwal annealing statis konvensional (seperti peluruhan linear $\lambda$ berdasarkan langkah waktu tetap) gagal mengantisipasi perbedaan kecepatan belajar model pada berbagai ukuran kapasitas parameter. RetireOPD mendefinisikan celah log-probabilitas token per langkah $n$:
\Delta_t^{(i)} = \log \pi_T(y_t^{(i)} \mid x, c^+, y_{<t}^{(i)}) - \log \pi_\theta(y_t^{(i)} \mid x, y_{<t}^{(i)})
Data ini dikompilasi ke dalam kemajuan keselarasan per langkah $K_n$ dan rata-rata jendela pemantauan $\bar{K}_m$ dengan panjang jendela $W$ langkah:
K_n = \frac{1}{G} \sum_{i=1}^G \frac{1}{|y_n^{(i)}|} \sum_{t=1}^{|y_n^{(i)}|} \Delta_t^{(i)}, \qquad \bar{K}_m = \frac{1}{W} \sum_{n=mW}^{mW+W-1} K_n
Dua metrik kunci dievaluasi pada setiap transisi jendela: rasio stagnasi celah $\rho_m^{(K)}$ dan rasio kompetensi relatif $\eta_m$:
\rho_m^{(K)} = \frac{\bar{K}_m - \bar{K}_{m-1}}{\bar{K}_m}, \qquad \eta_m = \frac{SR_m + SR_{m-1}}{2 \cdot SR_T}
Titik terminasi optimal $m^*$ ditentukan secara deterministik saat celah berhenti mengecil secara signifikan dan tingkat keberhasilan siswa telah mendekati atau menyamai kapasitas guru:
m^* = \inf \Big\{ m \ge 2 \;:\; \rho_m^{(K)} \ge \delta \;\land\; \eta_m \ge \gamma \Big\}
Ketika $m \ge m^*$, bobot distilasi diputus seketika $\lambda = 0$. Model siswa sepenuhnya beralih ke optimasi RL murni berpandukan reward lingkungan langsung.
3. Implementasi Runtime RetireOPD Engine
Di bawah ini adalah implementasi arsitektur produksi yang memodelkan Adaptive Retirement Gate dan penghitungan fungsi objektif gabungan GRPO-OPD:
"""
RetireOPD Runtime Engine: Decoupled Skill Teacher & Adaptive Retirement Gate
Berdasarkan Arsitektur Riset arXiv:2609.20784 (September 2026, Yu et al., Zhejiang University)
Mekanisme:
1. Privileged Teacher Initialization with Group Relative Policy Optimization (GRPO)
2. Joint GRPO + On-Policy Distillation (OPD) Loss Engine
3. Multi-Window Discrepancy Tracking (ρ_m^(K)) & Competence-Gated Retirement Trigger (η_m)
"""

import numpy as np
from dataclasses import dataclass, field
from typing import List, Dict, Optional, Tuple

@dataclass
class TrajectorySample:
    trajectory_id: str
    tokens: List[int]
    log_probs_student: List[float]
    log_probs_teacher: List[float]
    reward: float

@dataclass
class WindowMonitoringMetrics:
    window_index: int
    mean_token_gap_Kn: float
    window_avg_gap_Km: float
    discrepancy_reduction_rho: float
    relative_competence_eta: float
    student_success_rate: float
    teacher_success_rate: float
    is_retired: bool

class AdaptiveRetirementGate:
    """
    Mengontrol terminasi otomatis supervisi guru (Teacher Retirement)
    berdasarkan konvergensi disparitas token (shrink rate) dan ambang kompetensi siswa.
    """
    def __init__(
        self,
        window_size_W: int = 16,
        delta_threshold: float = 0.05,
        gamma_competence_threshold: float = 0.90,
        initial_lambda_opd: float = 1.0,
    ):
        self.W = window_size_W
        self.delta = delta_threshold
        self.gamma = gamma_competence_threshold
        self.current_lambda = initial_lambda_opd

        self.step_counter = 0
        self.current_window_K_steps: List[float] = []
        self.window_averages_Km: List[float] = []
        self.window_success_rates: List[float] = []
        self.teacher_baseline_sr: float = 0.85
        self.has_retired: bool = False
        self.retirement_step: Optional[int] = None

    def record_step_progress(self, trajectories: List[TrajectorySample], teacher_sr: float) -> Optional[WindowMonitoringMetrics]:
        self.teacher_baseline_sr = teacher_sr
        G = len(trajectories)
        if G == 0:
            return None

        # Hitung K_n: rata-rata selisih log-probabilitas token antara guru dan siswa
        step_token_gaps = []
        step_success_count = sum(1 for tau in trajectories if tau.reward >= 1.0)
        step_sr = step_success_count / G

        for tau in trajectories:
            seq_len = len(tau.tokens)
            if seq_len == 0:
                continue
            # Δ_t = log π_T(y_t | x, c^+, y_= self.W:
            window_idx = len(self.window_averages_Km)
            K_bar_m = float(np.mean(self.current_window_K_steps))
            self.window_averages_Km.append(K_bar_m)
            SR_m = float(np.mean(self.window_success_rates[-self.W:]))

            rho_m = 0.0
            eta_m = 0.0

            if window_idx >= 1:
                prev_K_bar = self.window_averages_Km[window_idx - 1]
                # Formula (8): ρ_m^(K) = (K̄_m - K̄_{m-1}) / K̄_m
                if abs(K_bar_m) > 1e-7:
                    rho_m = (K_bar_m - prev_K_bar) / K_bar_m

                # Formula (8): η_m = (SR_m + SR_{m-1}) / (2 * SR_T)
                prev_SR = float(np.mean(self.window_success_rates[-2*self.W : -self.W])) if len(self.window_success_rates) >= 2*self.W else SR_m
                eta_m = (SR_m + prev_SR) / (2.0 * max(self.teacher_baseline_sr, 1e-4))

                # Evaluasi kriteria retirement: m* = inf { m >= 2 : ρ_m^(K) >= δ ∧ η_m >= γ }
                if not self.has_retired and rho_m >= self.delta and eta_m >= self.gamma:
                    self.has_retired = True
                    self.current_lambda = 0.0  # Teacher dilepas, pelatihan berlanjut murni RL
                    self.retirement_step = self.step_counter

            metrics = WindowMonitoringMetrics(
                window_index=window_idx,
                mean_token_gap_Kn=K_n,
                window_avg_gap_Km=K_bar_m,
                discrepancy_reduction_rho=rho_m,
                relative_competence_eta=eta_m,
                student_success_rate=SR_m,
                teacher_success_rate=self.teacher_baseline_sr,
                is_retired=self.has_retired,
            )

            # Reset window buffer
            self.current_window_K_steps = []
            return metrics

        return None

class RetireOPDOrchestrator:
    """
    Pipeline pengelola siklus hidup pelatihan gabungan GRPO + On-Policy Distillation (OPD).
    """
    def __init__(self, clip_epsilon: float = 0.2, initial_lambda: float = 1.0):
        self.clip_epsilon = clip_epsilon
        self.gate = AdaptiveRetirementGate(initial_lambda_opd=initial_lambda)

    def compute_grpo_advantages(self, rewards: List[float]) -> np.ndarray:
        R = np.array(rewards, dtype=np.float32)
        std = np.std(R)
        if std < 1e-6:
            return np.zeros_like(R)
        return (R - np.mean(R)) / std

    def compute_joint_loss(
        self,
        trajectories: List[TrajectorySample],
        advantages: np.ndarray,
        old_student_log_probs: List[List[float]],
    ) -> Tuple[float, float, float]:
        """
        Menghitung: L_student(θ) = L_GRPO(θ) + λ * L_OPD(θ)
        """
        grpo_losses = []
        opd_losses = []

        for i, (tau, A_i) in enumerate(zip(trajectories, advantages)):
            old_lp = old_student_log_probs[i]
            cur_lp = tau.log_probs_student
            teacher_lp = tau.log_probs_teacher

            token_grpo = []
            token_opd = []

            for t in range(len(tau.tokens)):
                # r_t(θ) = π_θ(y_t) / π_{θ_old}(y_t)
                ratio = np.exp(cur_lp[t] - old_lp[t])
                surr1 = ratio * A_i
                surr2 = np.clip(ratio, 1.0 - self.clip_epsilon, 1.0 + self.clip_epsilon) * A_i
                token_grpo.append(min(surr1, surr2))

                # D_KL approximation pada sampling on-policy
                # L_OPD token gap = log π_T(y_t) - log π_θ(y_t)
                kl_t = -(teacher_lp[t] - cur_lp[t])
                token_opd.append(kl_t)

            grpo_losses.append(-np.mean(token_grpo))
            opd_losses.append(np.mean(token_opd))

        l_grpo = float(np.mean(grpo_losses))
        l_opd = float(np.mean(opd_losses))
        total_loss = l_grpo + (self.gate.current_lambda * l_opd)

        return total_loss, l_grpo, l_opd
4. Tolok Ukur Empiris Komprehensif: ALFWorld & WebShop
Evaluasi empiris dilakukan pada dua lingkungan tolak ukur interaktif multi-turn terpopuler: ALFWorld (manipulasi lingkungan rumah tangga berbasis teks dengan tugas pembersihan, pemanasan, dan pendinginan objek) dan WebShop (pencarian produk e-commerce realistis dengan atribut multidimensi). Seluruh pengujian dijalankan melintasi varian model Qwen2.5-Instruct pada skala 1.5B, 3B, hingga 7B.
| Kategori Model | Metode Pelatihan | Tipe Paradigma | ALFWorld Avg Acc | WebShop Acc | Delta vs RL Baseline |
|---|---|---|---|---|---|
| Qwen2.5-1.5B | GRPO Baseline | Pure RL | 72.8% | 56.8% | — |
| GiGPO | Pure RL (Step-level) | 86.7% | 65.0% | +13.9 pp / +8.2 pp | |
| Skill-GRPO* (Teacher) | Privileged Guru | 81.2% | 67.9% | +8.4 pp / +11.1 pp | |
| GRPO + OPD (Static) | Hybrid Tanpa Retire | 87.5% | 69.9% | +14.7 pp / +13.1 pp | |
| RetireOPD (Ours) | Self-Retiring Hybrid | 89.8% | 75.8% | +17.0 pp / +19.0 pp | |
| Qwen2.5-3B | GRPO Baseline | Pure RL | 75.0% | 63.3% | — |
| GiGPO | Pure RL (Step-level) | 92.2% | 69.5% | +17.2 pp / +6.2 pp | |
| Skill-GRPO* (Teacher) | Privileged Guru | 79.7% | 64.8% | +4.7 pp / +1.5 pp | |
| RetireOPD (Ours) | Self-Retiring Hybrid | 93.8% | 77.3% | +18.8 pp / +14.0 pp | |
| Qwen2.5-7B | GRPO Baseline | Pure RL | 81.2% | 72.6% | — |
| Skill-GRPO* (Teacher) | Privileged Guru | 90.6% | 78.9% | +9.4 pp / +6.3 pp | |
| GRPO + OPD (Static) | Hybrid Tanpa Retire | 92.2% | 81.2% | +11.0 pp / +8.6 pp | |
| RetireOPD (Ours) | Self-Retiring Hybrid | 95.3% | 84.4% | +14.1 pp / +11.8 pp |
5. Analisis Dinamika Pelatihan & Fenomena Super-Teacher Generalization
Tiga temuan krusial terungkap saat menganalisis trajektori pelatihan model siswa:
-
1. Penembusan Batas Kemampuan Guru (Super-Teacher Leap): Pada seluruh skala model (1.5B, 3B, dan 7B), model siswa RetireOPD secara konsisten melampaui tingkat keberhasilan gurunya sendiri ($SR_{\text{student}} > SR_T$). Pada Qwen2.5-3B, siswa mencatat akurasi 93.8% di ALFWorld, mengungguli guru berkemampuan skill (79.7%) sebesar +14.1 poin persentase. Hal ini membuktikan bahwa pelepasan guru adaptif memungkinkan siswa mengeksplorasi strategi interaksi yang lebih ringkas dan efisien daripada manual statis.
-
2. Kekebalan terhadap Stagnasi Distilasi Statis: Pada metode GRPO+OPD statis (tanpa pemensiunan), kurva akurasi siswa cenderung mendatar (plateau) atau bahkan mengalami degradasi kinerja setelah langkah ke-150. Sebaliknya, pada RetireOPD, pemotongan $\lambda=0$ seketika memicu kurva pertumbuhan kedua (secondary growth phase), di mana eksplorasi murni RL menyempurnakan bobot kebijakan siswa.
-
3. Eliminasi Context Bloat saat Deployment Produksi: Karena model siswa dilatih untuk menginternalisasi pola keputusan tanpa menyematkan manual $c^+$, agen hasil distilasi RetireOPD dapat langsung di-deploy tanpa memerlukan konteks sistem yang membengkak ribuan token per giliran. Ini menghemat biaya inferensi API hingga 35–50% dan memangkas First-Token Latency (TTFT) secara signifikan pada cluster serving enterprise.
6. Panduan Implementasi Arsitektur untuk Tim Rekayasa AI 2026
Bagi arsitek sistem dan tim AI engineering yang mengoperasikan kluster pelatihan agen otonom:
- Hindari Distilasi dari Un-optimized Teacher: Jangan pernah mengandalkan prompt dengan manual skill semata sebagai target distilasi probabilitas token. Lakukan pra-pelatihan guru berbasis GRPO terlebih dahulu agar supervisi benar-benar bersumber dari kebijakan yang terbukti menghasilkan reward lingkungan tinggi.
- Terapkan Windowed Monitoring Dinamis: Jangan gunakan ambang langkah statis (seperti "hentikan distilasi di epoch 3"). Pantau celah log-probabilitas token per jendela $W=16$ langkah. Gunakan batas henti $\delta = 0.05$ dan ambang kompetensi $\gamma \ge 0.90$ guna menghindari pemensiunan dini (premature retirement) saat siswa masih rapuh.
- Pembersihan Konteks Inferensi: Pastikan saat evaluasi dan penyajian di endpoint produksi, seluruh manual $c^+$ dilepas secara tuntas. Evaluasi rutin divergensi tindakan untuk memastikan representasi penalaran telah terpatri kokoh di bobot internal model tanpa dependensi eksternal.
Referensi & Sumber Terverifikasi
- [1]RetireOPD: Self-Retiring On-Policy Distillation for Agentic Reinforcement Learning(arXiv:2609.20784 [cs.CL, cs.AI] — Yan Yu, Zhengxi Lu, Yizhou Liu, Yichen Pan, Aozhe Wang, Qipeng Chen, Hua Yang, Wenqi Zhang, Weiming Lu, Qianglong Chen, Yongliang Shen (Zhejiang University))
- [2]What Does Privileged Information Add to On-Policy Self-Distillation?(arXiv:2609.20612 [cs.LG, cs.AI] — Machine Learning & Reasoning Distillation)
- [3]DeepSeek-Math: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO)(DeepSeek-AI Research / arXiv:2402.03300)
- [4]ALFWorld: Aligning Text and Embodied Environments for Interactive Learning(ICLR 2021 / Microsoft Research & University of Washington)
- [5]WebShop: Towards Scalable Real-World Web Interaction with Grounded Language Agents(NeurIPS 2022 / Princeton NLP & Stanford University)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.