Returning to Development States (arXiv:2610.13841): When Full Sandbox Snapshots Help Coding Agents, Go-Explore Search, Anatomi Kegagalan File-Centric, dan Keunggulan 4/5 pada Multi-Service Runtime State
Analisis arsitektur sistemik riset Daytona & University of Waterloo (arXiv:2610.13841, Daniel Thi Graviet, Tanmay Shah): Mengapa paradigma retry-from-scratch pada coding agents membuang machine state bernilai tinggi, dan mengapa restorasi snapshot sandbox penuh (Go-Explore-style) tidak selalu mengungguli retry pada tugas file-centric? Makalah ini menguji search atas snapshot Daytona dengan Claude Haiku 4.5 pada Terminal-Bench 2.0 (1M token/seed), mengurai 4 kegagalan struktural (Budget Fragmentation, Wrong-State Attractors, Handoff Cost, Weak State Selection), serta membuktikan secara empiris bahwa full machine snapshots menjadi keunggulan mutlak (4/5 solves vs 0/5 git diff) ketika state komputasi meluas ke luar repositori (database SQLite, daemon background, dan dependensi runtime).
Returning to Development States: When Full Sandbox Snapshots Help Coding Agents (arXiv:2610.13841)
Ditinjau dari riset terbaru Daniel Thi Graviet (Daytona) dan Tanmay Shah (University of Waterloo): Evaluasi komparatif antara independent retry-from-scratch versus Go-Explore-style search over Daytona full sandbox snapshots dengan budget 1.000.000 token per seed pada Terminal-Bench 2.0. Mengapa snapshot lengkap kalah pada repo file-centric (6/25 vs 17/25), namun melonjak mutlak (4/5 vs 0/5) saat komputasi melibatkan state di luar Git seperti database SQLite dan daemon runtime?
1. Dilema Intransisi Trajektori Coding Agent: Kegagalan Bukan Titik Awal yang Bersih
Dalam alur kerja rekayasa perangkat lunak otonom, kegagalan agen koding (coding agent failure) hampir tidak pernah merupakan kegagalan total dari baris pertama. Pertimbangkan skenario umum saat agen memperbaiki bug kompleks di repositori berukuran besar:
- Agen mengunduh dan mengonfigurasi pustaka eksternal yang hilang (missing dependencies).
- Agen berhasil mereproduksi kegagalan uji coba (reproduce the failing test).
- Agen memodifikasi beberapa berkas inti, menginisialisasi skema database lokal, dan mengompilasi artefak biner.
- Di langkah ke-18, agen melakukan satu penyuntingan sintaksis yang keliru (bad edit) atau terjebak dalam loop logika buntu, sehingga batas langkah habis atau verifier menyatakan tugas gagal.
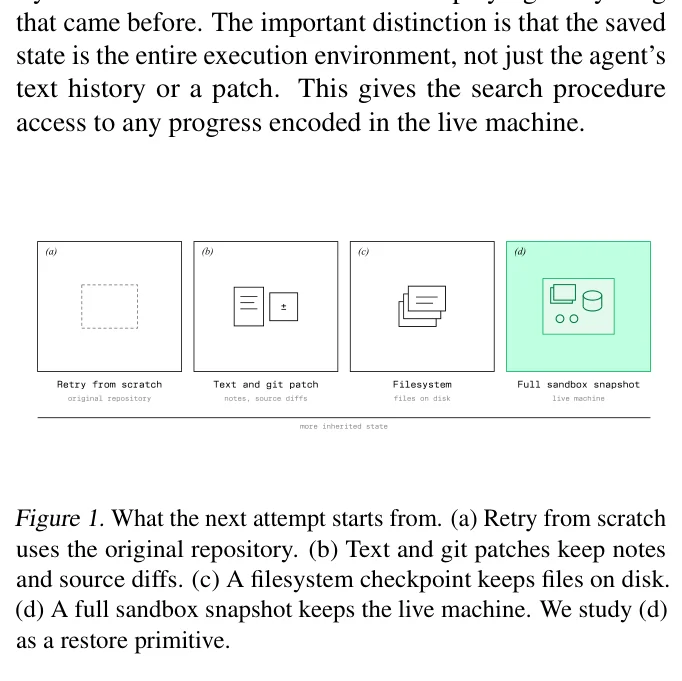
Di bawah paradigma Test-Time Scaling konvensional (seperti independent retry atau re-sampling from scratch), sistem evaluasi membuang seluruh mesin dan mengulang proses dari titik nol (initial state repositori). Pendekatan ini tidak hanya menghapus penyuntingan yang buruk, tetapi juga membuang seluruh komputasi berharga yang telah terakumulasi: dependensi yang sudah terpasang, environment yang sudah terkonfigurasi, dan database yang sudah terisi.
Sebaliknya, jika kita menyimpan git diff atau teks log memori (seperti Reflexion), kita hanya mempertahankan sebagian kecil dari perubahan yang dilacak oleh version control. Hal ini memunculkan pertanyaan fundamental yang diinvestigasi oleh Graviet & Shah (arXiv:2610.13841): Kapan agen membuat progres berharga sebelum gagal, state apa yang mutlak harus dipreservasi agar progres tersebut dapat digunakan kembali (reusable)?
2. Paradigma Go-Explore atas Live Daytona Sandboxes
Terinspirasi oleh algoritma Go-Explore (Ecoffet et al., Nature 2021) dan Intelligent Go-Explore (Lu et al., ICLR 2025), para peneliti memperlakukan trajektori agen koding bukan sebagai satu percobaan yang monolitik dan tak terpisahkan, melainkan sebagai jalur yang melintasi serangkaian machine states.
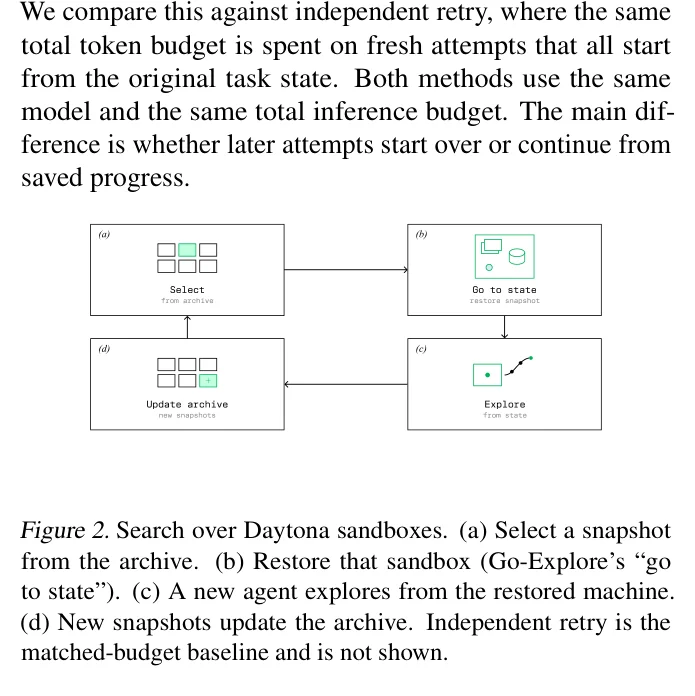
Dalam search ini, snapshot sandbox Daytona bertindak layaknya berkas save game dalam eksplorasi game reinforcement learning:
- State Archiving: Selama eksekusi agen berlangsung, sistem secara periodik mengambil snapshot penuh terhadap seluruh wadah Daytona (termasuk RAM, proses yang berjalan, berkas sementara, soket jaringan, dan disk).
- State Ranking & Selection: Snapshot disimpan dalam sebuah arsip (archive) dan diberi peringkat berdasarkan proksi progres (seperti modifikasi berkas, keberhasilan perintah shell, atau eksekusi unit test).
- Restore & Branching: Ketika trajektori root menemui kegagalan, sistem tidak me-reset environment dari awal. Sistem memilih snapshot yang paling menjanjikan dari arsip, merestorasi mesin Daytona ke titik persis tersebut, dan meluncurkan agen anak (child agent) dengan konteks penalaran baru (fresh agent context).
3. Eksperimen Headline: Hasil Tak Terduga pada Benchmark File-Centric
Hipotesis awal para peneliti adalah: Melakukan branching dari snapshot intermediate yang menjanjikan akan memecahkan lebih banyak tugas rekayasa daripada independent retry di bawah batas anggaran token yang sama (matched inference budget).
Untuk menguji hipotesis ini secara objektif dan menghindari bias cherry-picking, peneliti menetapkan protokol terdaftar sebelumnya (pre-registered protocol) menggunakan Terminal-Bench 2.0 (Merrill et al., ICLR 2026) dengan harness Harbor dan infrastruktur cloud sandbox Daytona. Model yang digunakan adalah Claude Haiku 4.5 dengan anggaran ketat sebesar 1.000.000 token per seed pada 5 tugas dengan tingkat kesulitan menengah:
git-multibranch: Manajemen merge konflik cabang Git yang rumit.extract-elf: Analisis rekayasa balik biner ELF dan ekstraksi payload.custom-memory-heap-crash: Pelacakan bug alokasi heap C/C++.code-from-image: Ekstraksi dan sintesis kode sumber dari visual mock.large-scale-text-editing: Refaktorisasi massal pada berkas konfigurasi multi-baris.
Hasil komparasi ini membantah hipotesis awal secara dramatis pada tugas yang berpusat pada berkas (file-centric tasks):
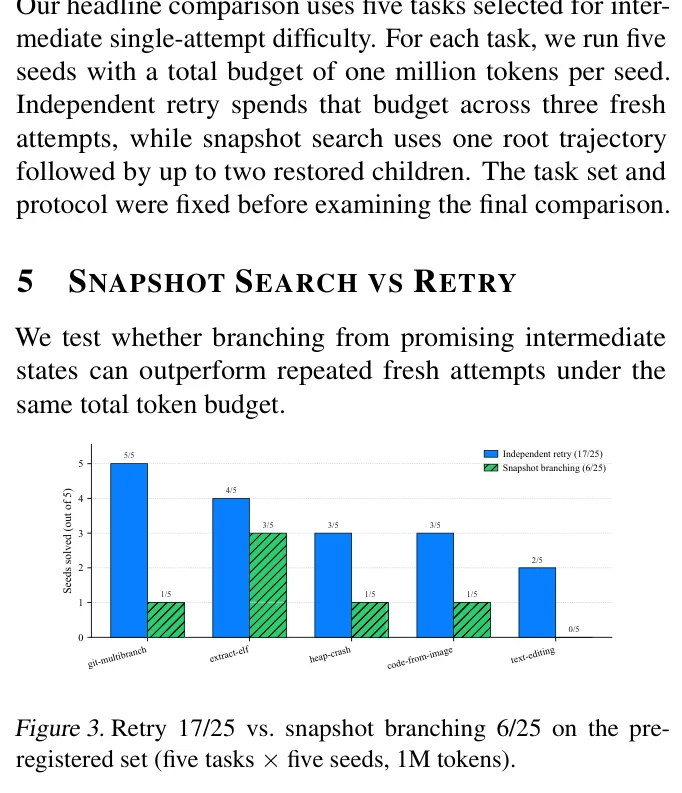
| Nama Task (Terminal-Bench 2.0) | Independent Retry (3 Fresh Attempts) | Snapshot Branching (1 Root + Up to 2 Children) | Diferensial Keberhasilan |
|---|---|---|---|
git-multibranch |
5 / 5 (100%) | 1 / 5 (20%) | -80% (Retry Menang Mutlak) |
extract-elf |
4 / 5 (80%) | 3 / 5 (60%) | -20% (Komparabel) |
custom-memory-heap-crash |
3 / 5 (60%) | 1 / 5 (20%) | -40% |
code-from-image |
3 / 5 (60%) | 1 / 5 (20%) | -40% |
large-scale-text-editing |
2 / 5 (40%) | 0 / 5 (0%) | -40% |
| TOTAL AGREGAT | 17 / 25 (68.0%) | 6 / 25 (24.0%) | -44.0% Delta Penyelesaian |
Mengapa mekanisme restorasi yang begitu sempurna dan canggih justru tertinggal jauh di belakang pendekatan coba-ulang acak (fresh retry)? Analisis mendalam penulis mengungkap empat kegagalan struktural dari pencarian berbasis state mesin.
4. Dekonstruksi 4 Mode Kegagalan Snapshot Search pada Lingkungan File-Centric
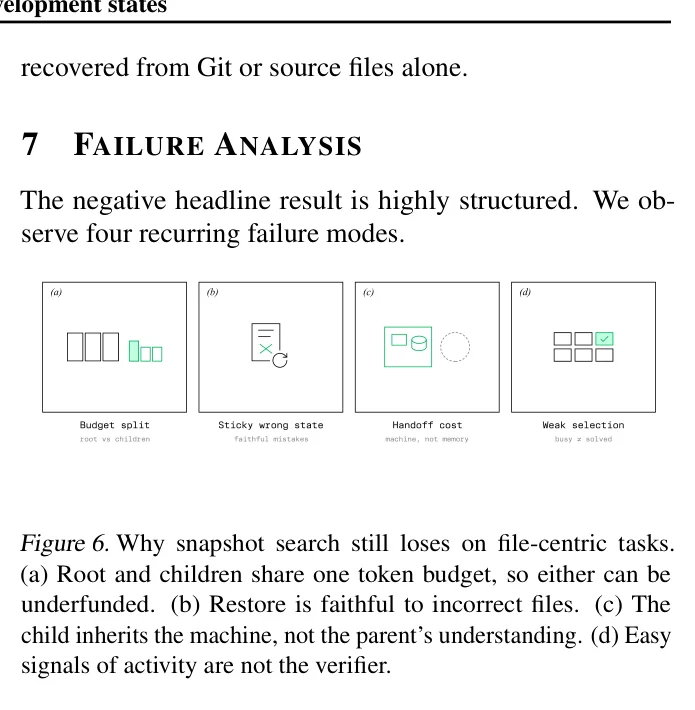
A. Budget Fragmentation (Fragmentasi Anggaran Token)
Pada independent retry, setiap percobaan memperoleh alokasi budget token penuh (~333.000 token per attempt secara merata). Sebaliknya, pada snapshot search, anggaran 1.000.000 token harus dibagi untuk menjalankan trajektori akar (root) dan sisa budget dibagi untuk anak-anak cabang (children).
Jika trajektori akar lemah, arsip snapshot yang tercipta bernilai rendah. Sementara itu, agen-agen anak yang diluncurkan dengan alokasi token sisa yang tipis sering kali kehabisan token (budget exhaustion) sebelum sempat menuntaskan rangkaian perbaikan kode yang rumit.
B. Wrong-State Attractors (Jebakan State Parsial yang Salah)
Snapshot membekukan mesin secara setia—artinya snapshot menyimpan kesalahan dengan tingkat kesetiaan yang sama tingginya dengan menyimpan kemajuan.
Jika checkpoint yang dipilih berisi arsitektur kode yang sekilas tampak masuk akal namun secara fundamental salah, agen anak cenderung terjebak mengutak-atik implementasi yang cacat tersebut daripada merombak ulang arsitektur dari awal. Restorasi yang terlalu presisi justru menciptakan atraktor magnetis yang mengunci agen dalam lembah kesalahan lokal (local optima trap).
C. Handoff Cost (Beban Kognitif Rekontekstualisasi Agen Baru)
Agen anak mewarisi sistem berkas mesin, tetapi tidak mewarisi memori mental (implicit understanding) dari agen induk. Agen anak harus menghabiskan putaran token berharga untuk memetakan ulang lingkungan: mencari tahu berkas apa yang telah diubah, tes apa yang sudah dicoba, dan strategi apa yang gagal.
Dalam salah satu inspeksi jejak trajektori oleh peneliti: sebuah agen anak membakar 190.000 token dalam 26 langkah hanya untuk memahami repositori dan mengejar ketertinggalan, sementara sebuah fresh retry yang sukses berhasil menyelesaikan seluruh tugas hanya dalam 90.000 token dan 11 langkah!
D. Weak State Selection (Sinyal Seleksi Proksi yang Menipu)
Menentukan apakah suatu state mesin layak dikunjungi kembali adalah masalah pencarian yang sangat sulit. Penyuntingan berkas yang banyak, perintah bash yang mengembalikan exit code 0, atau tes unit lokal yang lulus sering kali merupakan sinyal semu.
Heuristik seleksi awal sering kali memberi skor tinggi pada langkah instalasi paket atau deklarasi agen bahwa tugas telah "selesai", padahal klaim tersebut merupakan halusinasi dan tidak diverifikasi oleh ground-truth harness. Snapshotting menyelesaikan masalah restorasi state, tetapi sama sekali tidak menyelesaikan masalah seleksi state.
5. The Boundary Condition: Kapan Full Machine Snapshot Menjadi Kebutuhan Mutlak?
Melihat kegagalan pada tugas file-centric, apakah snapshot sandbox merupakan abstraksi yang sia-sia? Jawabannya: Sama sekali tidak. Nilai snapshot sandbox berbanding lurus dengan di mana progres komputasi itu berada.
Sebagian besar benchmark koding populer (seperti SWE-bench) didesain secara file-centric: seluruh keberhasilan tugas dapat diekspresikan sebagai sebuah patch git diff sederhana. Namun dalam sistem perangkat lunak dunia nyata, rekayasa melibatkan long-lived services, daemon latar belakang, migrasi skema database relasional, antrean pesan, dan paket runtime.
Untuk membuktikan hipotesis ini, Graviet & Shah merancang tugas multi-layanan terkontrol bernama staged-service-repair. Dalam tugas ini, agen harus mendiagnosis crash pada API service, mengonfigurasi database warehouse SQLite di luar repositori git, menjalankan migrasi data, dan menyalakan daemon HTTP. Peneliti menanamkan sebuah checkpoint intermediate yang sama dan menguji tiga metode penyelesaian dengan sisa budget 200.000 token:
- Clean Start: Memulai ulang tugas dari state repositori awal.
- Git Diff Only: Merestorasi modifikasi kode sumber melalui patch Git ke dalam mesin baru yang bersih.
- Full Daytona Snapshot: Merestorasi live sandbox Daytona secara menyeluruh.
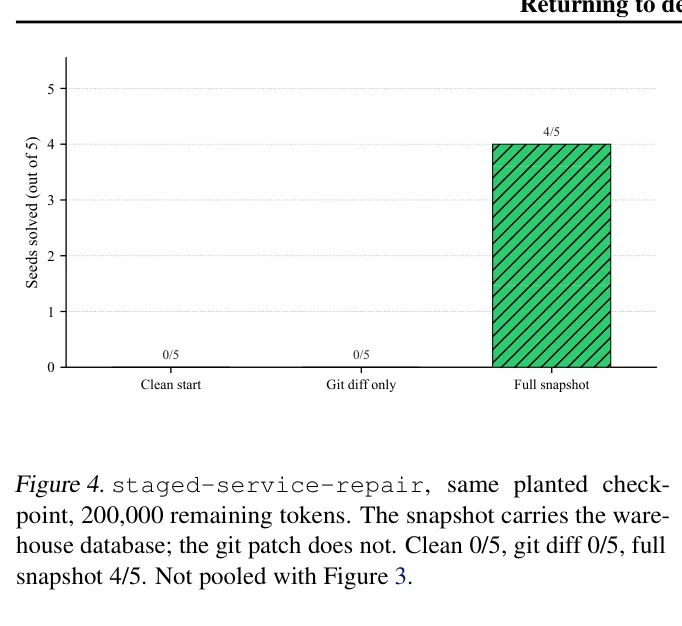
Hasilnya memperlihatkan divergensi yang mutlak:
- Clean start gagal total (0/5): Menghabiskan seluruh anggaran token untuk mengulang setup dari awal dan kehabisan batas waktu.
- Git diff only gagal total (0/5): Meskipun patch kode sumber teraplikasikan secara sempurna, berkas database SQLite warehouse yang dibutuhkan oleh verifikasi unit test tidak tersimpan dalam Git diff, sehingga verifier gagal memvalidasi data transaksi.
- Full Snapshot sukses besar (4/5): Restorasi snapshot Daytona secara instan membawa kembali database warehouse yang sudah terisi dan konfigurasi daemon tanpa perlu dieksekusi ulang. Agen anak hanya perlu menyelesaikan sedikit sisa konfigurasi.
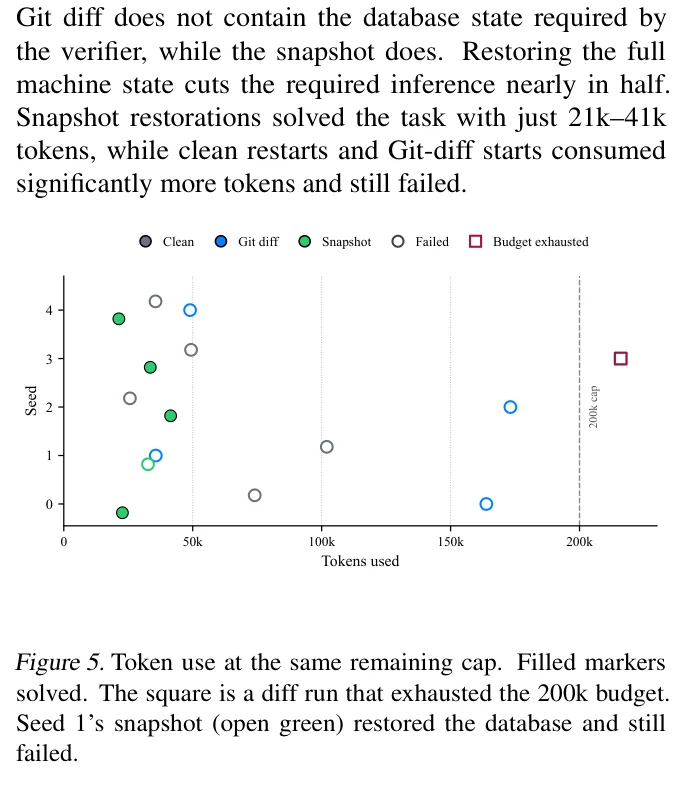
Menariknya, satu kegagalan pada snapshot run (Seed 1) bukanlah kegagalan restorasi mesin: database SQLite telah hadir dengan utuh, namun agen anak membaca berkas migrasi yang tersisa, menyalakan server HTTP, dan langsung menyatakan tugas selesai tanpa benar-benar mengeksekusi script migrasi tersebut. Ini membuktikan bahwa bahkan pada mesin yang direstorasi secara sempurna, agen baru tetap harus memiliki kemampuan reasoning untuk mengidentifikasi pekerjaan apa yang masih tersisa.
6. Implementasi Referensi: Daytona Go-Explore Engine dengan Context Handoff Protocol
Untuk mengatasi tiga kelemahan utama (Budget Fragmentation, Wrong-State Attractors, dan Handoff Cost) saat menerapkan pencarian berbasis sandbox di lingkungan enterprise, berikut adalah implementasi arsitektur orkestrator TypeScript yang mengombinasikan seleksi state berbasis runtime-awareness dan protokol briefing eksplisit:
${SANDBOX_SNAPSHOTS_CODE_SNIPPET}7. Rekomendasi Arsitektural untuk Sistem AI Agent 2026/2027
Berdasarkan temuan empiris riset arXiv:2610.13841, para perekayasa sistem agen otonom (seperti yang membangun harness Claude Code, Hermes Agent, Daytona, atau OpenCode) wajib mengadopsi prinsip desain berikut:
-
Gunakan Primitif Restorasi Bertingkat (Tiered Restore Primitives): Untuk tugas yang murni menyunting logika berkas (file-centric coding), pertahankan
git diffdan fresh retries karena jauh lebih hemat token dan bebas dari jebakan kesalahan lokal (wrong-state attractors). - Aktifkan Full Sandbox Snapshots Hanya Saat State Meluas Keluar Git: Ketika pekerjaan agen melibatkan instalasi paket sistemik yang memakan waktu lama, pemuatan container Docker lokal, inisialisasi skema database relasional, atau eksekusi proses background, snapshot live sandbox adalah satu-satunya mekanisme yang mampu memangkas waktu inferensi hingga >60%.
- Wajibkan Explicit Context Handoff Protocol: Jangan pernah melemparkan agen baru ke dalam mesin yang direstorasi tanpa ringkasan status. Sistem harness harus menyusun dokumen ringkas (handoff manifest) yang merinci milestone apa saja yang sudah terverifikasi dan anomali apa yang masih tersisa agar agen anak tidak membakar ratusan ribu token untuk re-eksplorasi.
- Terapkan Adaptive Budget Allocation: Hindari pembagian token yang kaku. Jika trajektori akar telah mengonsumsi lebih dari 65% batas token tanpa hasil yang jelas, batalkan pembuatan cabang anak dan alihkan sisa sumber daya ke fresh retry independen.
Referensi & Sumber Terverifikasi
- [1]Returning to Development States: When Full Sandbox Snapshots Help Coding Agents(arXiv:2610.13841 [cs.LG, cs.SE] — Daniel Thi Graviet (Daytona) & Tanmay Shah (University of Waterloo))
- [2]First return, then explore(Nature 590:580–586 (2021) — Adrien Ecoffet, Joost Huizinga, Joel Lehman, Kenneth O. Stanley, Jeff Clune)
- [3]Intelligent Go-Explore: Standing on the Shoulders of Giant Foundation Models(ICLR 2025 / arXiv:2405.15143 — Chris Lu, Shengran Hu, Jeff Clune)
- [4]Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces(ICLR 2026 / OpenReview:a7Qa4CcHak — Michael A. Merrill et al.)
- [5]CodeMonkeys: Scaling Test-Time Compute for Software Engineering(arXiv:2501.14723 — Rachel Ehrlich, Bradley Brown, Jordan Juravsky, Christopher Ré, Azalia Mirhoseini)
- [6]Agentless: Demystifying LLM-Based Software Engineering Agents(arXiv:2407.01489 — Chunqiu Steven Xia, Yuntian Deng, Soren Dunn, Lingming Zhang)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.
Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.
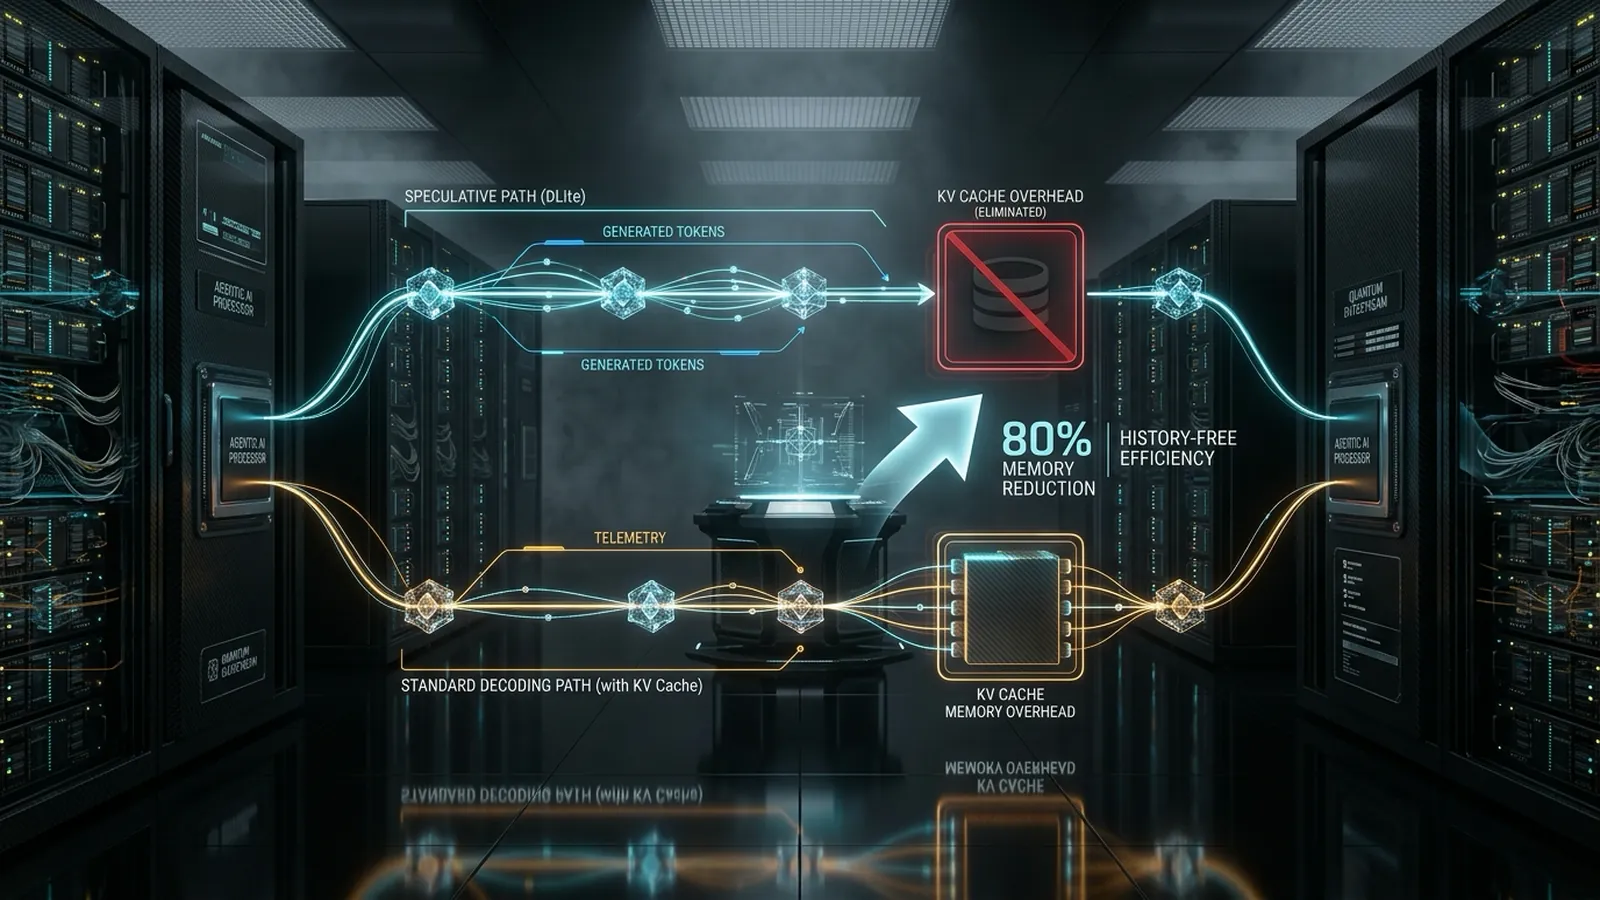
DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.