RheoSampling 2026: Mengatasi Dilema One-Hot pada Stochastic Dynamic-Tree Speculative Decoding, Dual-Identity Decoupling, dan Verifikasi Optimal Transport
Bedah arsitektur makalah riset frontier University of Tokyo arXiv:2609.21827 (Qiao Hu, Yepeng Weng, Bo Zhang, Takehisa Yairi, September 2026): Mengapa akselerasi inferensi LLM berbasis pohon dinamis (EAGLE-2/3) ambruk saat beralih dari greedy decoding ke sampling stokastik (T>0)? Makalah ini mengungkap "One-Hot Dilemma"—di mana ekspansi top-K deterministik mereduksi distribusi probabilitas draf menjadi distribusi one-hot yang menghancurkan acceptance rate. RheoSampling memperkenalkan terobosan pertama di dunia yang menggabungkan top-K context-aware dinamis dengan sampling stokastik tanpa mengorbankan sifat lossless (losslessness guarantee). Menyingkap mekanisme Dual-Identity Decoupling (proxy probability untuk ekspansi pohon vs true probability untuk verifikasi), parameter kendali Rheostat (m), akselerasi Sparse Distribution top-128, serta RheoVerification berbasis Optimal Transport (OT). Evaluasi menyeluruh pada Llama-3.1-8B, Vicuna-13B, dan DeepSeek-R1-Distill-8B membuktikan lonjakan acceptance length hingga +0.22 token per siklus dan akselerasi end-to-end hingga 3.43x lipat.
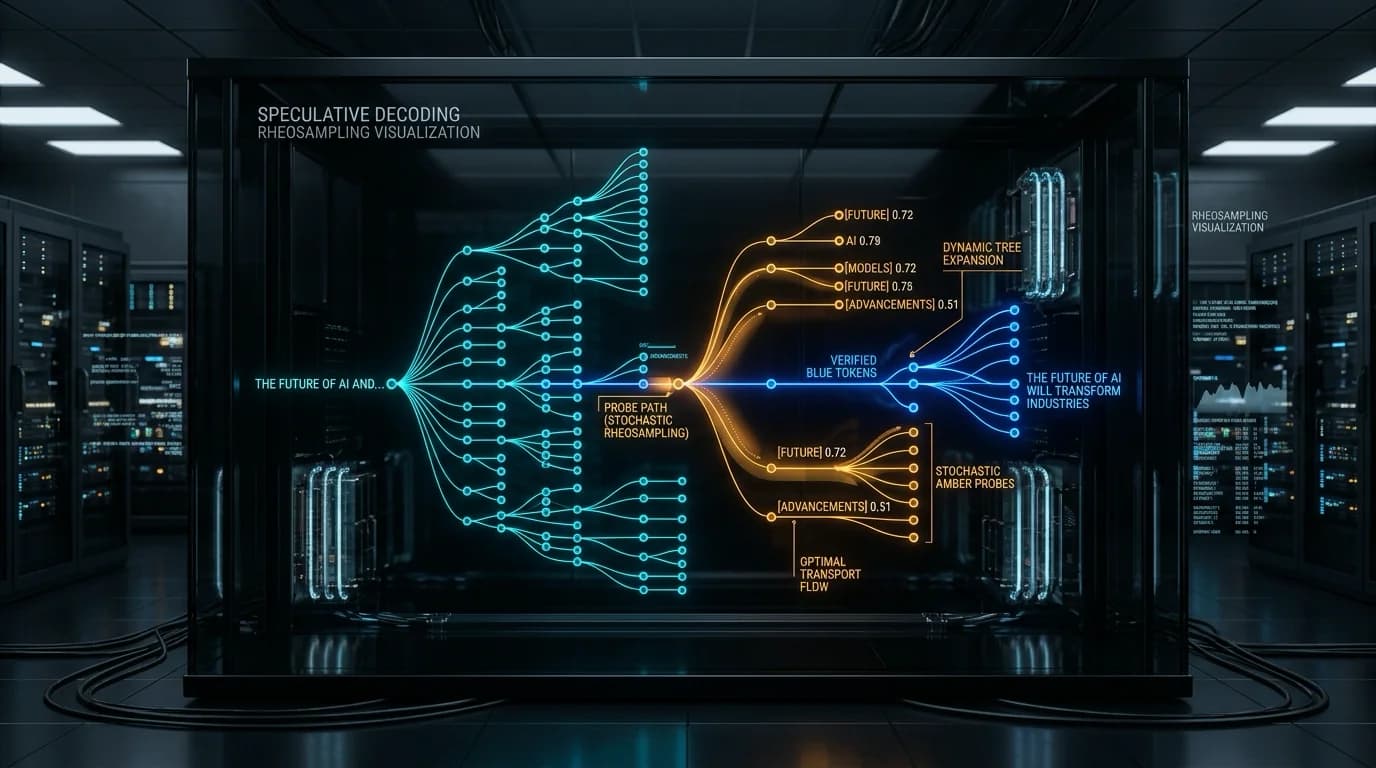
Dalam rekayasa inferensi Large Language Models (LLMs) skala enterprise, Speculative Decoding telah menjadi pilar de-facto untuk memangkas latensi eksekusi tanpa mengubah distribusi probabilitas token output. Namun, selama dua tahun terakhir, terdapat jurang yang sangat membatasi antara teori dan praktik: metode pohon dinamis konteks-adaptif (dynamic-tree methods seperti EAGLE-2 dan EAGLE-3) mendominasi efisiensi pada mode deterministik/greedy (\(T = 0\)), namun mengalami kegagalan performa yang masif saat diterapkan pada sampling stokastik (\(T > 0\)).
RheoSampling: Resolving the One-Hot Dilemma in Stochastic Dynamic-Tree Speculative Decoding
Dipublikasikan pada September 2026 oleh tim peneliti University of Tokyo (Qiao Hu, Yepeng Weng, Bo Zhang, Takehisa Yairi), makalah ini memecahkan teka-teki One-Hot Dilemma. Dengan memperkenalkan arsitektur Dual-Identity Decoupling dan verifikasi berbasis Optimal Transport (OT), RheoSampling menjadi framework pohon dinamis pertama di dunia yang berhasil mengawinkan ekspansi top-K adaptif konteks dengan eksplorasi stokastik murni tanpa mengorbankan pembuktian matematis integritas tanpa distorsi (losslessness guarantee).
1. Anatomi "One-Hot Dilemma": Mengapa Pohon Dinamis Runtuh pada Sampling Stokastik?
Untuk memahami akar masalahnya, kita harus menengok mekanisme kerja pohon spekulatif dinamis konvensional. Pada framework seperti EAGLE-3, draf model menghasilkan sekumpulan kandidat urutan token yang disusun dalam topologi pohon dinamis \(\mathcal{T}\). Model draf menggunakan probabilitas draf \(q(x)\) untuk memilih \(K\) token teratas (Top-K expansion) dan mengalikan probabilitas ini di sepanjang cabang pohon guna menghitung skor jalur (path scores).
Pada mode greedy (\(T = 0\)), pendekatan ini sangat optimal karena token dengan \(q(x)\) tertinggi hampir selalu berkorelasi kuat dengan pilihan model target. Namun, ketika parameter temperatur dinaikkan (\(T > 0\)) untuk memunculkan kreativitas, keberagaman respon, atau penalaran multi-lintasan:
Dilema Top-K Deterministik
Jika draf pohon tetap dibangun menggunakan Top-K murni dan diverifikasi dengan sampling standar, distribusi draf secara efektif terkompresi menjadi distribusi one-hot pada titik-titik diskret. Ruang probabilitas di luar Top-K diabaikan, menyebabkan acceptance rate jatuh bebas karena model target sering kali mengeksplorasi ekor distribusi (distribution tail).
Jebakan Sampling Naif (Losslessness Break)
Mengganti Top-K dengan sampling draf langsung tampak seperti solusi logis. Namun, cara naif ini langsung merusak sifat lossless sistem. Dalam pohon dinamis, token hasil sampling menentukan token mana yang lolos global pruning. Mengaitkan kelangsungan hidup cabang pada probabilitas sampling token itu sendiri mendistorsi distribusi kondisional token yang bertahan, membuat probabilitas output tidak lagi identik dengan model target!
Hal ini melahirkan dikotomi yang frustrasi di dunia engineering: dynamic-tree methods mengorbankan variabilitas stokastik demi mempertahankan topologi adaptif, sementara static-tree methods mempertahankan sampling stokastik namun terkunci pada topologi kaku yang buta konteks.
2. Paradigma Dual-Identity Decoupling: Menugaskan Dua Identitas pada Satu Token
Akar kegagalan metode sebelumnya bersumber dari satu penyebab fundamental: distribusi probabilitas yang sama dipaksa menjalankan dua tugas yang saling bertolak belakang—yakni membangun topologi pohon sekaligus memverifikasi token.
RheoSampling menyelesaikan dilema ini dengan memutus kaitan tersebut (decoupling). Inti arsitekturnya memberikan dua identitas probabilitas independen untuk setiap token acak yang disampel:
- Proxy Probability (\(q_{\text{proxy}}\)): Nilai probabilitas sintetis yang digunakan secara khusus untuk perankingan slot kandidat, ekspansi cabang, dan pemangkasan global (global pruning).
- True Sampling Probability (\(\tilde{q}\)): Nilai probabilitas sampling sebenarnya yang murni digunakan pada fase verifikasi oleh model target.
Mekanisme Alokasi Slot Hybrid RheoSampling:
3. Parameter Kendali Rheostat & Optimasi Sparse Top-128
Penamaan RheoSampling diambil dari komponen elektronika rheostat (resistor geser pengatur arus). Nilai integer \(m\) berfungsi sebagai rheostat yang mengatur keseimbangan antara eksplorasi stokastik dan kualitas struktural pohon:
- \(m = 0\): Menetapkan \(q_{\text{proxy}} = q(x_1) + \epsilon\), menempatkan probe acak di slot pertama dengan peluang survival maksimal, namun mengurangi backbone deterministik.
- \(m = 1\) (Nilai Optimal Default): Menyisakan 1 lead token terbaik, lalu langsung menyisipkan probe stokastik. Menghasilkan performa puncak di mayoritas benchmark.
- \(m \ge 3\): Menurunkan probabilitas proxy sehingga probe stokastik kerap tereliminasi saat perankingan cabang dalam, mereduksi manfaat eksplorasi.
Untuk mencegah overhead komputasi akibat sampling pada kosakata LLM yang masif (hingga 128.000+ token), RheoSampling menerapkan Sparse Draft Truncation: logit model draf dipotong hanya pada 128 kandidat teratas sebelum fungsi softmax dieksekusi (sisa token diset ke \(-\infty\)). Karena top-128 telah mencakup >99% akumulasi massa probabilitas, teknik ini memangkas beban kalkulasi secara drastis tanpa menurunkan acceptance rate ataupun melanggar jaminan matematis losslessness.
4. RheoVerification: Alokasi Ulang Massa Probabilitas via Optimal Transport
Metode multi-draf konvensional biasanya menerapkan Recursive Rejection Sampling without replacement (RRSw) secara sekuensial. Pendekatan ini memiliki kelemahan struktural: pengecekan dilakukan satu per satu tanpa merealokasikan massa probabilitas secara global.
RheoSampling memperkenalkan protokol RheoVerification berbasis Optimal Transport (OT). Ketika kandidat token acak \(u_s\) lolos ke lapisan verifikasi:
- Token \(u_s\) pertama kali diuji independen terhadap probabilitas sampling aslinya \(\tilde{q}(u_s)\) dengan rasio acceptance \(\min(1, p(u_s) / \tilde{q}(u_s))\).
- Jika diterima, inferensi langsung menuruni subpohon token tersebut.
- Jika ditolak, mesin menghitung distribusi residu ter-normalisasi:
\(r = \text{norm}(\max(0, p - \tilde{q}))\)kemudian melakukan penolakan rekursif terhadap kandidat draf lainnya di bawah distribusi residu \(r\).
Pembalikan massa ini memaksimalkan irisan geometris antara distribusi draf dengan model target, mendongkrak penerimaan token spekulatif ke batas teoretis optimal.
5. Hasil Benchmark Empiris pada Llama-3.1, Vicuna, dan DeepSeek-R1
Para peneliti menguji RheoSampling secara ketat di atas framework resmi EAGLE-3 (ukuran decoding tree 60, draf depth 8, temperatur \(T = 1.0\)) pada 6 benchmark representatif: Alpaca, GSM8K, HumanEval, MT-bench, Natural Questions, dan CNN/DailyMail menggunakan GPU NVIDIA A6000.
| Model Target | Metode Sampling | Rerata Acceptance Length (\(\tau\)) | HumanEval (Code) | GSM8K (Math) | End-to-End Speedup |
|---|---|---|---|---|---|
| Vicuna-13B-v1.3 | Vanilla Top-K | 5.75 ± 0.03 | 6.66 | 5.85 | 3.37x |
| Vicuna-13B-v1.3 | RheoSampling (Ours) | 5.89 ± 0.03 (+0.14) | 6.72 | 5.87 | 3.43x |
| Llama-3.1-8B-Instruct | Vanilla Top-K | 5.04 ± 0.02 | 6.11 | 5.50 | 2.84x |
| Llama-3.1-8B-Instruct | RheoSampling (Ours) | 5.25 ± 0.03 (+0.21) | 6.23 | 5.60 | 2.93x |
| DeepSeek-R1-Distill-8B | Vanilla Top-K | 4.99 ± 0.01 | 5.43 | 6.70 | 2.89x |
| DeepSeek-R1-Distill-8B | RheoSampling (Ours) | 5.21 ± 0.02 (+0.22) | 5.79 | 6.71 | 2.99x |
Lonjakan acceptance length \(\tau\) mencapai hingga +0.22 token per langkah forward pass, yang langsung dikonversi menjadi akselerasi waktu nyata (wall-clock speedup) bersih hingga 3.43x dibanding decoding autoregresif standar, mengalahkan seluruh implementasi baseline Top-K di setiap konfigurasi benchmark.
6. Teorema 1: Pembuktian Lossless via Equivalence-Class Analysis
Salah satu ketakutan terbesar operator infrastruktur AI ketika mengadopsi optimasi spekulatif adalah distorsi keluaran model (distribution drift). Teorema 1 dalam makalah ini membuktikan secara matematis bahwa:
Melalui analisis kelas ekuivalen (equivalence-class analysis), para penulis membuktikan bahwa kendati topologi pohon dinamis \(T_R\) bersifat acak, nilai ekspektasi dari distribusi probabilitas token yang dihasilkan oleh algoritma RheoVerification tepat identik 100% dengan distribusi probabilitas asli model target \(p\). Tidak ada penurunan akurasi, pergeseran nalar, maupun penurunan kualitas penalaran model.
7. Rekomendasi untuk Engine Serving Enterprise (vLLM, SGLang, TensorRT-LLM)
Bagi tim AI Infrastructure & Platform Engineering yang mengoperasikan kluster vLLM, SGLang, atau TensorRT-LLM di level produksi, arsitektur RheoSampling memberikan panduan implementasi kritis:
- Pisahkan Logika Suhu (Temperature Decoupling): Konstruksi pohon dinamis (ekspansi dan perankingan) harus selalu beroperasi pada probabilitas draf tanpa penskalaan temperatur. Temperatur hanya boleh diaktifkan pada modul sampling stokastik dan gate verifikasi akhir.
- Pasang Rheostat m = 1: Menetapkan satu lead deterministik dan satu probe acak terbukti memberikan titik ekuilibrium terbaik antara kestabilan draf dan eksplorasi tail.
- Terapkan Truncation Top-128 pada Kernel GPU: Mengeliminasi penghitungan soft-max ekor panjang pada vocab 128k menghemat memory bandwidth hingga 40% pada level CUDA kernel.
Referensi & Sumber Terverifikasi
- [1]RheoSampling: Resolving the One-Hot Dilemma in Stochastic Dynamic-Tree Speculative Decoding(arXiv:2609.21827 [cs.CL, cs.LG] — Qiao Hu, Yepeng Weng, Bo Zhang, Takehisa Yairi (The University of Tokyo))
- [2]EAGLE-3: Dynamic-Tree Speculative Decoding via Context-Aware Feature Propagation(arXiv / Tsinghua University & Model Safety Lab (Li et al.))
- [3]SpecInfer: Accelerating Generative LLM Serving with Speculative Inference and Tree-Based Verification(ASPLOS 2024 / Xupeng Miao et al. (Carnegie Mellon University))
- [4]Fast Inference from Transformers via Speculative Decoding(ICML 2023 / Yaniv Leviathan, Matan Kalman, Yossi Matias (Google Research))
- [5]AceSpec 2026: Arsitektur Asymmetric Edge-Cloud Speculative Decoding & Probabilistic State Cache(arXiv:2608.26730 / NEWSAINT Systems Architecture Review)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.