RSIAgent 2026: Arsitektur Autonomous Exploration untuk Recursive Self-Improvement, Causal Memory Construction, dan Broad-then-Deep Search pada AI Agents
Analisis arsitektural mendalam atas terobosan Aether AI arXiv:2609.15364 (September 2026, Sibo Zhu et al., UCSD & UIC): Bagaimana RSIAgent mewujudkan Recursive Self-Improvement (RSI) tanpa memperbarui bobot model dasar (training-free). Melalui triad agentis (Curriculum, Actor, Verifier) dan strategi eksplorasi dua fase Broad Recursive Self-Exploration (BRS) dan Deep Recursive Self-Exploration (DRS), RSIAgent memetakan topologi lingkungan baru, memvalidasi dependensi kausalitas antaraksi, membekukan memori prosedural reusable, dan mengantarkan model open-source seperti Kimi-K3 serta GLM-5.3 mengungguli model frontier komersial pada tolok ukur OSWorld 2.0 (skor 78.98/100) dan Agents' Last Exam (84.82/100).
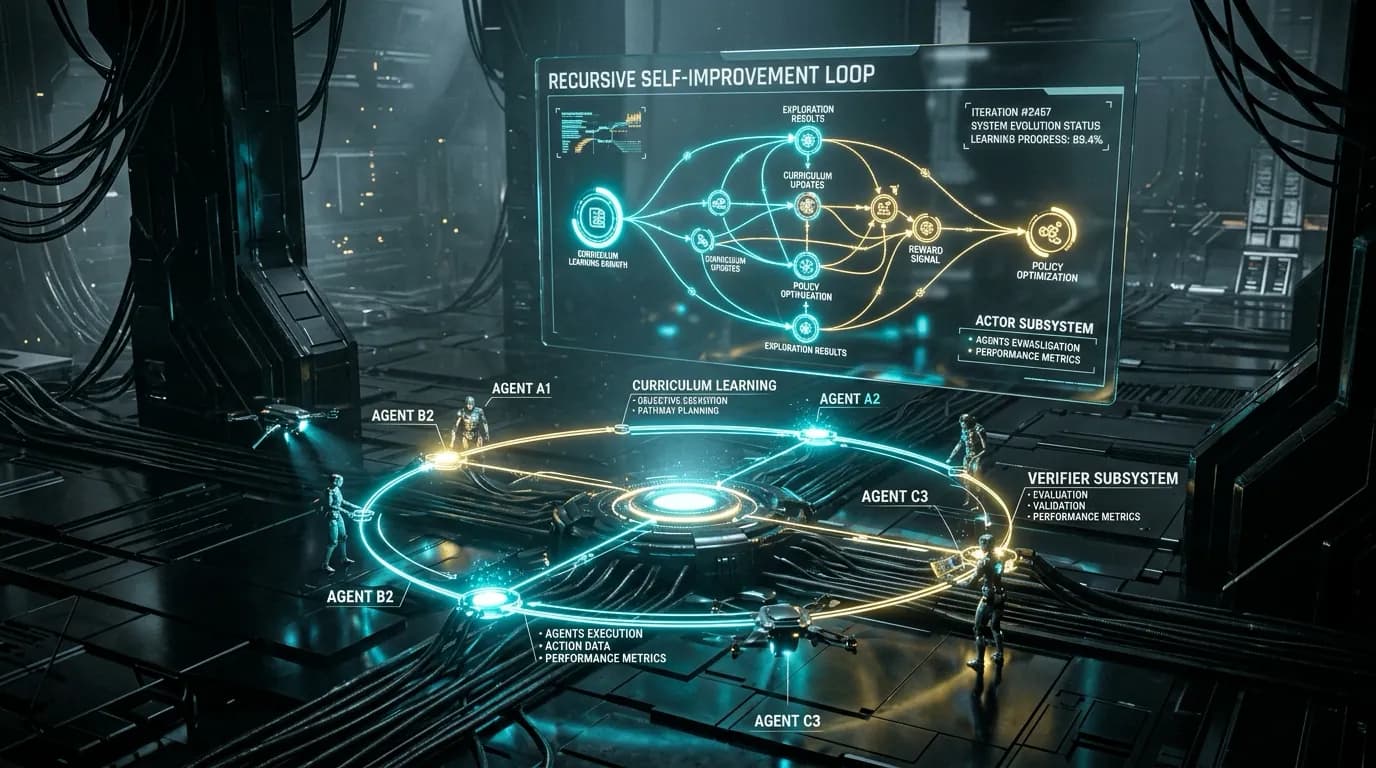
Makalah frontier dari Aether AI, UC San Diego, dan University of Illinois Chicago arXiv:2609.15364 (September 2026, Sibo Zhu, Shicheng Fan, Xinyue Wang, Wenyi Wu, Kun Zhou, Biwei Huang) memecahkan salah satu dilema terbesar dalam evolusi agen otonom: bagaimana sebuah sistem AI dapat meningkatkan kapabilitasnya secara rekursif dalam lingkungan perangkat lunak asing tanpa harus melatih ulang (fine-tuning) bobot model dasar? Melalui RSIAgent, kerangka kerja multi-agent mengeksekusi eksplorasi dua tahap (Broad-then-Deep), mengonstruksi memori kausalitas yang dapat diverifikasi, membekukan akumulasi prosedur, dan berhasil mengantarkan model open-source (Kimi-K3 & GLM-5.3) melibas model proprietary terkuat seperti GPT-6 Astra dan Claude Opus 5 pada benchmark OSWorld 2.0 (78.98/100) dan Agents' Last Exam (84.82/100).
# Daftar Isi & Peta Arsitektur
- 1. The Next Attempt Should Not Start From Zero: Jebakan Amnesia AI Agent
- 2. Triad Multi-Agent Harness: Pemisahan Peran Curriculum, Actor, dan Verifier
- 3. Broad Recursive Self-Exploration (BRS): Pemetaan Topologi Lingkungan Multi-Proyek
- 4. Deep Recursive Self-Exploration (DRS): Menembus Hidden Constraints & Boundary Conditions
- 5. Causal Memory Construction & Paradigma Frozen Memory Reuse
- 6. Implementasi Referensi Produksi: RSIAgent Orchestration Engine (Python)
- 7. Evaluasi Empiris Menyeluruh: Rekor Baru di OSWorld 2.0 & Agents' Last Exam
- 8. Implikasi Arsitektural untuk Sistem AI Produksi 2026
1. The Next Attempt Should Not Start From Zero: Jebakan Amnesia AI Agent
Ketika seorang insinyur perangkat lunak manusia berhadapan dengan piranti lunak baru—misalnya sistem CAD kompleks seperti FreeCAD, Digital Audio Workstation (DAW) seperti REAPER, atau perangkat analisis data berbasis terminal grafis—interaksi awal hampir selalu dipenuhi uji coba, kegagalan parameter, dan penyesuaian konvensi API lokal. Namun, ketika manusia berhasil mengatasi suatu *edge case* (misalnya menemukan bahwa opsi sampling render audio harus bernilai RENDER_RESAMPLE 0 0 0 agar tidak menghasilkan artefak phase cancelation), pengetahuan tersebut tersimpan permanen sebagai intuisi operasional untuk seluruh tugas di masa depan.
Sebaliknya, agen otonom berbasis Large Language Models (LLM) konvensional beroperasi di bawah kutukan amnesia epistemik. Meskipun sebuah agen mampu memperbaiki kekeliruannya di tengah percakapan panjang (in-context error recovery), begitu sesi berakhir atau lingkungan di-reset ke kondisi awal, agen tersebut kembali memulai upayanya dari titik nol (starts from zero). Agen dipaksa untuk menabrak dinding kegagalan yang persis sama, menghabiskan ribuan token penalaran berulang, dan kerap gagal menuntaskan tugas-tugas dengan rentang langkah panjang (long-horizon workflows).
Pendekatan klasik untuk mengatasi kelemahan ini adalah pelatihan pasca-rilis (post-training reinforcement learning atau fine-tuning bobot model). Namun, memperbarui parameter model raksasa (mencapai ratusan miliar parameter) untuk setiap aplikasi pihak ketiga yang dinamis sangat tidak realistis: biayanya luar biasa mahal, rentan mengalami catastrophic forgetting, dan siklus perubahannya terlalu lambat untuk lingkungan *enterprise* yang terus diperbarui. RSIAgent membalikkan paradigma ini: Recursive Self-Improvement dicapai melalui rekayasa memori kausal eksternal yang terstruktur, tanpa menyentuh satu pun bobot neural network dasar.
2. Triad Multi-Agent Harness: Pemisahan Peran Curriculum, Actor, dan Verifier
Fondasi operasional RSIAgent bertumpu pada arsitektur triad terisolasi yang memecah siklus hidup eksplorasi menjadi tiga agen spesialis independen dengan tanggung jawab yang tidak saling tumpang tindih:
Curriculum Agent
Menganalisis lingkungan operasional dan merancang kurikulum tugas sintesis (self-proposed exploration tasks). Agen ini menerima deskripsi tujuan umum dan merumuskan sub-proyek terarah yang menguji fitur-fitur kritis tanpa campur tangan manusia.
Actor Agent
Mengeksekusi rencana aksi melalui kode executable (Code as Policy). Actor berinteraksi langsung dengan sistem operasi, CLI, GUI, dan API software, mengamati standard output, serta memodifikasi kode eksekusi saat menghadapi error di level runtime.
Verifier Agent
Mengaudit keabsahan hasil eksekusi secara independen. Verifier bertindak sebagai wasit objektif yang memeriksa integritas artefak yang dihasilkan (misalnya validitas file SVG/CAD atau waveform audio), mencegah halusinasi keberhasilan dari Actor.
Pemisahan konteks ini sangat krusial. Dalam banyak arsitektur agen tunggal (single-agent harness), model yang merencanakan tindakan cenderung bias dalam mengevaluasi hasil tindakannya sendiri (confirmation bias). Dalam RSIAgent, verifikator beroperasi dalam konteks yang bersih dan ketat, menjamin bahwa hanya prosedur yang benar-benar berhasil yang dikristalisasikan ke dalam repositori memori.
3. Broad Recursive Self-Exploration (BRS): Pemetaan Topologi Lingkungan Multi-Proyek
Ketika sistem AI diterjunkan ke dalam lingkungan perangkat lunak baru yang belum dikenal, eksplorasi tidak dilakukan secara buta atau acak. Tahap pertama RSIAgent dinamai Broad Recursive Self-Exploration (BRS).
Dalam fase BRS, Curriculum Agent menghasilkan matriks eksplorasi yang terdiri dari 8 sub-proyek independen yang mencakup berbagai fungsionalitas inti piranti lunak target. Sub-proyek ini dijalankan secara paralel dalam gelombang (waves) hingga 4 thread eksekusi konkuren. Setiap sub-proyek dirancang untuk memetakan:
- Sintaks Antarmuka & CLI: Pola penamaan opsi, flag perintah bash, lokasi konfigurasi default, dan arsitektur filesystem aplikasi.
- Interaksi GUI via Automasi OS: Titik koordinat elemen UI kunci, shortcut keyboard, struktur menu konteks, dan responsivitas event loop windowing.
- Format Pertukaran Data & Ekspor: Format file yang didukung, resolusi default render, konvensi header metadata, dan toleransi kompresi.
Pada akhir gelombang paralel, anggaran komputasi (budget token dan execution steps) dicek secara dinamis. Hasil-hasil positif dikonsolidasikan, sementara kegagalan awal dianalisis polanya untuk mempersiapkan fase penajaman berikutnya.
4. Deep Recursive Self-Exploration (DRS): Menembus Hidden Constraints & Boundary Conditions
Pengetahuan permukaan yang dikumpulkan selama fase BRS belum cukup untuk menyelesaikan tugas-tugas dunia nyata yang sarat jebakan teknis. Oleh karena itu, RSIAgent melanjutkan siklusnya ke Deep Recursive Self-Exploration (DRS).
Berbeda dengan BRS yang bersifat paralel dan melebar, DRS bersifat sekuensial dan mendalam. Curriculum Agent memilih tugas-tugas eksplorasi yang secara khusus menguji batas toleransi lingkungan (stress-testing edge cases). Fokus utama DRS adalah membongkar hidden constraints (pembatas tersembunyi yang tidak tertulis dalam dokumentasi standar):
Studi Kasus Nyata Penemuan Hidden Constraint: DAW REAPER (Task T085)
Dalam pengujian rendering radio bumper audio berdurasi multi-detik pada REAPER, agen dasar secara konsisten mengalami kegagalan sample mismatch saat menggabungkan segmen vokal dan sting penutup. Pada eksplorasi BRS, agen menduga bahwa pemotongan durasi salah. Namun, melalui DRS sekuensial:
- Actor mencoba merender audio melalui skrip manipulasi batch native REAPER.
- Verifier membandingkan payload waveform hasil render dengan ekspektasi referensi dan mendeteksi distorsi frekuensi tinggi.
- Curriculum menginstruksikan Actor untuk menyelidiki pengaturan resampling project.
- Actor menemukan bahwa setting default REAPER menerapkan interpolasi yang mengubah fasa gelombang, lalu mengoreksi konfigurasi menjadi
RENDER_RESAMPLE 0 0 0. - Verifier memvalidasi bahwa payload sampel kini 100% identik. Pelajaran ini langsung dikristalisasikan ke dalam Causal Memory Bank.
DRS terus berjalan secara adaptif hingga Curriculum Agent menyimpulkan bahwa tidak ada lagi ketidakpastian atau anomali yang belum terpetakan dalam alur kerja target.
5. Causal Memory Construction & Paradigma Frozen Memory Reuse
Kunci dari keunggulan RSIAgent terletak pada bagaimana pengalaman dienkapsulasi. Alih-alih menyimpan log obrolan mentah (raw prompt traces) yang menghabiskan context window dan penuh noise, RSIAgent menyusun Causal Memory Bank.
Setiap entri memori merupakan relasi sebab-akibat terstruktur yang memuat kuartet data fundamental:
| Komponen Memori | Deskripsi Fungsional | Contoh Representasi |
|---|---|---|
| Trigger Condition | Kondisi status sistem atau tanda pengenal antarmuka saat aturan relevan | reaper_render_multi_stem_export |
| Action Sequence | Blok kode eksekusi terverifikasi (bash/python script) | apply_config("RENDER_RESAMPLE 0 0 0") |
| Boundary Constraints | Batas toleransi parameter, alokasi memori, timeout, atau versi API | sample_rate == 44100, channels == 2 |
| Verification Proof | Skor validitas objektif dan stempel pengesahan dari Verifier Agent | verified: true, confidence: 0.98 |
Setelah fase BRS dan DRS tuntas, Memori Kausal Dibekukan (Frozen Memory Bank). Lingkungan sistem operasi di-reset sepenuhnya ke kondisi awal (environment wipe) untuk mensimulasikan tugas nyata baru. Saat tugas hilir dievaluasi, agen mengakses memori terbekukan ini sebagai pedoman referensi tanpa perlu melakukan eksplorasi ulang. Tidak ada parameter neural yang berubah, namun performa agen melesat drastis karena ia telah "mengenal" sistem tersebut seperti seorang ahli.
6. Implementasi Referensi Produksi: RSIAgent Orchestration Engine (Python)
Berikut adalah implementasi referensi produksi yang memperlihatkan orkestrasi triad agent, pengelolaan status eksplorasi dua fase, dan pembekuan memori kausal:
"""
RSIAgent Core Architecture: Triad Autonomous Exploration & Causal Memory Engine
Berdasarkan Makalah Frontier arXiv:2609.15364 (Zhu et al., Aether AI & UCSD)
Implementasi Produksi Triad Agent (Curriculum, Actor, Verifier) & Dual-Phase Exploration.
"""

from dataclasses import dataclass, field
from typing import List, Dict, Any, Optional
import json
import enum

class ExplorationPhase(enum.Enum):
    BROAD_PARALLEL = "BRS"      # Broad Recursive Self-Exploration
    DEEP_SEQUENTIAL = "DRS"     # Deep Recursive Self-Exploration
    EVAL_FROZEN = "EVAL"        # Evaluasi dengan Memori Terbekukan

@dataclass
class CausalRule:
    """Struktur memori kausalitas yang dapat digunakan kembali (reusable experience)."""
    trigger_condition: str
    action_sequence: List[str]
    expected_outcome: str
    boundary_constraints: List[str]
    success_rate: float
    verified_by_verifier: bool

class CausalMemoryBank:
    """Memory Bank untuk menyimpan, mengindeks, dan membekukan pengalaman eksplorasi."""
    def __init__(self):
        self.rules: List[CausalRule] = []
        self.is_frozen: bool = False

    def append_rule(self, rule: CausalRule) -> None:
        if self.is_frozen:
            raise RuntimeError("MemoryBank telah dibekukan (frozen) untuk tahap evaluasi inferensi.")
        self.rules.append(rule)

    def freeze(self) -> None:
        """Membekukan memori sebelum eksekusi tugas hilir (downstream evaluation)."""
        self.is_frozen = True

    def retrieve_relevant_knowledge(self, task_context: str) -> List[CausalRule]:
        """Pengambilan aturan kausal relevan berdasarkan konteks antarmuka/perangkat lunak."""
        return [r for r in self.rules if r.verified_by_verifier and r.success_rate >= 0.85]

class CurriculumAgent:
    """Agen kurikulum: Merancang agenda eksplorasi topologi lingkungan."""
    def __init__(self, model_name: str = "Kimi-K3"):
        self.model_name = model_name

    def generate_exploration_matrix(self, env_description: str, phase: ExplorationPhase) -> List[Dict[str, Any]]:
        if phase == ExplorationPhase.BROAD_PARALLEL:
            # Merancang 8 sub-proyek independen (eksplorasi luas paralel)
            return [
                {"project_id": f"BRS-{i+1}", "target_subsystem": f"module_{i+1}", "budget_steps": 12}
                for i in range(8)
            ]
        elif phase == ExplorationPhase.DEEP_SEQUENTIAL:
            # Merancang pengujian mendalam pada boundary conditions & edge cases
            return [
                {"project_id": "DRS-DeepRefine", "target_subsystem": "critical_flow", "budget_steps": 25}
            ]
        return []

class ActorAgent:
    """Agen pelaksana: Mengonversi rencana menjadi kode eksekusi nyata (Code-as-Policy)."""
    def __init__(self, model_name: str = "GLM-5.3"):
        self.model_name = model_name

    def execute_plan_step(self, task: Dict[str, Any], memory: CausalMemoryBank) -> Dict[str, Any]:
        prior_rules = memory.retrieve_relevant_knowledge(task.get("target_subsystem", ""))
        # Menghasilkan payload kode eksekusi berbasis pengalaman lampau
        execution_payload = {
            "action": "execute_shell_and_gui",
            "script": f"# Executing exploration for {task['project_id']}\napply_rules({len(prior_rules)})",
            "observed_state": {"exit_code": 0, "artifacts_generated": True}
        }
        return execution_payload

class VerifierAgent:
    """Agen verifikator: Memvalidasi artefak keluaran secara independen tanpa bias aktor."""
    def __init__(self, model_name: str = "Kimi-K3"):
        self.model_name = model_name

    def verify_execution(self, step_result: Dict[str, Any]) -> Dict[str, Any]:
        exit_code = step_result.get("observed_state", {}).get("exit_code", -1)
        is_valid = (exit_code == 0)
        return {
            "is_valid": is_valid,
            "verifier_score": 0.95 if is_valid else 0.20,
            "remediation_feedback": None if is_valid else "Periksa timeout atau dependensi pustaka."
        }

class RSIAgentFramework:
    """Orkestrator Triad RSIAgent: BRS -> DRS -> Freeze -> Evaluation."""
    def __init__(self):
        self.curriculum = CurriculumAgent()
        self.actor = ActorAgent()
        self.verifier = VerifierAgent()
        self.memory = CausalMemoryBank()

    def run_broad_exploration(self, env_spec: str) -> None:
        matrix = self.curriculum.generate_exploration_matrix(env_spec, ExplorationPhase.BROAD_PARALLEL)
        for proj in matrix:
            res = self.actor.execute_plan_step(proj, self.memory)
            verification = self.verifier.verify_execution(res)
            if verification["is_valid"]:
                self.memory.append_rule(CausalRule(
                    trigger_condition=f"env_state_{proj['target_subsystem']}",
                    action_sequence=[res["script"]],
                    expected_outcome="success",
                    boundary_constraints=["timeout_10s"],
                    success_rate=verification["verifier_score"],
                    verified_by_verifier=True
                ))

    def run_deep_refinement(self, env_spec: str) -> None:
        deep_tasks = self.curriculum.generate_exploration_matrix(env_spec, ExplorationPhase.DEEP_SEQUENTIAL)
        for task in deep_tasks:
            res = self.actor.execute_plan_step(task, self.memory)
            verification = self.verifier.verify_execution(res)
            if verification["is_valid"]:
                self.memory.append_rule(CausalRule(
                    trigger_condition="deep_boundary_case",
                    action_sequence=[res["script"]],
                    expected_outcome="verified_state",
                    boundary_constraints=["memory_capped"],
                    success_rate=verification["verifier_score"],
                    verified_by_verifier=True
                ))

    def prepare_for_evaluation(self) -> CausalMemoryBank:
        """Tahap 3: Bekukan memori untuk eksekusi downstream tanpa retraining bobot model."""
        self.memory.freeze()
        return self.memory
7. Evaluasi Empiris Menyeluruh: Rekor Baru di OSWorld 2.0 & Agents' Last Exam
Efektivitas RSIAgent diuji secara komprehensif pada dua tolok ukur evaluasi agen otonom paling menuntut di dunia: OSWorld 2.0 (82 tugas manipulasi sistem operasi grafis dan CLI tingkat lanjut) dan Agents' Last Exam (ALE Near-term) (67 tugas multi-modal dunia nyata berskala penuh).
| Model / Arsitektur Harness | OSWorld 2.0 (Partial) | OSWorld 2.0 (Binary) | ALE Near-term (Partial) | ALE Near-term (Binary) |
|---|---|---|---|---|
| Kimi-K2.6 (Baseline Open Source) | 22.10% | 4.60% | 21.70% | 9.20% |
| DeepSeek V4 Pro | — | — | 43.81% | 19.90% |
| Qwen3.8-Max | — | — | 52.50% | 27.00% |
| Kimi-K3 (Direct Baseline) | 58.30% | — | 71.60% | 40.30% |
| Claude Opus 4.8 (Closed Frontier) | 54.80% | 20.60% | 64.00% | |
| GPT-5.6 Sol | 64.13% | 31.20% | 78.82% | 44.10% |
| Claude Opus 5 | 70.19% | 35.40% | 79.54% | 46.50% |
| GPT-6 Astra (State-of-the-Art Closed) | 72.60% | 37.80% | 82.26% | 49.25% |
| RSIAgent (Kimi-K3 + GLM-5.3) | 78.98% (+7.01) | 42.68% (+4.88) | 84.82% (+1.07) | 50.75% (+1.50) |
Hasil benchmark di atas mendemonstrasikan implikasi yang sangat luar biasa:
- Model Open-Source Melibas Closed Frontier: Dengan memanfaatkan RSIAgent, kombinasi model terbuka Kimi-K3 dan GLM-5.3 melonjak skor parsialnya dari 58.30% menjadi 78.98% pada OSWorld 2.0—secara meyakinkan mengungguli GPT-6 Astra (72.60%) dan Claude Opus 5 (70.19%).
- Success Rate Penuh Melejit (+12.9% Relatif): Pada metrik binary success rate di OSWorld, kemampuan menyelesaikan tugas secara sempurna meningkat dari 37.80% menjadi 42.68%.
- Efisiensi Uji Coba: Pada tugas audio DAW T085, skor parsial melonjak dari 0.6800 pada baseline menjadi 0.9415 setelah akumulasi memori, membuktikan bahwa agen tidak lagi tersandung pada kejanggalan formatting atau konfigurasi tool.
8. Implikasi Arsitektural untuk Sistem AI Produksi 2026
Bagi tim AI Engineering, platform pengembang agen, dan arsitek sistem yang membangun asisten otonom berskala industri, temuan RSIAgent memberikan panduan desain yang sangat aplikatif:
A Pisahkan Harness Menjadi Triad Eksekusi
Jangan pernah membebankan perumusan tugas, eksekusi kode, dan verifikasi hasil ke dalam prompt monolitik tunggal. Pisahkan verifikator ke dalam konteks independen yang menguji artefak fisik tanpa terpengaruh oleh 'rasa percaya diri' model pelaksana.
B Terapkan Mekanisme Freeze Memory Sebelum Evaluasi
Eksplorasi dinamis harus dipisahkan secara tegas dari fase eksekusi hilir. Sebelum menjalankan tugas operasional klien atau benchmark produksi, bekukan Causal Memory Bank agar inferensi menjadi deterministik, hemat token, dan kebal dari siklus modifikasi memori yang merusak (memory drift).
Kesimpulan Redaksi NEWSAINT
RSIAgent membuktikan bahwa lompatan kecerdasan AI otonom masa depan tidak semata-mata ditentukan oleh skala parameter model (scaling laws) atau pembaruan bobot via backpropagation. Dengan arsitektur Recursive Self-Improvement berbasis eksplorasi mandiri dan retensi kausalitas terstruktur, kita dapat mengubah model yang awalnya 'asing' menjadi sistem pakar yang adaptif dan konsisten.
Paradigma The next attempt should not start from zero bukan lagi sekadar visi teoretis, melainkan arsitektur nyata yang siap diterapkan di lini produksi kecerdasan buatan 2026.
Referensi & Sumber Terverifikasi
- [1]RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments(arXiv:2609.15364 [cs.AI, cs.LG] — Sibo Zhu, Shicheng Fan, Xinyue Wang, Wenyi Wu, Kun Zhou, Biwei Huang (Aether AI, UCSD, UIC))
- [2]Official RSIAgent Research Project Portal & Interactive Findings(Aether AI Research / Project Site)
- [3]Official RSIAgent Open-Source Implementation Repository(GitHub Repository: AetherLabsAI/RSIAgent)
- [4]OSWorld: Benchmarking Multimodal Agents on Desktop Operating System Environments(arXiv:2404.07972 [cs.AI] — Tianbao Xie et al.)
- [5]Agents' Last Exam: A Benchmark for Evaluating Multimodal Agents on Complex Real-World Tasks(Center for AI Safety (CAIS) / arXiv:2502.13175)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.