Second Thought 2026: Arsitektur Parallel Reasoning pada Reasoning Idle Window Agen Otonom, Asynchronous Trajectory Continuation, dan Reduksi 43% Token Decoding ReAct
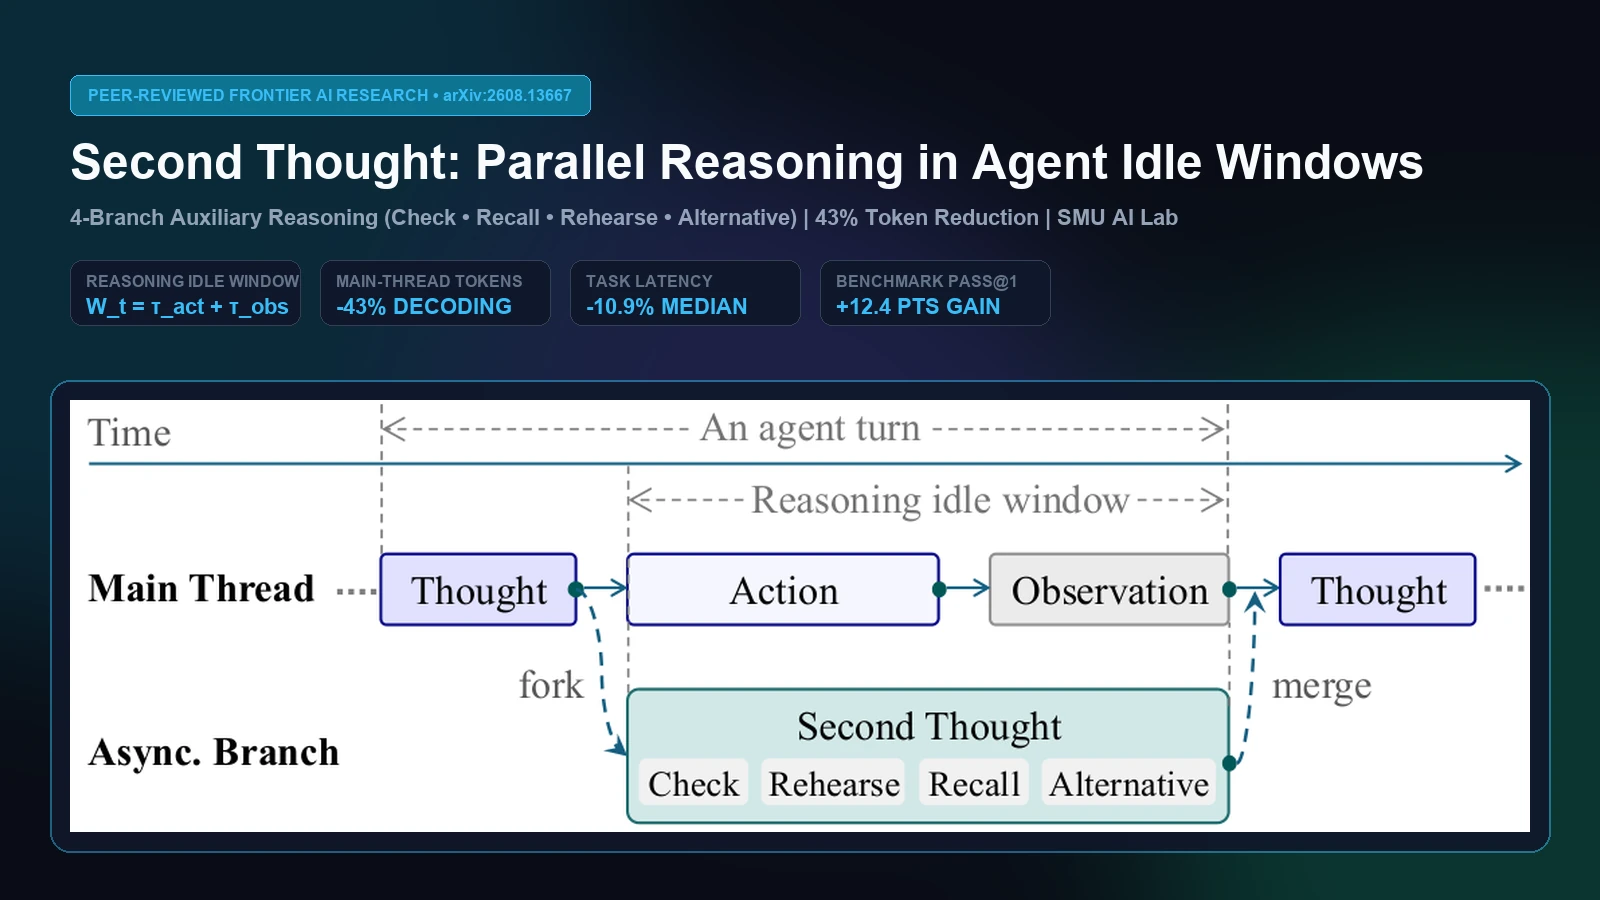
Analisis arsitektur sistemik riset frontier AI agent dari Singapore Management University (arXiv:2608.13667, Zhensu Sun, Chengran Yang, Yunbo Lyu, Jieke Shi, David Lo, Agustus 2026): Mengapa paradigma ReAct konvensional membekukan penalaran model selama fase Action dan Observation sehingga menciptakan jendela waktu menganggur (Reasoning Idle Window). Menghadirkan Second Thought, framework inferensi training-free yang melakukan forking 4 cabang penalaran asinkron (Check, Recall, Rehearse, Alternative) memanfaatkan prefix KV-cache bersama seketika fase Thought selesai. Dilengkapi protokol Atomic Thoughts bertag XML mandiri yang imun terhadap interupsi eksekusi, Second Thought memangkas jumlah turn rata-rata di seluruh 9 pasangan model-benchmark, memotong token decoding thread utama hingga 43%, mendongkrak Pass@1 hingga +12.4 poin pada Terminal-Bench 2.1, serta mempercepat latensi wall-clock median sebesar 10.9% pada evaluasi SWE-Bench Pro dan tau^3-bench.
Second Thought: Eksploitasi Reasoning Idle Window untuk Penalaran Paralel Asinkron Tanpa Menambah Latensi Critical Path
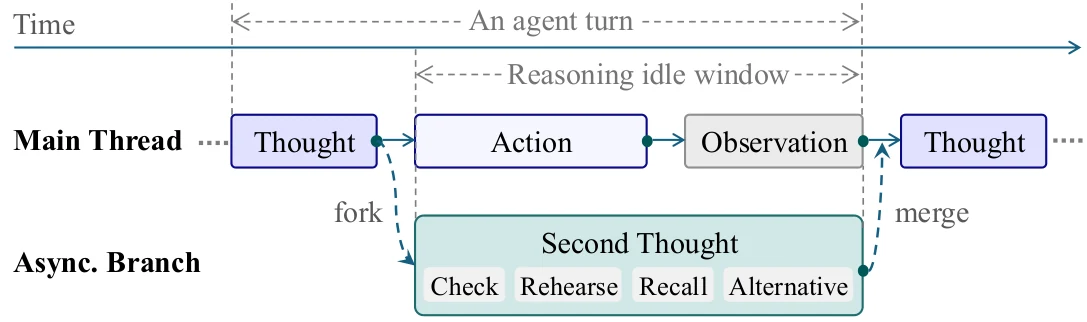
Dalam paradigma ReAct (Reasoning + Acting) yang mendominasi seluruh arsitektur agen AI otonom saat ini, proses penalaran deliberatif hanya berlangsung secara sekuensial di dalam fase Thought. Seketika model menghasilkan rencana, penalaran dibekukan: agen harus menunggu serialisasi Action (pemanggilan alat atau tool execution) dan respon dari lingkungan (Observation). Interval contiguous ini—didefinisikan sebagai Reasoning Idle Window (W_t = τ_act + τ_obs)—selalu terbuang sia-sia pada setiap putaran (turn).
Riset frontier terbaru dari Singapore Management University (arXiv:2608.13667) memperkenalkan Second Thought: framework inferensi training-free yang membelah alur komputasi seketika fase Thought selesai menjadi 4 cabang asinkron komplementer (Check, Recall, Rehearse, Alternative) yang berjalan paralel di latar belakang selama alat dieksekusi. Beroperasi dengan protokol Atomic Thoughts yang kebal terhadap interupsi acak saat observasi kembali, Second Thought berhasil menurunkan jumlah putaran rata-rata pada seluruh 9 pasangan model-benchmark, memangkas token decoding sekuensial pada thread utama hingga 43%, mendongkrak Pass@1 hingga +12.4 poin pada Terminal-Bench 2.1, dan menurunkan latensi per-task median sebesar 10.9% pada lingkungan kontainer SWE-Bench Pro.
1. Paradoks Scaling Inference-Time: Mengapa Menambah Token Berpikir Memperlambat Agen Otonom
Kemajuan model reasoning modern (seperti OpenAI o1/o3, DeepSeek-R1, hingga Gemini Flash Reasoning) membuktikan bahwa penskalaan komputasi inferensi (inference-time compute scaling) secara eksponensial meningkatkan akurasi pemecahan masalah kompleks. Namun, pada ranah software engineering dan manipulasi terminal, penskalaan ini membawa paradoks mendasar: setiap token penalaran tambahan dihasilkan secara sekuensial pada jalur kritis (critical path).
Pada loop ReAct klasik, agen beroperasi secara berulang melalui tiga tahapan:
- Fase Thought (τthink): Model menghasilkan penalaran eksplisit
R_tuntuk mengevaluasi riwayat keadaan (trajectory history)H_tdan merumuskan rencana tindakan berikutnya. - Fase Action (τact): Model menserialisasi pemanggilan perkakas (tool invocation)
A_t, seperti menjalankan perintah shell, membaca file, atau mengirim kueri SQL. - Fase Observation (τobs): Lingkungan eksekusi (seperti sandbox Docker, terminal OS, atau REST API) memproses perintah dan mengembalikan luaran teks/status
O_t.
Total latensi satu putaran adalah akumulasi sekuensial:
Kelemahan struktural ReAct terletak pada pembekuan penalaran deliberatif di luar fase Thought. Selama fase Action dan Observation, kapasitas komputasi model dibiarkan nonaktif sepenuhnya. Jendela waktu kontigu ini:
disebut oleh para peneliti sebagai Reasoning Idle Window. Pada tugas rekayasa perangkat lunak nyata (seperti menjalankan unit test, melakukan kompilasi proyek C++/Rust, atau melakukan indexing kode), W_t dapat berlangsung dari 2 detik hingga puluhan detik. Membiarkan jendela ini kosong adalah inefisiensi arsitektural yang masif.
2. Batasan Teknik Paralelisasi Konvensional: Tree-of-Thought vs Idle Window
Pendekatan penalaran paralel yang sudah ada—seperti Self-Consistency (Wang et al.), Tree-of-Thought (Yao et al.), atau Multi-Agent Debate—memparalelkan komputasi di dalam fase Thought itu sendiri dengan cara mengambil sampel horizontal beberapa rantai pemikiran kandidat secara bersamaan. Meskipun efektif memperluas ruang pencarian, teknik-teknik ini tidak dapat diterapkan langsung ke dalam jendela W_t karena tiga rintangan utama:
Durasi yang Tak Menentu
Durasi W_t sepenuhnya ditentukan oleh lingkungan eksternal (misal: kecepatan eksekusi bash script atau koneksi jaringan). Agen tidak dapat memprediksi kapan observasi O_t akan kembali, sehingga rantai penalaran panjang yang belum selesai akan terpotong paksa dan menjadi sampah sintaksis jika tidak dirancang modular.
Overhead Latensi Kritis
Jika proses pengambilan keputusan berikutnya harus menunggu cabang paralel selesai, maka latensi terpanjang (straggler problem) justru akan memperlambat jalur kritis agen, menghancurkan interaktivitas sistem.
Overhead Encoding Ulang
Mempekerjakan modul external critic atau agen pemeriksa terpisah memerlukan prompt hand-off baru, serialisasi ringkasan konteks, dan kalkulasi ulang representasi laten (KV-cache) yang memboroskan memori VRAM GPU server.
3. Arsitektur Second Thought: Trajectory Continuation & Prefix KV-Cache Sharing
Alih-alih menginstansiasi model eksternal, Second Thought memanfaatkan model yang sama untuk melanjutkan (continue) keadaannya sendiri. Begitu fase Thought R_t selesai pada thread utama:
- Instant Forking via Prefix KV-Cache: Keempat cabang asinkron menerima snapshot riwayat percakapan yang identik: riwayat penuh
H_tdigabungkan denganR_tyang baru saja terbentuk. Karena semua cabang berbagi prompt prefix yang sama persis dengan thread utama, prefix KV-cache digunakan kembali tanpa komputasi prefill ulang, menghemat bandwidth memori GPU hingga mendekati nol overhead inisialisasi. - Penonaktifan Native Thinking pada Cabang Pembantu: Cabang-cabang pembantu menonaktifkan tag penalaran internal model agar langsung memancarkan token pikiran eksplisit secepat mungkin sebelum jendela
W_ttertutup oleh datangnya respon lingkungan. - Dekomposisi 4 Dimensi Penalaran Komplementer: Masing-masing cabang dipandu oleh instruksi khusus untuk mengeksplorasi dimensi kognitif ortogonal yang dirancang untuk menangkal kelemahan umum LLM.
4. Taksonomi 4 Dimensi Penalaran: Check, Recall, Rehearse, dan Alternative
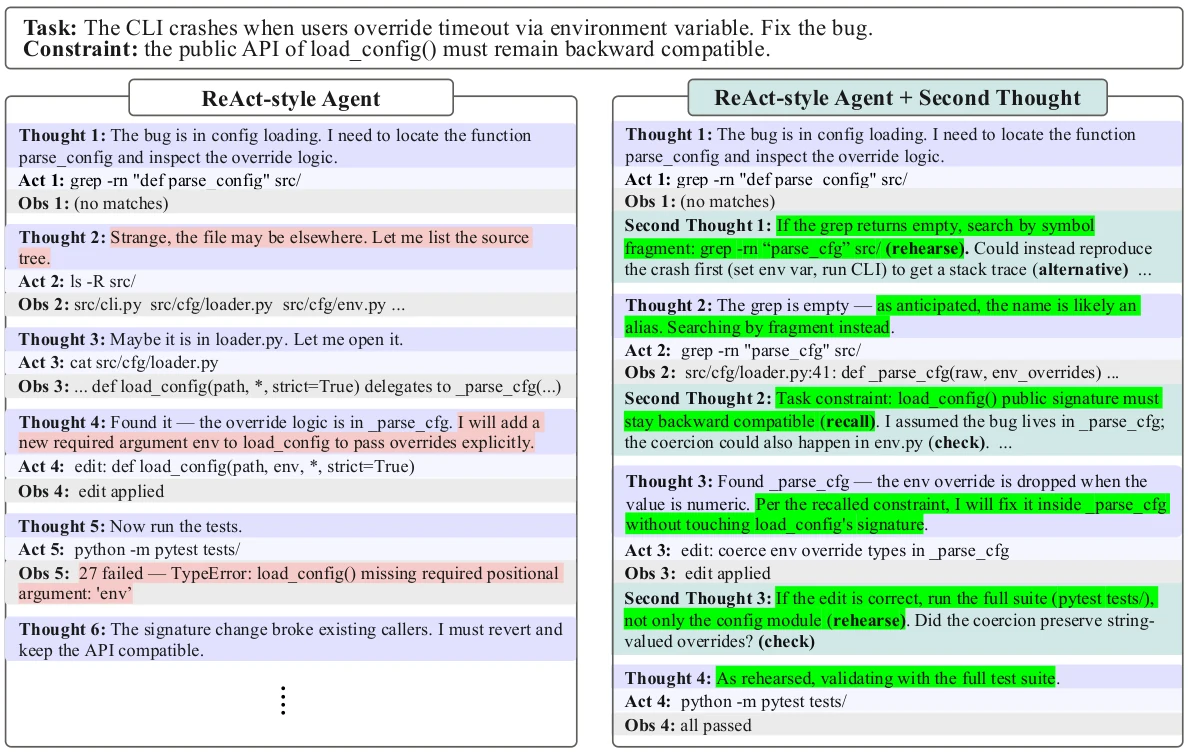
Para peneliti merancang 4 dimensi penalaran yang secara spesifik menargetkan bias kognitif dan kegagalan umum agen otonom pada lintasan panjang (long-horizon trajectories):
Audit Kerapuhan Asumsi Lingkungan
Agen sering kali berkomitmen pada tindakan yang secara implisit mengasumsikan status lingkungan yang belum terverifikasi (misal: mengasumsikan test framework adalah pytest tanpa memeriksa file setup.cfg atau pyproject.toml). Cabang Check secara kritis mengaudit R_t terhadap asumsi rapuh yang berpotensi digugurkan oleh observasi yang akan datang.
Resurfacing Batasan & Spesifikasi Global
Pada lintasan panjang puluhan putaran, instruksi atau batasan penting yang didefinisikan di awal (seperti "Pertahankan backward compatibility untuk Python 3.9") sering kali mengalami degradasi atensi (lost in the middle). Cabang Recall memunculkan kembali batasan historis dari H_t yang masih aktif dan relevan agar tidak dilanggar pada langkah berikutnya.
Pre-komputasi Tindakan Kontinjensi & Fallback
Saat perkakas mengembalikan luaran kosong atau error (misal: grep tidak menemukan kecocokan simbol), agen ReAct standar membuang 1 putaran penuh hanya untuk bingung dan merencanakan ulang dari nol. Cabang Rehearse mensimulasikan kemungkinan hasil negatif dan menyiapkan tindakan cadangan siap pakai seketika observasi tiba.
Eksplorasi Hipotesis Ortogonal
Agen memiliki kecenderungan keras kepala (tunnel-vision) untuk memaksakan strategi yang sama berulang kali meskipun gagal beruntun. Cabang Alternative memproduksi sudut pandang alternatif untuk akar masalah yang sama, memungkinkan agen beralih rute secara tangkas tanpa harus mengalami kegagalan berulang.
5. Protokol Atomic Thoughts & Pemanenan Robust saat Observasi Tiba
Kunci keberhasilan implementasi Second Thought terletak pada penanganan interupsi non-deterministik. Karena lingkungan dapat merespons dalam 100 milidetik atau 15 detik, output cabang penalaran harus tetap memiliki nilai semantik yang valid bahkan jika eksekusi dipotong di tengah kalimat.
Second Thought memberlakukan dua kontrak struktural ketat:
- Pembatasan Panjang Unit (≤ 25 Kata): Setiap pemikiran dibatasi maksimal 25 kata dan dilarang membuat referensi silang ke unit lain dalam stream yang sama. Setiap unit berdiri sendiri sebagai satu wawasan atomik.
- Pembungkus XML Eksplisit (
<thought> ... </thought>): Parser hanya memanen unit yang tag penutupnya telah terbentuk sempurna sebelum sinyal pembatalan tiba. Token yang belum ditutup langsung dibuang tanpa meninggalkan residu format yang merusak context window. - Plafon Pemanenan (Max 5 Thoughts/Dimensi): Jumlah pemikiran yang disuntikkan ke putaran berikutnya dibatasi maksimal 5 unit per dimensi. Ini mencegah pembengkakan context window secara eksponensial (context pollution).
Pada putaran t + 1, thread utama membaca riwayat lengkap secara sekuensial: penalaran sebelumnya R_t, tindakan A_t, hasil observasi lingkungan O_t, dan blok second thoughts yang berhasil dipanen. Dengan demikian, model memasuki fase berpikir putaran berikutnya dengan wawasan tambahan yang siap dikonsumsi seketika tanpa jeda.
6. Evaluasi Empiris: 3 LLM Reasoning, 3 Tolak Ukur Standar, dan Penghematan Token 43%
Para peneliti mengevaluasi Second Thought pada tiga model reasoning frontier dari keluarga arsitektur yang berbeda: DeepSeek-V4-Flash, Qwen3.6-Plus, dan MiniMax-M3, diuji pada tiga tolak ukur evaluasi agen dunia nyata:
- SWE-Bench Pro: 150 repositori rekayasa perangkat lunak nyata dengan batas 100 putaran dan verifikasi suite test fail-to-pass.
- Terminal-Bench 2.1: 89 tugas administrasi sistem, data pipeline, dan build perangkat lunak di dalam container CLI Linux.
- τ3-bench: 97 skenario multi-turn layanan pelanggan perbankan dengan interaksi dialog pengguna dan penarikan kebijakan tak terstruktur.
| Model Evaluasi | Benchmark | Vanilla ReAct Turn | Second Thought Turn | Reduksi Token Thread Utama | Delta Pass@1 |
|---|---|---|---|---|---|
| Qwen3.6-Plus | SWE-Bench Pro | 28.4 turn | 23.1 turn | -43.0% (36.5k → 20.8k) | 51.3% (-0.7%) |
| Qwen3.6-Plus | Terminal-Bench 2.1 | 16.8 turn | 14.2 turn | +24.8% (eksplorasi baru) | +12.4% (58.4% → 70.8%) |
| τ3-bench (Banking) | 12.5 turn | 10.1 turn | 9.2 turn | -21.4% | +10.2% |
| DeepSeek-V4-Flash | SWE-Bench Pro | 31.2 turn | 25.6 turn | -28.6% | +1.4% |
| DeepSeek-V4-Flash | Terminal-Bench 2.1 | 18.5 turn | 15.9 turn | -16.2% | +4.5% |
| MiniMax-M3 | SWE-Bench Pro | 29.8 turn | 24.5 turn | -22.1% | +0.8% |
Temuan Empiris Krusial:
- Penurunan Jumlah Putaran Universal: Second Thought menurunkan rata-rata putaran tugas pada seluruh 9 pasangan model-benchmark tanpa pengecualian. Agen lebih jarang tersesat, lebih cepat mendeteksi asumsi yang salah, dan langsung mengeksekusi rencana cadangan saat alat mengembalikan error.
- Efek Substitusi Penalaran (Reasoning Substitution Effect): Pada 6 konfigurasi, decoding token pada thread utama berkurang hingga 43%. Pemikiran atomik yang dihasilkan di latar belakang mensubstitusi kebutuhan agen untuk melakukan penalaran sekuensial yang panjang di putaran berikutnya.
- Keunggulan Melawan Baseline Sequential Compute-Matched (s1): Dibandingkan dengan agen kontrol yang dipaksa menghabiskan budget komputasi penalaran setara secara sekuensial di thread utama (baseline
s1), Second Thought meraih Pass@1 yang jauh lebih tinggi dengan decoding sekuensial 1.3× hingga 3.2× lebih sedikit. Memperpanjang CoT secara sekuensial terbukti rawan overthinking dan halusinasi berputar-putar, sementara percabangan asinkron menjaga pemikiran tetap fokus dan relevan. - Akselerasi Latensi Nyata (Wall-Clock Latency): Pengujian replay jam dinding (paired wall-clock replay) mengonfirmasi bahwa efisiensi putaran ini membuahkan penurunan latensi tugas riil sebesar 10.9% pada median waktu penyelesaian.
7. Cetak Biru Arsitektur: Implementasi Harness Second Thought Siap Pakai
Berikut adalah implementasi referensi produksi harness Second Thought Engine yang mengintegrasikan forking asinkron 4 dimensi, pemanenan sinyal abort, dan parsing atomik bertag XML:
// Production Implementation: Second Thought Asynchronous Parallel Reasoning Harness
// Berdasarkan Arsitektur SMU AI Lab (arXiv:2608.13667 - Zhensu Sun, David Lo et al.)
//
// Karakteristik Inti:
// 1. Idle Window Capitalization: W_t = tau_act + tau_obs dieksploitasi untuk 4 cabang penalaran
// 2. Trajectory Continuation via Shared Prefix KV-Cache: Tanpa re-encoding prompt awal
// 3. 4 Dimensi Penalaran Komplementer: Check, Recall, Rehearse, Alternative
// 4. Atomic Thoughts Streaming: Unit penalaran <= 25 kata bertag <thought>...</thought>
// 5. Thought Harvesting on Observation: Pembatalan instan saat O_t tiba & capping 5 thoughts/dimensi

export type ReasoningDimension = 'CHECK' | 'RECALL' | 'REHEARSE' | 'ALTERNATIVE';

export interface AtomicThought {
  dimension: ReasoningDimension;
  content: string;
  turnIndex: number;
  timestampMs: number;
}

export interface EnvironmentAction {
  toolName: string;
  parameters: Record<string, any>;
  rawCommand?: string;
}

export interface EnvironmentObservation {
  turnIndex: number;
  stdout: string;
  stderr?: string;
  exitCode: number;
  executionDurationMs: number;
}

export interface TurnTrajectory {
  turnIndex: number;
  thought: string;
  action: EnvironmentAction;
  observation?: EnvironmentObservation;
  harvestedSecondThoughts?: AtomicThought[];
}

export interface BranchInstruction {
  dimension: ReasoningDimension;
  systemPrompt: string;
}

export class SecondThoughtEngine {
  private readonly maxThoughtsPerDimension = 5;
  private readonly maxWordsPerThought = 25;

  private readonly branchInstructions: Record<ReasoningDimension, string> = {
    CHECK: 'Audit the reasoning R_t for fragile unverified assumptions. Output atomic <thought> tags (<=25 words) identifying assumptions that may break.',
    RECALL: 'Resurface high-level constraints and specifications from H_t that risk context attrition. Output atomic <thought> tags (<=25 words).',
    REHEARSE: 'Pre-compute contingency plans for possible action failure or empty returns. Output atomic <thought> tags (<=25 words) with concrete fallbacks.',
    ALTERNATIVE: 'Formulate orthogonal fix strategies to prevent premature commitment. Output atomic <thought> tags (<=25 words) suggesting alternate paths.'
  };

  /**
   * Mengekstrak unit pikiran atomik yang valid dari buffer streaming
   */
  public parseAtomicThoughts(rawStream: string, dimension: ReasoningDimension, turn: number): AtomicThought[] {
    const regex = /<thought>([\s\S]*?)<\/thought>/g;
    const thoughts: AtomicThought[] = [];
    let match: RegExpExecArray | null;

    while ((match = regex.exec(rawStream)) !== null) {
      const cleanContent = match[1].trim();
      const wordCount = cleanContent.split(/\s+/).length;

      // Filter struktural: Abaikan unit yang melebihi batas kata atau kosong
      if (cleanContent.length > 0 && wordCount <= this.maxWordsPerThought + 5) {
        thoughts.push({
          dimension,
          content: cleanContent,
          turnIndex: turn,
          timestampMs: Date.now(),
        });
      }

      if (thoughts.length >= this.maxThoughtsPerDimension) {
        break;
      }
    }

    return thoughts;
  }

  /**
   * Menjalankan siklus eksekusi ReAct dengan Second Thought Asynchronous Parallel Fork
   */
  public async executeTurnWithSecondThought(
    history: TurnTrajectory[],
    currentThought: string,
    action: EnvironmentAction,
    executeInEnvironment: (act: EnvironmentAction) => Promise<EnvironmentObservation>,
    llmBranchSampler: (dimension: ReasoningDimension, history: TurnTrajectory[], thought: string, abortSignal: AbortSignal) => Promise<string>
  ): Promise<TurnTrajectory> {
    const currentTurn = history.length + 1;
    const abortController = new AbortController();

    // 1. Mulai Jendela Menganggur (Reasoning Idle Window W_t)
    const dimensions: ReasoningDimension[] = ['CHECK', 'RECALL', 'REHEARSE', 'ALTERNATIVE'];

    // Fork 4 cabang komplementer secara asynchronous (non-blocking terhadap eksekusi environment)
    const branchPromises = dimensions.map(async (dim) => {
      try {
        const rawOutput = await llmBranchSampler(dim, history, currentThought, abortController.signal);
        return this.parseAtomicThoughts(rawOutput, dim, currentTurn);
      } catch (err: any) {
        if (err.name === 'AbortError') {
          return []; // Interupsi normal saat observasi tiba
        }
        console.warn(`[SecondThought] Error on branch ${dim}:`, err.message);
        return [];
      }
    });

    // 2. Eksekusi Action di Environment (Critical Path)
    const observation = await executeInEnvironment(action);

    // 3. Thought Harvesting: Segera batalkan cabang inferensi yang sedang berjalan
    abortController.abort();

    // Ambil hasil parsial yang berhasil diselesaikan sebelum interupsi
    const branchResults = await Promise.allSettled(branchPromises);
    const harvestedThoughts: AtomicThought[] = [];

    for (const res of branchResults) {
      if (res.status === 'fulfilled') {
        harvestedThoughts.push(...res.value);
      }
    }

    // 4. Return Turn Trajectory lengkap yang telah diperkaya Second Thoughts
    return {
      turnIndex: currentTurn,
      thought: currentThought,
      action,
      observation,
      harvestedSecondThoughts: harvestedThoughts,
    };
  }

  /**
   * Memformat Second Thoughts ke dalam konteks turn berikutnya
   */
  public formatThoughtsForNextTurn(thoughts: AtomicThought[]): string {
    if (thoughts.length === 0) return '';

    const grouped: Record<string, string[]> = {};
    for (const t of thoughts) {
      if (!grouped[t.dimension]) grouped[t.dimension] = [];
      grouped[t.dimension].push(t.content);
    }

    let block = '\n<second_thoughts>\n';
    for (const [dim, items] of Object.entries(grouped)) {
      block += `  [${dim}]\n`;
      for (const item of items) {
        block += `    - ${item}\n`;
      }
    }
    block += '</second_thoughts>\n';
    return block;
  }
}
8. Kesimpulan & Implikasi bagi Arsitektur Autonomous Coding Agents Masa Depan
Riset Second Thought (arXiv:2608.13667) membuktikan bahwa optimasi agen AI tidak melulu harus bergantung pada peningkatan ukuran parameter model atau pelatihan reinforcement learning yang mahal. Terdapat ruang optimasi inferensi yang sangat besar pada lapisan arsitektur harness sistem itu sendiri.
Dengan mengonversi Reasoning Idle Window yang sebelumnya pasif menjadi inkubator penalaran asinkron yang produktif, sistem rekayasa perangkat lunak mandiri (seperti Coding CLI, CI/CD remediation bots, dan Customer Support Automation) dapat memangkas biaya komputasi sekuensial hingga 43%, mengurangi putaran buntu, dan menghadirkan agen AI yang jauh lebih responsif, tangguh, dan ekonomis untuk skala produksi industri modern.
Referensi & Sumber Terverifikasi
- [1]Second Thought: Reasoning in Parallel as LLM Agents Act and Observe(arXiv:2608.13667v1 [cs.AI, cs.SE] — Zhensu Sun, Chengran Yang, Yunbo Lyu, Jieke Shi, David Lo (Singapore Management University))
- [2]Official Second Thought Code Repository & Benchmark Reproduction Artifacts(Open Science Research Archive (anonymous.4open.science/r/2nd-thought))
- [3]ReAct: Synergizing Reasoning and Acting in Language Models(International Conference on Learning Representations (ICLR) — Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao)
- [4]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR / arXiv:2310.06770 — Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao, Kexin Pei, Ofir Press, Karthik Narasimhan)
- [5]Terminal-Bench: A Benchmark for AI Agents in Command-Line Environments(arXiv:2603.01188 — Merrill et al. (Stanford & Berkeley AI Research))
- [6]Self-Consistency Improves Chain of Thought Reasoning in Language Models(ICLR / arXiv:2203.11171 — Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi, Sharan Narang, Aakanksha Chowdhery, Denny Zhou)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.