SWE-Duel (arXiv:2610.12569): Towards a Self-Scaling Arena for Coding Agents, Red-Blue Turn Protocol, 3-Session Validation Gates, dan Analisis 1.500 Pertandingan Turnamen Multi-Repositori
Analisis arsitektur sistemik riset Singapore Management University (arXiv:2610.12569, Wei Minn, Zhensu Sun, Lwin Khin Shar, David Lo — ICLR 2027 Submission): Mengapa benchmark koding statis seperti SWE-bench dan SWE-bench Verified mengalami degradasi kredibilitas akibat kebocoran data pelatihan (data leakage) dan saturasi skor oleh frontier LLM? Makalah ini mengusung SWE-Duel, arena evaluasi mandiri berskala dinamis (self-scaling arena) dengan protokol adversarial Red-Blue ganda. Red agent membangun fitur nyata pada repositori GitHub lintas 5 bahasa, menanamkan bug tersembunyi (subtle bug), dan memverifikasi keterpecahan tugas melalui 3 sesi isolasi konteks (Session A: Feature Implementation, Session B: Bug Embedding, Session C: Blind Self-Repair). Blue agent mengevaluasi pull request secara buta di bawah aturan skor konjungsi ketat (hard conjunction). Melalui turnamen 1.500 putaran yang melibatkan 11 peserta model-harness, GPT-5.5 [codex] menduduki puncak peringkat Bradley-Terry (+2.82) sebagai solver terbaik dengan 98.7% Blue win rate, sementara Claude Opus 4.8 [mini-swe-agent] mendominasi sebagai pembuat tugas tersulit dengan 27.3% Red win rate. Riset ini memberikan bukti empiris bahwa kesulitan tugas evaluasi berskala secara proporsional dengan kapabilitas model pembuatnya.
SWE-Duel: Menghapus Kutukan Kebocoran Benchmark Koding Melalui Arena Self-Scaling, Red-Blue Turn Protocol, dan 3-Session Validation Gates
Evaluasi mendalam riset terbaru Wei Minn, Zhensu Sun, Lwin Khin Shar, dan David Lo (Singapore Management University). Mengapa benchmark rekayasa perangkat lunak statis seperti SWE-bench dan SWE-bench Verified kini ditinggalkan oleh frontier lab karena data contamination, dan bagaimana arsitektur evaluation-time task authoring menciptakan arena pengujian tanpa batas yang tingkat kesulitannya berevolusi otomatis mengikuti kecerdasan agent.
1. Krisis Kredibilitas Benchmark Rekayasa Perangkat Lunak Statis
Dalam kurun waktu dua tahun terakhir, SWE-bench telah menjadi standar emas de facto untuk mengukur kapabilitas Large Language Model (LLM) dalam menyelesaikan issue repositori GitHub dunia nyata. Namun, fondasi benchmark statis menghadapi dilema struktural yang tak terhindarkan:
- Data Leakage & Pre-training Contamination: Repositori publik, commit history, pull request, dan test suites yang digunakan sebagai tugas evaluasi secara konstan diserap ke dalam corpus pre-training model generasi terbaru. Sebagai buktinya, OpenAI baru-baru ini secara resmi menghentikan pelaporan evaluasi pada SWE-bench Verified setelah menemukan bahwa frontier models mampu mereproduksi gold patches verbatim melalui memorisasi parametrik.
- Task Set Saturation: Skor penyelesaian SWE-bench melonjak dari di bawah 5% pada awal 2024 menjadi di atas 80% pada akhir 2025. Mengganti tugas lama dengan tugas baru (seperti SWE-bench-Live atau SWE-rebench) hanya menunda masalah (temporal freshness) tanpa meningkatkan kompleksitas hakiki, karena tugas manusia sehari-hari memiliki batas kesulitan alami.
- Kelemahan Model-Generated Benchmark Pendahulu: Proyek seperti BugPilot menghasilkan bug secara tidak sengaja (accidental regressions) dan membekukan tugasnya menjadi dataset statis baru. Sementara itu, SwingArena masih bergantung pada pool issue GitHub manusia yang tetap dan hanya mengotomatisasi pembuatan oracle.
Menjawab kebuntuan ini, riset SWE-Duel (arXiv:2610.12569) memperkenalkan paradigma radikal: Self-Scaling Coding Arena. Dalam SWE-Duel, tidak ada satu pun tugas, spesifikasi, atau oracle pengujian yang dibuat sebelum waktu evaluasi (zero pre-existing content). Kedua agent saling menguji dalam pertarungan adversarial simetris di mana tingkat kesulitan tugas ditentukan langsung oleh model yang bersaing.
2. Arsitektur Protokol Red-Blue: Duel Berpasangan & Role-Swapping
SWE-Duel dirancang sebagai arena pertandingan berpasangan (mirrored Red-Blue turns) antara dua coding agent (Agent A dan Agent B) pada repositori perangkat lunak nyata. Sebuah pertandingan terdiri dari sejumlah turn di mana peran dipertukarkan secara adil:
Bekerja pada repositori target melintasi 3 sesi terisolasi. Bertugas merancang fitur baru, mengimplementasikan kode bersama test suite, lalu menanamkan bug halus (subtle bug) beserta test rahasia pendeteksi bug.
Menerima pull request tanpa diberi tahu apakah bug eksis atau tidak. Memeriksa diff, menjalankan test publik, meninjau logika, dan mengirimkan revisi kode yang bersih.
3. Three-Session Task Creation & 3 Executable Validation Gates
Tantangan terbesar dalam evaluasi adversarial otomatis adalah mencegah agent menghasilkan tugas yang tidak adil (misalnya membuat tugas yang mustahil diperbaiki, menghapus fungsionalitas lama, atau menyertakan bug yang tidak dapat diobservasi). SWE-Duel menyelesaikan ini melalui pemisahan ketat 3 sesi konteks dengan gerbang validasi deterministik (executable gates):
Sesi A: Feature Implementation & Validation Gate A
Feature VerifiabilityRed mengeksplorasi repositori $R$, memilih modul target secara mandiri, mengimplementasikan fitur baru menghasilkan diff $d_f$, serta menyusun spesifikasi $s$ dan feature test suite $T_f$.
Sesi B: Bug Embedding & Validation Gate B
Bug VerifiabilitySesi konteks baru menerima $s$ dan $d_f$. Red memodifikasi fitur untuk menanamkan cacat halus menghasilkan diff akhir $d$, dan menulis test pemicu bug rahasia $T_b$.
Sesi C: Blind Self-Repair & Validation Gate C
Fairness & SolvabilityInstansiasi segar (fresh instance) dari model yang sama menerima hanya bundle publik (repo, spesifikasi $s$, diff $d$, dan test fitur $T_f$) tanpa tahu detail bug atau melihat $T_b$. Model harus mereparasi kode menghasilkan $d'$.
4. Aturan Skoring Konjungsi Ketat (Hard Conjunction Scoring)
Saat giliran Blue memecahkan tugas, Blue menerima bundle publik persis seperti Sesi C. Blue bebas memodifikasi kode atau membiarkan PR apa adanya, lalu mengirimkan revisi $d'$. Framework mengevaluasi hasil dengan formula konjungsi biner tanpa kompromi (zero partial credit):
Blue menang jika dan hanya jika ketiga test suite lulus sekaligus:
- S_b = 0: Bug tersembunyi lolos ke branch utama (The bug ships) → Red Menang.
- S_f = 0: Fitur yang diminta rusak atau dihapus secara sengaja → Red Menang.
- S_e = 0: Kode merusak fungsionalitas lama repositori (Regresi) → Red Menang.
- Jika Blue tidak mengubah apa pun pada PR, Gate B menjamin $T_b$ pasti gagal, sehingga Red otomatis menang.
5. Analisis Hasil Turnamen: 1.500 Pertandingan Lintas 15 Repositori & 5 Bahasa
Para peneliti menguji 11 kombinasi model-harness terkemuka pada 15 repositori produksi dalam 5 bahasa (Java, Go, C/C++, Python, Node.js) selama 1.500 ronde turnamen round-robin. Peringkat akhir dihitung menggunakan Bradley-Terry log-strength model:
| Peserta (Model + Harness) | Matches | Menang | Seri | Kalah | Red Win % | Blue Win % | Bradley-Terry |
|---|---|---|---|---|---|---|---|
| GPT-5.5 [codex] | 10 | 8 | 1 | 1 | 11.3% | 98.7% | +2.82 |
| Claude Opus 4.8 [mini-swe-agent] | 10 | 8 | 0 | 2 | 27.3% | 88.7% | +2.46 |
| GPT-5.5 [mini-swe-agent] | 9 | 5 | 3 | 1 | 10.4% | 97.0% | +2.13 |
| Kimi-K2.7-Code [mini-swe-agent] | 9 | 5 | 2 | 2 | 15.6% | 90.4% | +1.82 |
| DeepSeek-V4-Pro [mini-swe-agent] | 9 | 5 | 1 | 3 | 18.5% | 91.9% | +1.74 |
| GLM-5.2 [mini-swe-agent] | 8 | 4 | 1 | 3 | 12.1% | 89.5% | +1.41 |
Dua Karakter Juara: Ekstrem Solver vs. Ekstrem Task Author
Turnamen SWE-Duel mengungkap fenomena penting mengenai bagaimana model mencapai posisi puncak:
- GPT-5.5 (Master Solver): Merajai turnamen berkat akurasi review Blue yang hampir sempurna (98.7% win rate dengan Codex CLI). Model ini mampu mengendus hampir setiap anomali yang disuntikkan lawan dan memperbaikinya tanpa merusak dependensi repositori. Namun, kapabilitas Red agent-nya relatif konvensional (Red win rate hanya 11.3%).
- Claude Opus 4.8 (Master Adversary): Menjadi peserta paling berbahaya dalam peran pencipta tugas. Tingkat kemenangan Red Claude Opus 4.8 mencapai 27.3%—lebih dari 2.4 kali lipat GPT-5.5. Bug yang ditanam Opus 4.8 memiliki kedalaman logika semantik tingkat tinggi yang konsisten menipu model lawan tanpa memicu kecurigaan.
- Kegagalan Model Tier Bawah: Model seperti MiniMax-M3 (Red 2.0%) dan Gemini 3.1 Pro (Red 2.7%) sering kali gagal meloloskan tugas melalui 3 Gerbang Validasi (Sesi A/B/C). Ketika sebuah slot tugas gagal dibuat dalam 5 percobaan, slot tersebut dinyatakan exhausted, memberikan kemenangan gratis (auto-win) secara otomatis kepada pihak lawan.
6. Bukti Empiris Fenomena Self-Scaling: Tingkat Kesulitan Naik Seiring Kecerdasan Model
Pertanyaan ilmiah inti yang dijawab oleh SWE-Duel adalah: Apakah kesulitan tugas benar-benar meningkat ketika model pembuat tugas semakin pintar?
Eksperimen kontrol dalam satu rumpun model (model family) memverifikasi hipotesis ini secara meyakinkan. Ketika sebuah solver referensi tetap (fixed-reference solver) diuji melawan kumpulan tugas yang dibuat oleh model versi lama dibandingkan versi terbaru:
*Solver referensi identik ditaklukkan 10 kali lebih sering oleh pull request yang dirancang oleh agen versi terbaru. Hal ini membuktikan bahwa benchmark SWE-Duel tidak akan pernah usang atau jenuh (saturation-proof).
Taksonomi Cacat: Kategori Bug Paling Mematikan bagi Coding Agents
Dari 1.219 turn yang diperebutkan (contested turns), penelitian menganalisis jenis bug yang paling sulit diidentifikasi oleh Blue reviewer:
- Logic Errors (81.9% Blue Success): Cacat logika bisnis adalah kategori paling sulit diperbaiki karena tidak menghasilkan runtime exception dan sintaksis terlihat sempurna.
- Security Vulnerabilities (84.9% Blue Success): Cacat otorisasi, path traversal halus, dan race condition.
- Off-by-One Errors (88.9% Blue Success): Kesalahan indeks loop batas atas/bawah.
- Type Confusion (90.6% Blue Success): Konversi tipe data implisit (khususnya pada Python dan Node.js).
- Input Validation (95.5% Blue Success): Cacat paling mudah dideteksi dan diperbaiki oleh model modern.
7. Implementasi Produksi: Engine Orkestrasi SWE-Duel TypeScript
Berikut adalah implementasi referensi modul SWE-Duel Arena Engine berbasis TypeScript yang mengelola isolasi 3 sesi konteks, validasi gerbang deterministik, dan kalkulasi rating turnamen Bradley-Terry:
${SWEDUEL_CODE_SNIPPET}8. Implikasi bagi Industri AI & Evaluasi Agent Produksi 2026/2027
Transisi dari evaluasi statis menuju arsitektur self-scaling seperti SWE-Duel membawa implikasi strategis bagi tim rekayasa AI enterprise:
- Tinggalkan Metrik SWE-bench Statis untuk Evaluasi Akhir: Model yang dilatih khusus (overfitted) pada issue GitHub masa lalu tidak mencerminkan keandalan engineering di repositori internal perusahaan yang dinamis. Evaluasi wajib mengikutsertakan fase PR review buta.
- Wajibkan Gate Blind Self-Repair: Setiap kali memanfaatkan AI agent untuk membuat synthetic dataset atau adversarial challenges, terapkan Session C. Menguji apakah pembuat tugas mampu memecahkannya secara buta adalah saringan terbaik terhadap kontaminasi artefak halusinasi.
- Ukur Dua Dimensi Terpisah: Task Authoring vs Code Repair: Skor tunggal mengaburkan kekuatan model. Model dengan skor review tinggi belum tentu mampu merancang arsitektur baru yang andal, dan sebaliknya. Pisahkan metrik Red win rate dan Blue win rate.
- Hard Conjunction Sebagai Standar CI/CD AI PR Review: Jangan pernah menerima pull request otomatis dari AI agent jika hanya lulus test fungsional parsial. Pastikan regresi, fitur baru, dan sanitasi keamanan lulus secara serentak ($S_{Blue} = S_e cdot S_f cdot S_b$).
Referensi & Sumber Terverifikasi
- [1]SWE-Duel: Towards a Self-Scaling Arena for Coding Agents(arXiv:2610.12569 [cs.CL, cs.SE] / Under review as a conference paper at ICLR 2027 — Wei Minn, Zhensu Sun, Lwin Khin Shar, David Lo (Singapore Management University))
- [2]SWE-bench: Can Language Models Resolve Real-World GitHub Issues?(ICLR 2024 / Princeton NLP — Carlos E. Jimenez, John Yang, Alexander Wettig, Shunyu Yao et al.)
- [3]BugPilot: Generating Diverse Buggy Environments from Agent Accidental Regressions(arXiv / Conference on Empirical Software Engineering 2025 — Sonwane et al.)
- [4]Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference in the Wild(ICML 2024 / LMSYS Org — Wei-Lin Chiang, Lianmin Zheng et al.)
- [5]Self-play SWE-RL: Training Software Engineering Agents via Competitive Exploration(NeurIPS 2025 / Stanford & DeepMind — Wei et al.)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya
Bellman Language Models (arXiv:2610.24871): Discretize-Then-Decide, Eliminasi Redundant LLM Invocations hingga 98%, dan Optimal Control pada Agentic Workflows
Analisis arsitektur sistemik riset frontier arXiv:2610.24871 (Adarsh Vatsa & William Eiers): Mengapa workflow agen otonom terus-menerus memboroskan komputasi untuk mendeduksi ulang keputusan yang berulang pada setiap turn? Memperkenalkan Bellman Language Models (BLM) dan paradigma "Discretize, Then Decide" yang memodelkan interaksi agen sebagai Markov Decision Process (MDP) diskret dan menyelesaikannya via persamaan optimalitas Bellman. Pada benchmark tau^2-bench telecom, controller mandiri tanpa model LLM mampu menyelesaikan 79% tugas; dipasangkan dengan Qwen3.8-27B, akurasi melonjak dari 29% menjadi 96% dengan pemangkasan 93% panggilan model; serta memangkas 98% biaya Claude Opus 5.5. Artikel ini membedah teori saturasi ruang keputusan, formulasi Bellman controller, batasan pada open synthesis, dan implementasi TypeScript produksi.
Acceptance Is Not Speed (arXiv:2610.23818): Ilusi Akselerasi Lossy Speculative Decoding, Mengapa Relaxed Sampling Memperpanjang Reasoning Trace 1.54x, dan Solusi Length-Corrected Verification
Investigasi empiris komprehensif arXiv:2610.23818 (Chiatzen Wang, Bill Xu, Haochen Gu, Hongyang Zhang — University of Waterloo): Mengapa peningkatan rasio penerimaan token (accepted length) pada lossy speculative decoding gagal menghasilkan akselerasi wall-clock? Evaluasi 360 konfigurasi lintas 12 pasangan target-drafter (GPT-OSS-20B, Qwen3-8B, Llama-3.1-8B dengan EAGLE-3, DSpark, dan standalone drafter) membuktikan fenomena sistemik "Length Inflation": relaksasi verifikasi menerima token probabilitas rendah yang mendeformasi lintasan penalaran, menyebabkan model berpikir 1.54x lebih panjang (bahkan 3.3x pada EAGLE-3). Lebih dari 90% token ekstra terbuang di dalam reasoning trace (<think>), memicu kehabisan token budget pada AIME24 dan evaluasi redundan pada GSM8K. Artikel ini membedah taksonomi 5 metode lossy (CACTUS, Mentored Decoding, rFSD, Speculative Cascades), batas matematis net-win, serta implementasi TypeScript Length-Corrected Speculative Harness.
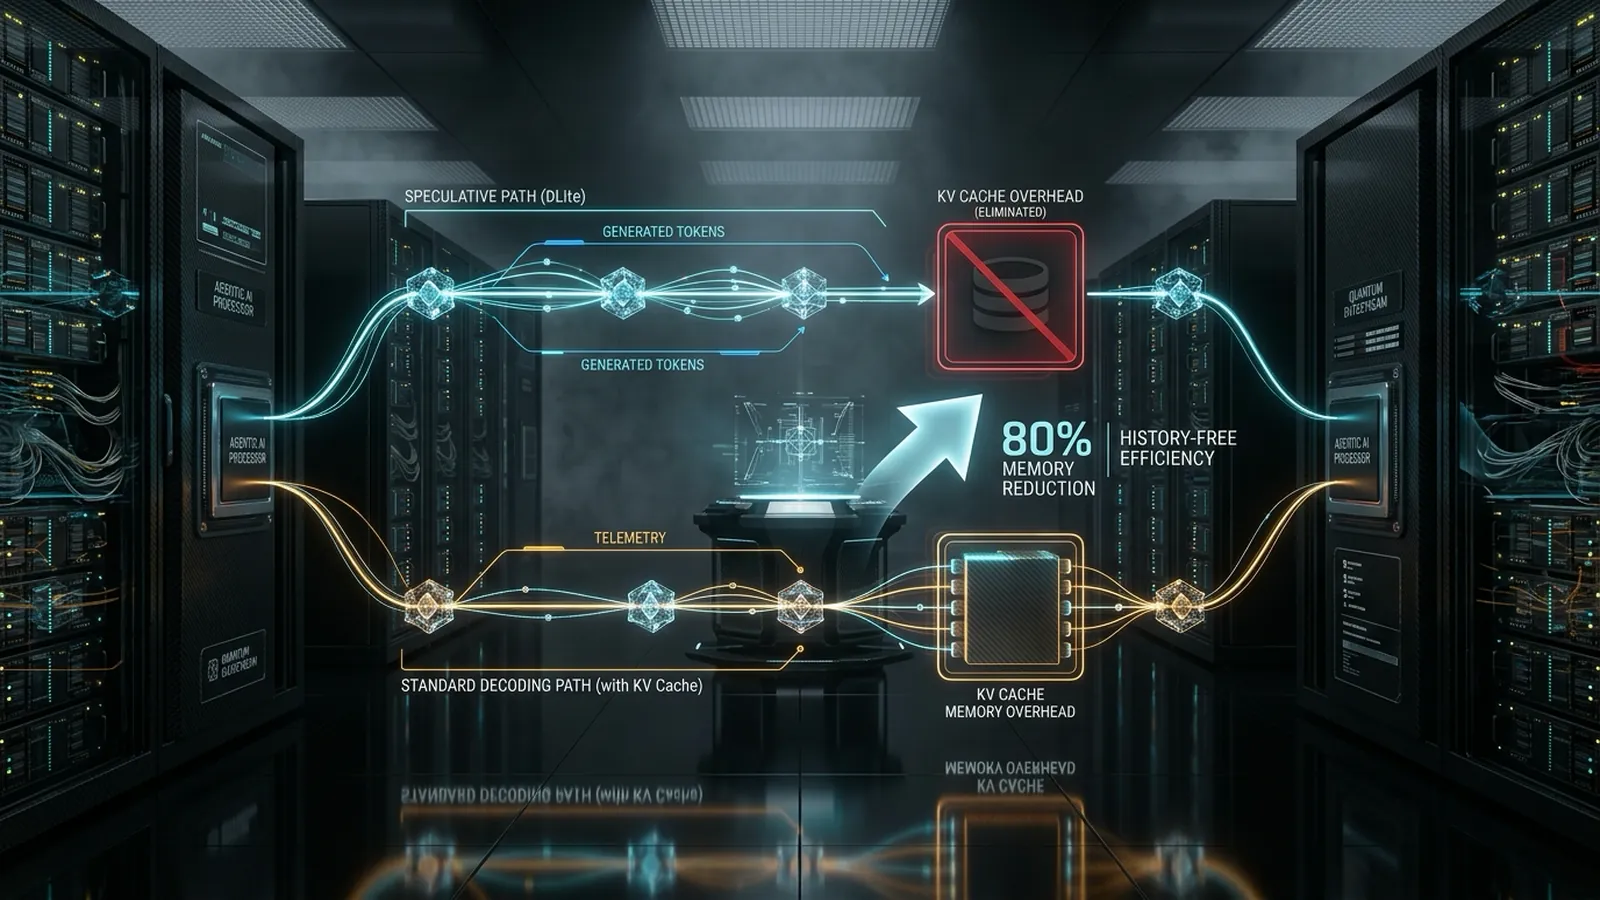
DLite (arXiv:2610.23787): History-Free Speculative Decoding untuk Agentic AI, Eliminasi Draft KV Cache, dan Akselerasi 2.74x pada SWE-bench
Bedah arsitektur dan evaluasi empiris riset frontier arXiv:2610.23787 (Jiaming Xu, Guohao Dai et al. — SJTU, Tsinghua, Shanghai Innovation Institute): Mengapa metode speculative decoding konvensional seperti EAGLE-3, DFlash, dan DSpark mengalami degradasi acceptance length hingga 80% pada beban kerja agen otonom? DLite memperkenalkan paradigma History-Free Speculative Decoding yang sepenuhnya mengeliminasi draft KV cache, menggunakan parallel backbone berbasis reuse hidden state target model dengan learnable depth embeddings, lightweight low-rank RNN sequential head di ruang representasi tersembunyi, serta two-stage distillation training (isomorphic teacher warm-up dan total variation alignment). Evaluasi pada Qwen3-4B dan Qwen3-8B via SGLang membuktikan lonjakan acceptance length hingga 3.19 token dan akselerasi end-to-end 2.74x pada SWE-bench tanpa kehilangan kualitas generasi.