Thinking Before Thinking 2026: Arsitektur Agentic Meta-Reasoning, Siklus 4-Tahap Assess-Propose-Evaluate-Dispatch, dan Penskalaan Test-Time Inference Agen Mandiri
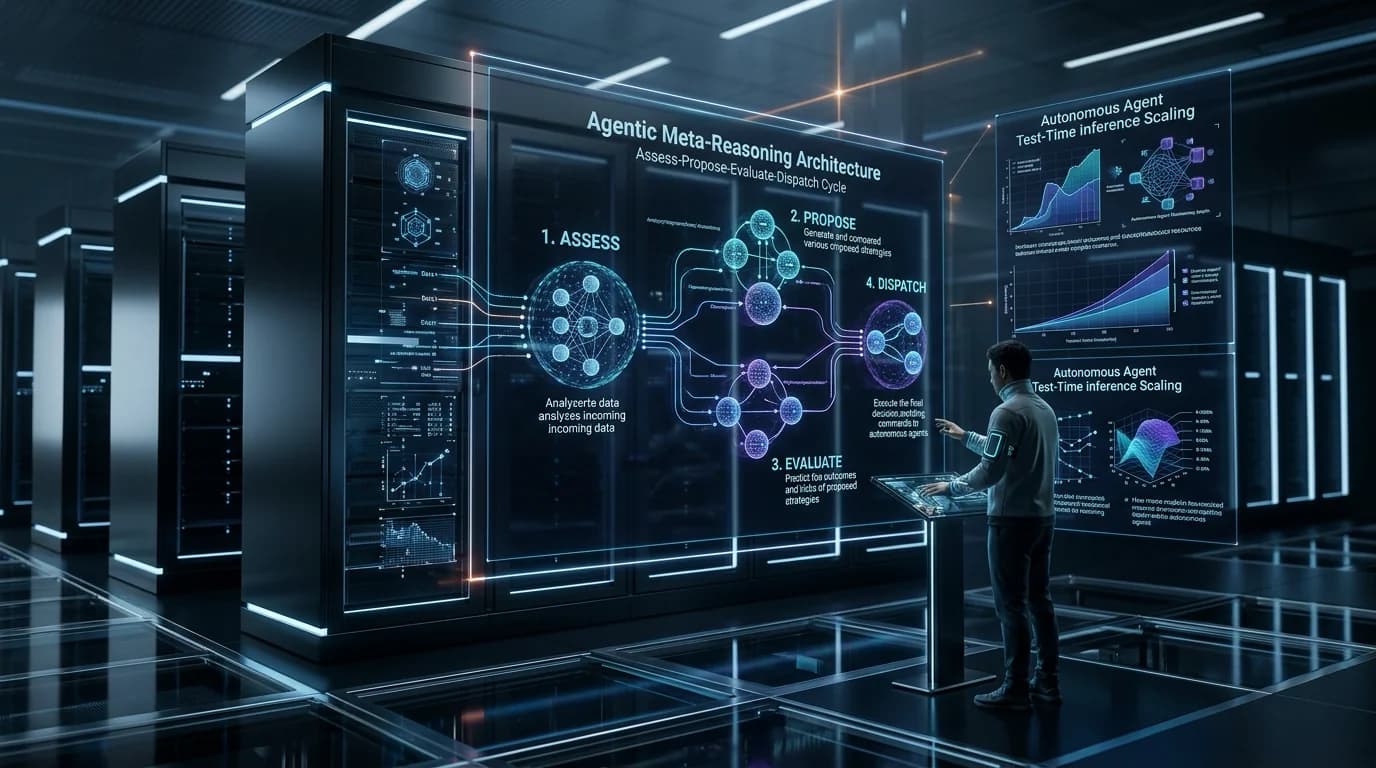
Analisis arsitektur sistemik riset frontier AI reasoning & autonomous harnesses (arXiv:2609.38147, Meta Superintelligence Labs, 29 September 2026): Mengapa mereplay seluruh riwayat interaksi ke dalam context window justru melumpuhkan penalaran long-horizon agen cerdas. Makalah ini membongkar disparitas antara object-level task computation dan inferential meta-reasoning control. Peneliti memperkenalkan arsitektur Agentic Meta-Reasoning yang memisahkan eksekusi worker dari pengendali bernalar, digerakkan oleh siklus kontrol 4-tahap formal: Assess (konsolidasi memori & sintesis state s_t), Propose (generasi opsi tindakan tanpa kekangan anggaran), Evaluate (penilaian nilai komputasi kualitatif terhadap sisa anggaran), dan Dispatch (injeksi konteks terkurasi dari Directed Acyclic Artifact Graph G=(V,E)). Pada benchmark rekonstruksi software engineering ProgramBench, Meta-Reasoning mendongkrak performa GPT-5.5 hingga 71.5% (mengungguli Codex di 58.0%) dan Opus 4.8 hingga 67.2% (mengungguli Claude Code di 65.5%), serta membuktikan bahwa penskalaan inferensi waktu-uji paling efektif dicapai melalui kontrol terstruktur, bukan sekadar penambahan token sampling mentah.
Salah satu mitos paling gigih dalam rekayasa sistem agen kecerdasan buatan (autonomous AI agents) adalah asumsi bahwa memperbesar context window dan menjejali seluruh riwayat eksekusi (full conversation replay) ke dalam prompt adalah jalan utama meningkatkan keberhasilan tugas jangka panjang. Di dunia nyata, pendekatan naif ini justru memicu degradasi performa: semakin panjang histori tool calls, model semakin rentan terhadap attention dilution, terperangkap dalam perulangan halusinasi (action looping), dan gagal membedakan temuan valid dari kegagalan masa lalu.
Pada 29 September 2026, tim peneliti frontier dari Meta Superintelligence Labs (arXiv:2609.38147, Paras Dahal, Anton Bakhtin, Taco Cohen, Carole-Jean Wu, Gabriel Synnaeve, Sanjeev Arora, Jason Weston, Anirudh Goyal et al.) mempublikasikan riset fundamental berjudul "Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning". Makalah ini memperkenalkan pemisahan arsitektur yang sangat tegas: membagi kognisi agen menjadi dua ranah independen—yaitu komputasi tugas objek (worker execution) dan penalaran pengendali tingkat tinggi (agentic meta-reasoning).
Penskalaan Inferensi Waktu-Uji Melalui Kontrol Metakognitif Terstruktur
Riset ini membuktikan bahwa penskalaan inferensi waktu-uji (test-time compute scaling) pada agen koding dan penalaran matematika tidak lagi optimal jika hanya mengandalkan sampling acak atau ReAct loop sekuensial. Melalui arsitektur Meta-Reasoning Agent:
- Keunggulan Dominan atas Agen Produksi: Pada benchmark rekonstruksi kode berskala masif ProgramBench, Meta-Reasoning Agent memecahkan rekor dengan akurasi 71.5% menggunakan GPT-5.5 (melibas OpenAI Codex yang tertahan di 58.0%), serta 67.2% menggunakan Opus 4.8 (mengungguli Claude Code di 65.5%).
- Konsistensi Kemenangan 12 dari 12 Evaluasi: Di seluruh 4 benchmark frontier (IMO ProofBench-Advanced, ARC-AGI-2, LongCoT-mini, dan ProgramBench) melintasi tiga keluarga frontier model (Gemini 3.1 Pro, GPT-5.5, dan Opus 4.8), arsitektur Meta-Reasoning secara mutlak mengungguli baseline Direct Control dengan lonjakan skor hingga +8.6 poin pada pembuktian matematika IMO.
- Eliminasi Replay Riwayat Penuh: Pengendali (Controller) tidak pernah membaca transcript mentah siklus sebelumnya. Pengendali hanya mengelola compact state representation \(s_t\) yang ditulis ulang di setiap siklus, sementara bukti dan artefak kode tersimpan dalam memori berbasis Directed Acyclic Graph (DAG).
1. Anatomi Siklus Kontrol 4-Tahap: Assess, Propose, Evaluate, dan Dispatch
Dalam agen ReAct konvensional, keputusan "apa yang harus dikerjakan berikutnya" tercampur aduk dalam token keluaran yang sama dengan isi kode atau perintah shell. Sebaliknya, Meta-Reasoning memformalkan setiap siklus kontrol \(t\) ke dalam empat tahapan agen sekuensial yang masing-masing memiliki prompt terisolasi, batasan memori, dan toolsets mandiri:
Apa yang Telah Kita Pelajari?
Saat artefak baru \(\Delta M_t\) kembali dari batch worker sebelumnya, fungsi penilaian menghasilkan state baru:
s_t = Assess(x, s_{t-1}, ΔM_t; M_t)
Tahap ini mengidentifikasi kebenaran parsial, kontradiksi, atau bug yang terbukti, lalu merangkumnya ke dalam teks ringkas \(s_t\). Titik koma menandakan bahwa controller memiliki akses pembacaan terarah ke memori persisten \(M_t\), alih-alih membanjiri seluruh memori ke dalam prompt.
Apa Saja Opsi Kerja Berikutnya?
Menghasilkan sekumpulan proposal komputasi alternatif \(\mathcal{A}_t\) berdasarkan state \(s_t\):
A_t = Propose(x, s_t; M_t)
Kunci Desain: Tahap Propose sengaja tidak diberitahu berapa sisa kuota model calls. Ini memisahkan imajinasi eksplorasi dari kalkulasi biaya, sehingga opsi berbobot tinggi namun mahal tidak disensor secara prematur.
Opsi Mana yang Layak Dibiayai?
Menilai kandidat \(\mathcal{A}_t\) terhadap sisa anggaran komputasi \(b_t^{\text{eval}}\). Jika pembuktian tergantung pada satu lemma yang goyah, controller memprioritaskan worker verifikasi lemma tersebut daripada menulis ulang kode dari nol. Jika verifikasi gagal, siklus berikutnya secara sadar beralih ke cabang pendekatan lain.
Eksekusi Terkurasi ke Worker
Mengubah proposal terpilih menjadi aksi nyata: memanggil batch worker paralel dengan instruksi terarah \(g_i\) dan irisan konteks artefak terkurasi \(C_i \subseteq M_t\). Worker tidak pernah menerima catatan internal atau pertimbangan privat controller—hanya instruksi presisi dan artefak dependensinya.
2. Directed Acyclic Artifact Graph \(G = (V, E)\): Menghindari Amnesia Konteks
Dalam arsitektur Meta-Reasoning, memori bukanlah tumpukan log percakapan teks linier, melainkan Directed Acyclic Graph (DAG) artefak \(G = (V, E)\). Setiap kali worker menghasilkan output \(y_j\), simpul baru \(y_j \in V\) didaftarkan dengan ID permanen. Sisi berarah \(E\) dibentuk dari hubungan kontekstual yang ditentukan oleh tahap Dispatch:
Jika Worker A menghasilkan skrip pengujian (Artefak #1), dan Worker B ditugaskan merefaktor kode berdasarkan Artefak #1 tersebut, maka sisi berarah dibentuk dari #1 ke output Worker B. Hal ini memungkinkan sistem melacak silsilah komputasi secara sempurna: simpul akar (roots) mewakili eksplorasi segar tanpa konteks awal, percabangan (branches) merepresentasikan investigasi paralel, dan simpul konvergen (joins) mewakili sintesis multi-worker.
Temuan empiris spektakuler dari Meta Superintelligence Labs menunjukkan bahwa pola operasi memori terkonsentrasi secara asimetris: tahap Assess mendominasi penulisan memori persisten (epistemic memory writes) hampir tanpa melakukan pembacaan ulang, sementara tahap Propose dan Evaluate bertanggung jawab atas hampir seluruh pembacaan terkurasi (selective memory reads).
3. Tolok Ukur Kinerja Empiris: Meta-Reasoning vs Agen Produksi Modern
Evaluasi empiris dilakukan secara ketat dengan mencocokkan total kuota model calls (100 calls untuk penalaran matematika/abstrak, dan 1.200 calls untuk rekayasa perangkat lunak ProgramBench). Tabel berikut merangkum hasil uji coba pada paper resmi Meta Superintelligence Labs:
| Base Foundation Model | Sistem / Harness | IMO ProofBench-Adv | ARC-AGI-2 | LongCoT-mini | ProgramBench (SWE) |
|---|---|---|---|---|---|
| Gemini 3.1 Pro | Recursive Language Model (RLM) | 73.3% | 76.7% | 46.5% | — |
| Direct Control Agent (Baseline) | 82.7% | 77.5% | 53.5% | 46.9% | |
| Meta-Reasoning Agent (Ours) | 91.3% (+8.6) | 84.2% (+6.7) | 62.7% (+9.2) | 48.7% (+1.8) | |
| GPT-5.5 | OpenAI Codex (Production CLI) | — | — | — | 58.0% |
| mini-SWE Agent | — | — | — | 57.6% | |
| Direct Control Agent (Baseline) | 93.3% | 75.8% | 64.7% | 63.7% | |
| Meta-Reasoning Agent (Ours) | 94.6% (+1.3) | 79.2% (+3.4) | 65.1% (+0.4) | 71.5% (+13.5 vs Codex) | |
| Opus 4.8 | Claude Code (Production CLI) | — | — | — | 65.5% |
| Direct Control Agent (Baseline) | 78.0% | 77.5% | 65.3% | 65.3% | |
| Meta-Reasoning Agent (Ours) | 80.2% (+2.2) | 80.0% (+2.5) | 66.5% (+1.2) | 67.2% (+1.7 vs Claude Code) |
Poin krusial yang terungkap dari analisis grafik artefak adalah: Baseline Direct Control mengalami plateauing (kejenuhan) saat anggaran komputasi dinaikkan. Ketika Direct Control diberikan 1.200 calls, penambahan token sampling tidak lagi menghasilkan solusi baru karena model tersesat dalam konteks historis yang membengkak. Sebaliknya, Meta-Reasoning terus menunjukkan kurva peningkatan logaritmik tanpa saturasi, karena controller secara sadar memanfaatkan sisa anggaran untuk melakukan pruning pada cabang yang gagal dan memperdalam validasi pada solusi parsial yang paling menjanjikan.
4. Implementasi Referensi: TypeScript Meta-Reasoning Controller Engine
Berikut adalah arsitektur TypeScript referensi yang mengadopsi formulasi matematis dan siklus 4-tahap dari paper resmi Meta Superintelligence Labs:
// Production Implementation: Agentic Meta-Reasoning Orchestration Engine
// Berdasarkan Arsitektur Meta Superintelligence Labs (arXiv:2609.38147 - September 2026)
//
// Pilar Sistem:
// 1. ArtifactGraph (G = (V, E)): Melacak dependensi output worker dan relasi konteks
// 2. MetaController: Menjalankan siklus 4-tahap (Assess -> Propose -> Evaluate -> Dispatch)
// 3. EpistemicMemoryStore: Menghindari replay raw history; menyimpan state s_t yang kompak

export interface Artifact {
  id: string;
  source: 'CONTROLLER' | 'WORKER';
  type: 'ATTEMPT' | 'CRITIQUE' | 'NOTE' | 'VERDICT';
  payload: string;
  contextIds: string[]; // Edge masukan C_j ⊆ M_t
  createdAt: number;
}

export interface WorkerDispatchInstruction {
  instruction: string;
  contextArtifacts: Artifact[];
}

export interface ControlEvaluationCandidate {
  proposalId: string;
  actionType: 'SPAWN_WORKERS' | 'REVISE_STATE' | 'STOP_AND_SUBMIT';
  instructions: string[];
  selectedContextArtifactIds: string[];
  estimatedComputationalValue: number; // 0.0 - 1.0
  rationale: string;
}

export class ArtifactGraph {
  private nodes: Map = new Map();
  private edges: Array<{ from: string; to: string }> = [];

  public registerArtifact(artifact: Artifact): void {
    this.nodes.set(artifact.id, artifact);
    for (const ctxId of artifact.contextIds) {
      if (this.nodes.has(ctxId)) {
        this.edges.push({ from: ctxId, to: artifact.id });
      }
    }
  }

  public getArtifact(id: string): Artifact | undefined {
    return this.nodes.get(id);
  }

  public getContextSlice(contextIds: string[]): Artifact[] {
    return contextIds
      .map(id => this.nodes.get(id))
      .filter((a): a is Artifact => a !== undefined);
  }

  public getGraphSummary(): { nodeCount: number; edgeCount: number } {
    return { nodeCount: this.nodes.size, edgeCount: this.edges.length };
  }
}

export class MetaReasoningController {
  private artifactGraph = new ArtifactGraph();
  private currentStateText = ''; // s_t: ringkasan terkompresi dari apa yang telah dicapai
  private remainingCallsBudget: number;

  constructor(
    private taskId: string,
    private initialTaskPrompt: string,
    totalBudget: number
  ) {
    this.remainingCallsBudget = totalBudget;
    this.currentStateText = `Initial Task Ingestion: ${initialTaskPrompt.slice(0, 100)}...`;
  }

  /**
   * Tahap 1: Assess - s_t = Assess(x, s_{t-1}, ΔM_t; M_t)
   * Mengonsolidasi output worker terbaru tanpa memasukkan seluruh history mentah ke prompt.
   */
  public async assessCycle(newArtifacts: Artifact[]): Promise {
    for (const art of newArtifacts) {
      this.artifactGraph.registerArtifact(art);
    }

    // Epistemic state compression: memperbarui state s_t secara terfokus
    const summaryDelta = newArtifacts
      .map(a => `[${a.type} #${a.id}]: ${a.payload.slice(0, 80)}`)
      .join(' | ');

    this.currentStateText = `State@${Date.now()}: Has ${newArtifacts.length} new artifacts. Summary: ${summaryDelta}`;
    this.remainingCallsBudget -= 1;
    return this.currentStateText;
  }

  /**
   * Tahap 2: Propose - A_t = Propose(x, s_t; M_t)
   * Membangun daftar hipotesis & aksi komputasi alternatif TANPA membatasi anggaran
   * agar opsi eksplorasi bernilai tinggi tidak gugur prematur.
   */
  public async proposeCycle(): Promise {
    this.remainingCallsBudget -= 1;
    return [
      {
        proposalId: 'prop-decompose-sublemma',
        actionType: 'SPAWN_WORKERS',
        instructions: ['Verifikasi Lemma 2.1 via SMT Solver', 'Buktikan kasus batas n=0'],
        selectedContextArtifactIds: [],
        estimatedComputationalValue: 0.88,
        rationale: 'Fokus pada titik terlemah dalam trajectory penalaran saat ini.'
      },
      {
        proposalId: 'prop-direct-synthesis',
        actionType: 'STOP_AND_SUBMIT',
        instructions: ['Compile and submit current solution'],
        selectedContextArtifactIds: [],
        estimatedComputationalValue: 0.42,
        rationale: 'Solusi parsial sudah mencukupi jika anggaran tersisa sangat sempit.'
      }
    ];
  }

  /**
   * Tahap 3: Evaluate - Menimbang proposal terhadap sisa kuota model calls (b_t^eval).
   */
  public evaluateProposals(
    proposals: ControlEvaluationCandidate[]
  ): ControlEvaluationCandidate {
    // Alokasi adaptif: jika sisa anggaran tinggi, prioritaskan pendalaman verifikasi
    if (this.remainingCallsBudget > 10) {
      return proposals.find(p => p.actionType === 'SPAWN_WORKERS') || proposals[0];
    }
    return proposals.find(p => p.actionType === 'STOP_AND_SUBMIT') || proposals[0];
  }

  /**
   * Tahap 4: Dispatch - Menyiapkan payload kerja worker C_j ⊆ M_t dan instruksi g_i.
   */
  public dispatchAction(selected: ControlEvaluationCandidate): {
    action: 'DISPATCH_WORKERS' | 'HALT_EXECUTION';
    dispatches?: WorkerDispatchInstruction[];
  } {
    if (selected.actionType === 'STOP_AND_SUBMIT') {
      return { action: 'HALT_EXECUTION' };
    }

    const dispatches: WorkerDispatchInstruction[] = selected.instructions.map(inst => ({
      instruction: inst,
      contextArtifacts: this.artifactGraph.getContextSlice(selected.selectedContextArtifactIds)
    }));

    return { action: 'DISPATCH_WORKERS', dispatches };
  }
}
5. Panduan Praktis bagi Tim Pengembang AI Harness & Autonomous Agents
Bagi organisasi rekayasa perangkat lunak yang sedang membangun autonomous coding agents atau multi-agent orchestration:
- Hentikan Full History Replay pada Agent Prompts: Jangan pernah mengirimkan log terminal mentah dari 50 langkah sebelumnya ke dalam setiap giliran model. Gunakan model terpisah atau prompt khusus untuk mengonsolidasi state \(s_t\) secara episodik.
- Pisahkan Tahap Eksplorasi dari Batasan Anggaran (Budget Blind Propose): Saat memikirkan alternatif solusi teknis (Propose stage), jangan biarkan model dibatasi oleh rasa takut kehabisan kuota token. Biarkan semua kemungkinan hipotesis muncul, lalu saring secara rasional di tahap Evaluate stage.
- Gunakan Directed Acyclic Artifact Graph untuk Context Slicing: Kirimkan hanya artefak yang relevan (\(C_i \subseteq M_t\)) ke sub-worker. Worker yang bertugas menulis unit test hanya membutuhkan spesifikasi antarmuka dan mock requirements, bukan riwayat percakapan mengenai bug lain di modul terpisah.
- Waspadai Overhead pada Anggaran Kecil: Pada tugas sepele dengan kuota < 20 calls, mekanisme meta-reasoning memakan biaya deliberasi yang dapat menurunkan efisiensi. Aktifkan Meta-Reasoning secara dinamis hanya untuk masalah yang membutuhkan horizon eksekusi panjang atau memiliki ambiguitas arsitektural tinggi.
Referensi & Sumber Terverifikasi
- [1]Thinking Before Thinking: Scaling Agentic Inference Through Meta-Reasoning(arXiv:2609.38147 [cs.AI] — Paras Dahal, Anton Bakhtin, Taco Cohen, Zhengxing Chen, Carole-Jean Wu, Rob Fergus, Scott Yih, Gabriel Synnaeve, Ruslan Salakhutdinov, Sanjeev Arora, Jason Weston, Anirudh Goyal (Meta Superintelligence Labs))
- [2]LongHarness Bench: Stress-Testing Language Model Harnesses for Long-Context Reasoning(arXiv:2609.38137 [cs.AI] — Quang Hieu Pham, Thuy Duong Nguyen, Jocelyn Qiaochu Chen, Xi Ye)
- [3]Learning Meta-Skills for Agent Harness Design in Test-Time AI4AI(arXiv:2609.38143 [cs.AI] — Cheng Qian, Kunlun Zhu, Beibin Li, Zhenhailong Wang, Heng Ji)
- [4]ProgramBench: Benchmarking Program Reconstruction and Long-Horizon Software Engineering for Agents(Frontier AI Research & Systems Evaluation Benchmark Suite)
- [5]Epistemic Actions and Context Selection in Distributed Problem Solving(Cognitive Science Journal & ACM Digital Library (Kirsh & Maglio Formulation))
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.