VISTA 2026: Arsitektur Visual Harness Kaiming He, Lossless Visual Memory, dan Terobosan Multimodal Reasoning Tanpa Program Synthesis pada ARC-AGI-3
Analisis arsitektur sistemik riset frontier penalaran multimodal MIT CSAIL (arXiv:2610.02200, Kaiming He, Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Oktober 2026): Mengapa dogma program synthesis (DSL berbasis Python) pada ARC-AGI dan representasi grid teks 4.000 token selama ini membatasi kapasitas penalaran visual model fondasi. Memperkenalkan VISTA (Visual Harness for Interactive Worlds), harness mekanis murni tanpa pelatihan model tambahan yang membekali Claude Opus 5.0 dan GPT-5.6 Sol dengan long-horizon vision. Mengintegrasikan visual observations langsung (~308 token gambar), lossless visual memory yang mengarsipkan seluruh frame termasuk transisi animasi, model-directed visual inspection (spatial crop & temporal replay), serta sistem dual-notes (GUIDE.md & WORKING.md). VISTA mencetak skor Relative Human Action Efficiency (RHAE) sempurna 100.00 pada seluruh 25 game publik ARC-AGI-3 tanpa satu baris pun sintesis program, menyelesaikan game dengan 57.4% aksi lebih sedikit daripada pemain manusia pemula, serta melampaui human baseline pada GameWorld, AI GameStore, dan BabyVision.
VISTA: Mengapa Rekayasa Visual Harness Mampu Memecahkan ARC-AGI-3 Secara Sempurna Tanpa Program Synthesis
Sejak François Chollet memperkenalkan Abstraction and Reasoning Corpus (ARC) sebagai tolok ukur utama kecerdasan buatan umum (AGI), komunitas riset global terbelenggu dalam satu dogma mutlak: masalah penalaran abstrak interaktif hanya bisa dipecahkan melalui sintesis program (program synthesis / DSL kode Python) dengan representasi grid teks. Namun riset frontier terbaru dari MIT CSAIL yang dipimpin oleh Kaiming He meruntuhkan dogma tersebut secara radikal. Framework VISTA (Visual Harness for Interactive Worlds) membuktikan bahwa model fondasi multimodal general-purpose (Claude Opus 5.0 dan GPT-5.6 Sol) telah memiliki kapabilitas penalaran yang luar biasa kuat—asalkan dipasangkan dengan visual harness mekanis yang menyediakan long-horizon vision, lossless visual memory, dan model-directed spatial/temporal inspection. VISTA mencetak skor efisiensi aksi RHAE 100.00 sempurna pada seluruh 25 game publik ARC-AGI-3 dengan 57.4% aksi lebih sedikit daripada manusia.
1. Paradoks Program Synthesis: Mengapa Representasi Grid Teks Menghancurkan Penalaran Visual LLM
Dalam tolok ukur ARC-AGI-3, agen AI dihadapkan pada dunia permainan visual interaktif tanpa aturan tertulis. Agen harus mengamati keadaan visual, mengeksekusi aksi, menginferensi aturan transformasi, mengidentifikasi objek tersembunyi, dan menemukan tujuan level. Mayoritas sistem SOTA terdahulu (seperti Schema, Tycho, ewma_sv, dan Retrodict) bertumpu pada program synthesis: LLM diminta menulis program Python atau Domain-Specific Language (DSL) untuk merekayasa simulator lingkungan, memprediksi grid masa depan, dan merumuskan rencana aksi secara simbolik.
Untuk mendukung sintesis program, sistem-sistem tersebut meratakan (flatten) frame grafis menjadi grid teks matriks dua dimensi yang berisi indeks integer warna (misal [[0, 1, 2], [3, 0, 1]]). Tim MIT CSAIL membuktikan bahwa pendekatan ini memiliki tiga kecacatan fatal:
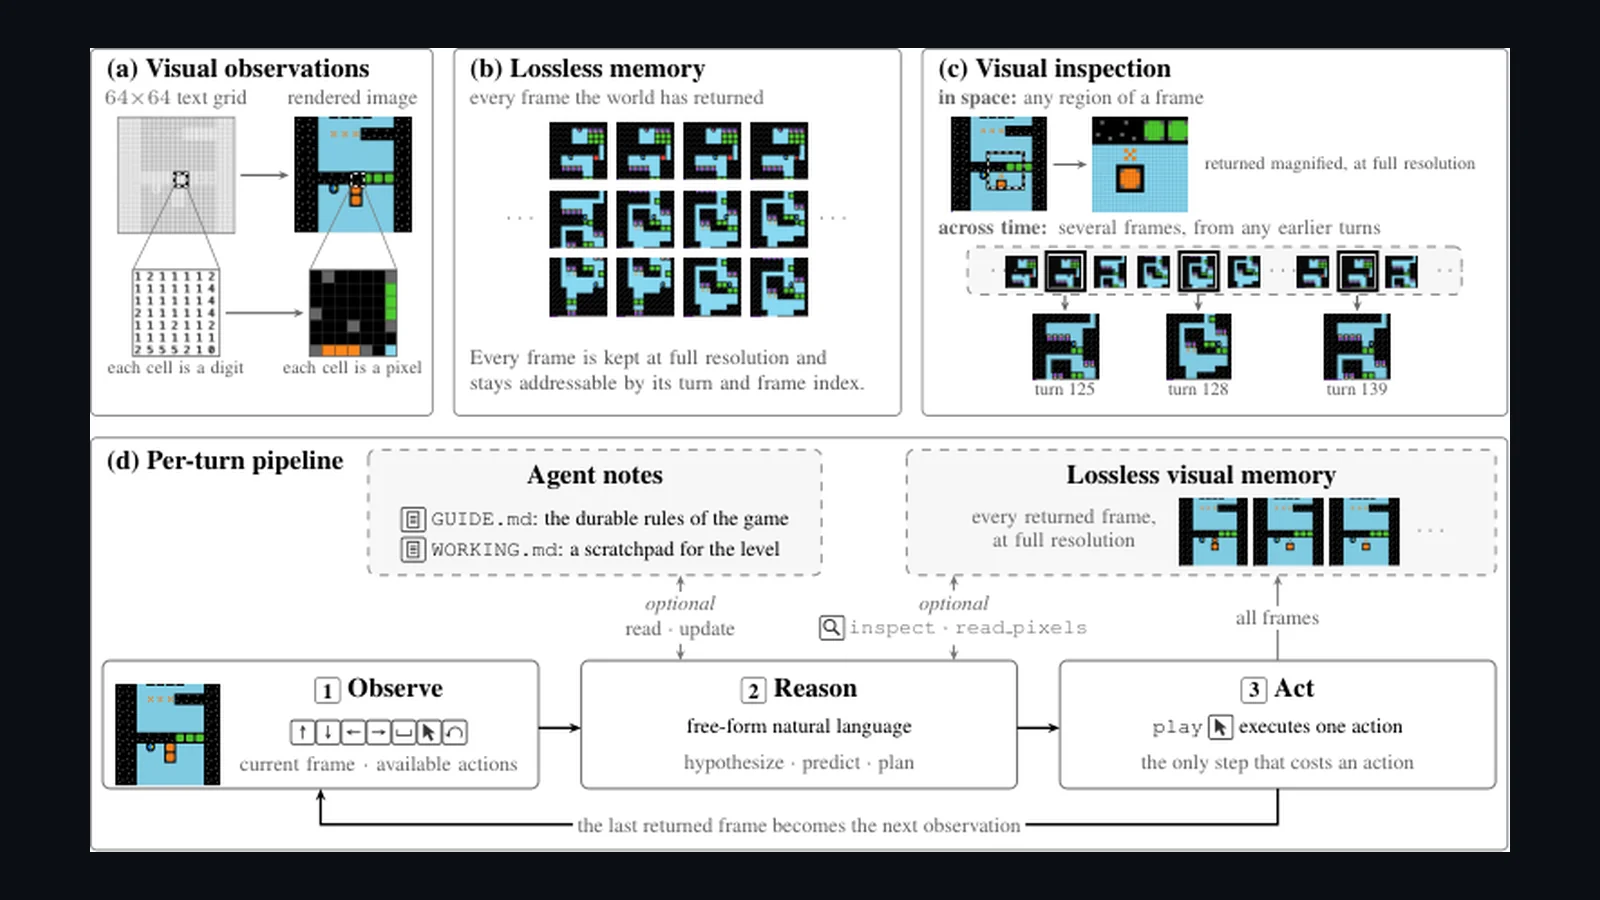
- Ledakan Token Konteks yang Ekstrem (Token Bloat): Representasi grid teks untuk resolusi 64×64 piksel mengonsumsi hingga ~4.000 token teks per frame. Sebaliknya, observasi visual 2D yang dirender langsung sebagai gambar hanya membutuhkan sekitar 308 image token. Penggunaan grid teks menghabiskan 13x lipat jatah konteks tanpa memberikan informasi tambahan.
- Kehancuran Inductive Priors Spasial: Model visi-bahasa (VLM) modern dilatih pada miliaran gambar alami dengan prior spasial mendalam (kontiguitas bentuk, oklusi, simetri refleksi, dan gravitasi). Ketika gambar diubah menjadi larik angka teks, model kehilangan konektivitas topologis 2D dan terpaksa memproses hubungan spasial melalui tokenisasi sekuensial 1D yang rentan delusi.
- Bottleneck Sintesis Program pada Lingkungan Non-Deterministik: Sintesis program sangat rapuh ketika aturan game berubah secara progresif antar-level. Jika DSL yang dirumuskan agen salah menangkap satu kondisi cabang kecil, seluruh simulator runtuh dan menghasilkan infinite loop atau crash runtime.
2. Anatomi Tiga Komponen Utama Visual Harness VISTA
VISTA membalikkan paradigma: alih-alih memaksa model menulis kode simulator, VISTA menyediakan harness mekanis murni yang memberikan long-horizon vision kepada model fondasi. Tiga pilar arsitektur VISTA terdiri dari:
Visual Observations
Agen menerima observasi lingkungan langsung dalam bentuk citra PNG terender (512×512 piksel via nearest-neighbor upscaling). Citra mempertahankan bentuk objek, hubungan topologis, simetri, dan warna asli, memungkinkan model mengerahkan prior visual multimodal bawaannya.
Lossless Visual Memory
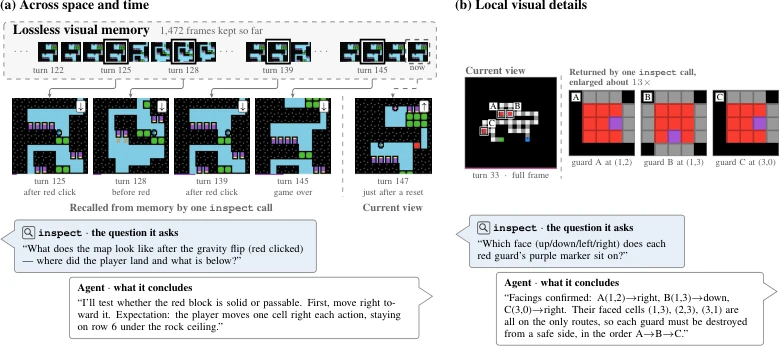
Harness menyimpan setiap frame yang dihasilkan lingkungan dalam bentuk aslinya tanpa kompresi kehilangan (lossless), termasuk intermediate animation frames saat sebuah aksi memicu pergerakan bertahap. Seluruh frame diindeks berdasarkan nomor turn dan nomor frame.
Visual Inspection
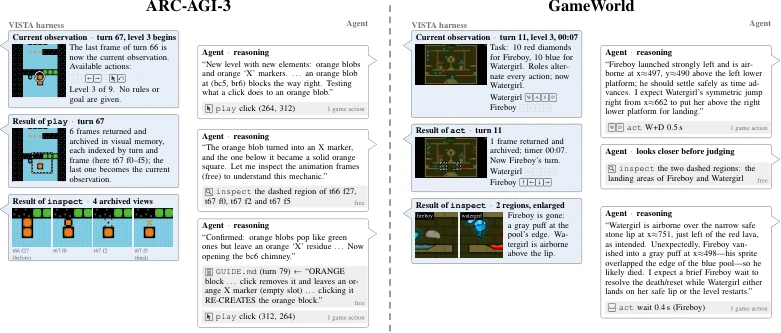
Agen dibekali mekanisme atensi eksplisit melalui tool interaktif: Spatial Inspection (meminta crop zoom pada koordinat persegi panjang tertentu) dan Temporal Inspection (merekonstruksi replay transisi animasi dari turn masa lalu).
read_pixels.
Lossless Memory Subsystem
3. Sistem Dual-Notes (GUIDE.md & WORKING.md) dan Kompaksi Konteks Seamless
Dalam tugas interaktif berhorizon panjang (ratusan hingga ribuan langkah), jendela konteks model (200K token) pasti akan penuh. VISTA memisahkan memori kognitif agen menjadi dua level abstraksi terstruktur:
GUIDE.md (Durable Invariants)
Menyimpan pengetahuan permanen mengenai mekanisme dunia: aturan permainan, fungsi tombol/warna, hukum fisika yang telah diverifikasi, dan hipotesis tingkat tinggi yang tetap berlaku lintas level. File ini dipertahankan sepanjang seluruh sesi game.
WORKING.md (Volatile Scratchpad)
Menyimpan status temporer, pelacakan koordinat target saat ini, rencana sub-langkah terdekat, dan catatan uji coba level berjalan. Dikosongkan (reset) ketika level berhasil diselesaikan, namun dipertahankan saat terjadi perintah RESET level.
Ketika konteks mendekati ambang batas limit, controller VISTA mengeksekusi save_compact_checkpoint: agen menulis ringkasan handoff terpadat ke dalam WORKING.md dan GUIDE.md, lalu melanjutkan interaksi pada context window yang bersih dan segar. Seluruh visual memory (frame masa lalu) tetap utuh di sisi host dan dapat diakses kembali sewaktu-waktu oleh agen.
4. Evaluasi Empiris ARC-AGI-3 & Analisis Tangga Ablasi (Ablation Ladder)
Kinerja agen diukur menggunakan metrik resmi Relative Human Action Efficiency (RHAE):
Di mana h_{\ell,g} adalah jumlah aksi pemain manusia pemula dan a_{\ell,g} adalah jumlah aksi agen. VISTA dengan Claude Opus 5.0 mencapai skor RHAE 100.00 sempurna, menyelesaikan seluruh 25 game ARC-AGI-3 dengan hanya 7.302 aksi dibandingkan 17.135 aksi manusia (efisiensi 57.4% lebih hemat).
| Konfigurasi Harness VISTA | Observasi | Visual Memory | RHAE Score | Total Aksi |
|---|---|---|---|---|
| (0) Official Baseline | Text Grid | Tidak Ada | 13.33 | 10.619 |
| (i) Pure PNG Image | 2D PNG | Tidak Ada | 47.32 | 2.435 |
| (ii) Extended Limits | 2D PNG | Tidak Ada | 51.66 | 4.218 |
| (iii) Native Compaction | 2D PNG | Tidak Ada | 65.82 | 8.120 |
| (iv) Dual Notes (GUIDE/WORKING) | 2D PNG | Tidak Ada | 70.05 | 8.940 |
| (v) Lossless Visual Memory + Inspect | 2D PNG | Lossless Raw | 94.10 | 8.410 |
| (vi) Full VISTA (+ read_pixels) | 2D PNG | Lossless + Pixel API | 99.00 / 100.00 | 7.302 |
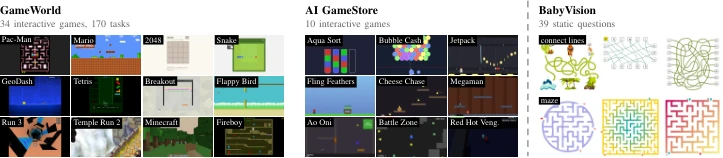
5. Generalisasi Luar Biasa: GameWorld, AI GameStore, dan BabyVision
Kelebihan utama VISTA terletak pada sifatnya yang task-agnostic. Tanpa modifikasi arsitektur internal atau re-tuning model, VISTA diuji pada tiga tolok ukur heterogen:
- GameWorld (34 Browser Games, 170 Tasks): Melalui antarmuka computer-use (keyboard & mouse), VISTA mencatat tingkat keberhasilan (Success Rate) yang secara signifikan melampaui human baseline pemula pada berbagai genre (arcade, platformer, puzzle, runner).
- AI GameStore (10 Permainan Browser Interaktif): VISTA mencapai skor rata-rata geometrik dinormalisasi 142.8 (di mana median manusia = 100), membuktikan kemampuan inferensi dinamika fisika lingkungan yang superior.
- BabyVision (Tolok Ukur Penalaran Visual Statis): Pada 39 tugas penelusuran visual kompleks (maze navigation & line tracking), penambahan alat inspeksi visual VISTA mendongkrak akurasi dari 41.0% (baseline resmi) menjadi 63.2% murni berkat kemampuan zoom-in dan pemeriksaan pixel-level lokal.
6. Implikasi Arsitektural: Menuju Era Harness-Centric Multimodal Intelligence
Penelitian VISTA oleh Kaiming He dan tim MIT CSAIL mengirimkan pesan fundamental bagi industri kecerdasan buatan: kegagalan model multimodal pada tugas-tugas penalaran kompleks sering kali bukan disebabkan oleh kelemahan representasi latent model, melainkan oleh kecacatan antarmuka (harness) yang membungkusnya.
Ketika kita membuang observasi visual mentah dan hanya mengandalkan rangkuman teks, kita secara sengaja melumpuhkan kemampuan spasial model. Dengan menyediakan lossless visual memory yang dapat diinspeksi secara dinamis sesuai kebutuhan penalaran, model fondasi yang ada saat ini sudah mampu memecahkan masalah kecerdasan visual tingkat tinggi dengan efisiensi yang melampaui rata-rata manusia.
Referensi & Sumber Terverifikasi
- [1]VISTA: A Visual Harness for Reasoning in an Interactive World(arXiv:2610.02200v1 [cs.AI / cs.CV] — Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Kaiming He (MIT CSAIL))
- [2]On the Measure of Intelligence & ARC-AGI-3 Benchmark Specification(arXiv:1911.01547 / ARC Prize Foundation — François Chollet et al.)
- [3]GameWorld: A Benchmark for Autonomous Game-Playing Agents(NeurIPS / arXiv:2506.11029 — Shi et al.)
- [4]AI GameStore: Evaluating Multimodal LLM Agents in Interactive Environments(ICLR / arXiv:2510.08912 — Wang et al.)
- [5]BabyVision: Evaluating Visual Tracking and Spatial Reasoning in Static Multimodal Benchmarks(arXiv:2603.14920 — Chen et al.)
- [6]MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution(arXiv:2609.38349 — Prithwish Jana, Kaiming He et al., AWS AI Labs & Georgia Tech)
- [7]VISTA: A Visual Harness for Reasoning in an Interactive World(arXiv:2610.02200v1 [cs.AI / cs.CV] — Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Kaiming He (MIT CSAIL))
- [8]On the Measure of Intelligence & ARC-AGI-3 Benchmark Specification(arXiv:1911.01547 / ARC Prize Foundation — François Chollet et al.)
- [9]GameWorld: A Benchmark for Autonomous Game-Playing Agents(NeurIPS / arXiv:2506.11029 — Shi et al.)
- [10]AI GameStore: Evaluating Multimodal LLM Agents in Interactive Environments(ICLR / arXiv:2510.08912 — Wang et al.)
- [11]BabyVision: Evaluating Visual Tracking and Spatial Reasoning in Static Multimodal Benchmarks(arXiv:2603.14920 — Chen et al.)
- [12]MILO: Automated Harness Discovery via Orchestrated Multi-Agent Evolution(arXiv:2609.38349 — Prithwish Jana, Kaiming He et al., AWS AI Labs & Georgia Tech)
Butuh Arsitektur Web & AI Berkualitas Tinggi?
Tim engineering NEWSAINT siap membantu merancang website berkecepatan tinggi, sistem AI autonomous, dan solusi SaaS terukur untuk bisnis Anda.
Artikel Terkait Lainnya

HyperBrowseComp 2026: Benchmark Multilingual & Multimodal Stress Test untuk Autonomous Web-Browsing Agents, Evaluasi 13 Bahasa, dan Analisis Bottleneck Retrieval Harness
Analisis arsitektur sistem frontier riset evaluasi autonomous browsing agent (arXiv:2610.03574, Oktober 2026 — Alham Fikri Aji, Faiz Rizki Ramadhan, Zayd M. K. Zuhri, Seung Hun Eddie Han, Ryandito Diandaru, dkk. MBZUAI, Mila, Inception AI, Alibaba, AI Singapore): Mengapa tolok ukur browsing konvensional (GAIA, BrowseComp) mengalami saturasi parametrik dan bias monolingual. Memperkenalkan HyperBrowseComp, stress test 423 kueri faktual bernilai tunggal lintas 13 bahasa (termasuk Bahasa Indonesia 9.2% dan Jawa 8.3%) dan 8 modalitas (Video 39%, PDF/OCR 29.8%, Aritmetika 28.1%, Gambar 18.4%, Peta 9.7%). Evaluasi empiris 5 model frontier (Gemini 3.7 Flash, Gemini 3.1 Pro, GPT-5.6 Sol/Terra/Luna) lintas 3 harness retrieval (Provider Built-in, Exa Search API, OWL Browser Harness) mengungkap fenomena Harness Inversion (Exa mendongkrak GPT-5.6 Sol +7.56% namun mendegradasi Gemini 3.7 Flash -9.46%), 93 kegagalan fatal runtime tool-calling pada OWL, serta 57.68% pertanyaan tanpa solusi (shared failure) pada seluruh model frontier.

VenusRL 2026: Arsitektur Disaggregated Agentic RL dengan Priority-Aware Scheduling, Akselerasi Training 4.24x, dan Pangkas 89% Biaya Sandbox
Analisis arsitektur sistem frontier riset Agentic RL (arXiv:2610.03286, Mingjun Zhang, Yucheng Li, Menghao Zhang, Shuyong Zhu, Ping Zhang — Oktober 2026): Mengapa sistem pelatihan RL agen multi-turn konvensional (Slime, RollFlash) mengalami bottleneck sistemik fatal akibat barrier penyelesaian grup GRPO/PPO dan alokasi statis memori sandbox microVM. Memperkenalkan VenusRL, sistem agentic RL terdisagregasi penuh pertama yang memadukan Priority-Aware Action Scheduler dan Environment Resource Manager. Melalui heuristik prediksi panjang lintasan, Trajectory-Aware Radix Cache, alokasi memori dinamis adaptif, serta intra-group page sharing berbasis aliasing page table entry (PTE) dan copy-on-write, VenusRL meraih akselerasi training throughput hingga 4.24x, meningkatkan densitas sandbox per node hingga 905% (dari 100 ke 905 sandbox pada node 400GB), dan memangkas biaya infrastruktur non-GPU hingga 89% pada pengujian kluster 32 GPU Hopper dengan Qwen3-32B di SWE-agent OpenSWE.

ActKV 2026: Arsitektur Action-Guided KV Cache Management pada Agentic LLM Inference, Pangkas 74% Memori dengan 98.5% Akurasi, dan Akselerasi Throughput hingga 3.97x
Analisis mendalam arsitektur sistem operasi frontier agent inference (arXiv:2609.31395, University of Science and Technology of China - USTC): Mengapa kompresi KV cache konvensional (StreamingLLM, SnapKV, R-KV) gagal total pada agen otonom karena menyamaratakan seluruh token. Memperkenalkan ActKV, framework kompresi KV cache pertama yang dirancang khusus untuk agentic LLM inference. Melalui tiga inovasi arsitektural—Action-Oriented Eviction berbasis attention-aware LRFU, Confidence-Driven Adaptive Budget Allocation berbasis sinyal intrinsik LLM & trend detection, serta Page-Aware In-Place Compaction Kernel tanpa alokasi workspace ekstra—ActKV mempertahankan 98.53% akurasi FullKV dengan hanya 25.98% peak memory, serta melejitkan token throughput hingga 3.97x dan task throughput hingga 3.58x pada model Qwen3-30B, Qwen3-235B, GPT-OSS-20B, dan GPT-OSS-120B.